Histoire de l’intelligence artificielle : de Turing à ChatGPT
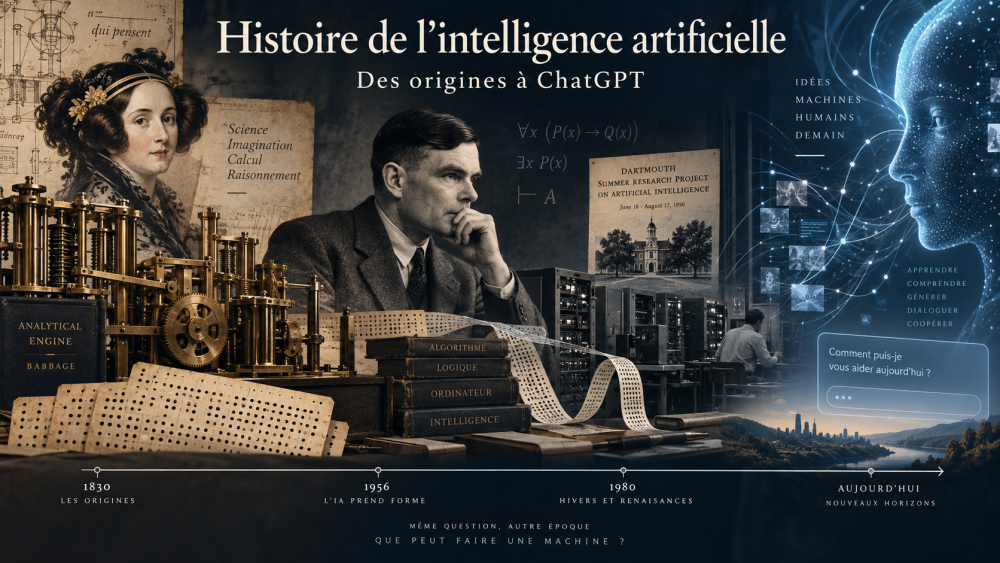
L’intelligence artificielle semble avoir surgi brutalement dans notre quotidien à la fin de 2022, lorsque ChatGPT fait découvrir au grand public les possibilités des grands modèles de langage. Pourtant, lorsque ces outils deviennent visibles de tous, l’IA possède déjà près de quatre-vingts ans d’histoire scientifique — et environ soixante-dix ans sous son nom actuel.
ChatGPT joue un rôle de déclencheur, mais il s’inscrit rapidement dans un paysage beaucoup plus large où apparaissent ou se développent Claude, Gemini, Llama, les modèles de Mistral AI et, en Chine, des acteurs comme DeepSeek.
Depuis les premiers neurones artificiels des années 1940 jusqu’aux grands modèles génératifs, chercheurs et ingénieurs ont exploré des voies parfois très différentes : programmer le raisonnement, reproduire l’expertise humaine, apprendre à partir d’exemples, représenter l’incertitude ou entraîner d’immenses réseaux neuronaux sur de très grandes quantités de données.
Cette histoire n’est pas une marche régulière conduisant inévitablement à ChatGPT. Elle est faite d’idées concurrentes, de succès spectaculaires, de promesses excessives, d’échecs, de périodes de désillusion et de méthodes anciennes qui retrouvent une nouvelle importance plusieurs décennies plus tard. Les témoignages de Marvin Minsky, Edward Feigenbaum, John Hopfield, Ilya Sutskever, Leslie Kaelbling, Jitendra Malik, David Silver, Garry Kasparov, Stuart Russell ou Moustapha Cissé permettent aussi de la raconter comme une aventure humaine.
Sommaire
- Avant l’IA : peut-on mécaniser le raisonnement ?
- Alan Turing et les machines qui apprennent
- Les premiers neurones artificiels
- Dartmouth et la naissance de l’intelligence artificielle
- IA symbolique, Lisp et perceptron
- DENDRAL, ELIZA, Shakey et les années 1960
- Systèmes experts et hivers de l’IA
- Le retour des réseaux neuronaux et du machine learning
- Données, GPU et essor du deep learning
- Deep Blue et AlphaGo
- Transformer, GPT et modèles de langage
- ChatGPT et l’IA contemporaine
- Ce que l’histoire de l’IA nous apprend
Les grandes étapes
| Date | Étape |
|---|---|
| 1943 | McCulloch et Pitts proposent un premier modèle mathématique du neurone artificiel. |
| 1950 | Alan Turing publie Computing Machinery and Intelligence et imagine le futur test de Turing. |
| 1956 | La conférence de Dartmouth contribue à faire de l’intelligence artificielle un domaine de recherche à part entière. |
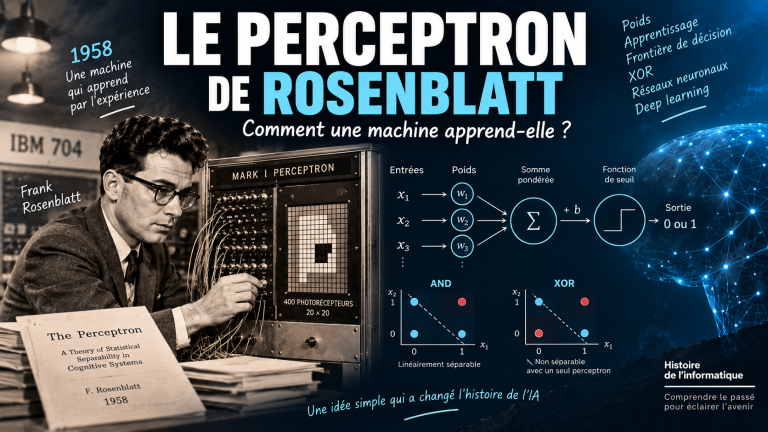
| 1958 | Le perceptron de Frank Rosenblatt ouvre la voie aux réseaux de neurones capables d’apprendre. |
| Années 1970-1980 | Les systèmes experts se développent, tandis que les limites techniques provoquent aussi les premiers hivers de l’IA. |
| 1997 | Deep Blue bat Garry Kasparov aux échecs. |
| 2012 | AlexNet marque l’essor du deep learning, porté par les GPU et de grandes quantités de données. |
| 2017-2022 | L’architecture Transformer ouvre la voie aux grands modèles de langage, jusqu’à la popularisation de l’IA générative avec ChatGPT. |
Avant l’IA : peut-on mécaniser le raisonnement ?
L’idée qu’un raisonnement puisse obéir à des règles est bien antérieure à l’ordinateur. Dès l’Antiquité, Aristote étudie avec le syllogisme comment certaines conclusions peuvent être déduites logiquement à partir de prémisses.
Au XVIIe siècle, Gottfried Wilhelm Leibniz imagine d’aller plus loin : représenter les idées par des symboles et transformer certains raisonnements en calculs. Son projet reste largement théorique, mais il annonce une question centrale de l’informatique : peut-on formaliser suffisamment le raisonnement pour qu’une machine puisse l’exécuter ?
Au XIXe siècle, Charles Babbage imagine sa machine analytique, une machine programmable capable d’exécuter différentes opérations selon les instructions qu’on lui fournit.
En 1843, Ada Lovelace comprend que cette machine pourrait manipuler autre chose que des nombres si l’information était représentée sous une forme symbolique. Elle évoque notamment la musique. Lovelace reste pourtant prudente : la machine, estime-t-elle, ne produit rien par elle-même et ne fait qu’exécuter ce que les humains savent lui prescrire. Alan Turing reprendra plus tard cet argument sous le nom de Lady Lovelace’s objection.
À la même époque, automates, recherches sur le vivant et œuvres comme Frankenstein de Mary Shelley nourrissent aussi l’imaginaire d’une création artificielle capable d’imiter l’être humain.

George Boole franchit ensuite une étape décisive. En 1847 puis en 1854, il montre que certaines opérations du raisonnement logique peuvent être représentées par un formalisme mathématique.
D’Aristote à Boole, plusieurs idées essentielles se rejoignent progressivement : formaliser le raisonnement, représenter l’information par des symboles et faire exécuter des règles par une machine. Il reste encore à déterminer ce qu’une machine peut réellement calculer : ce sera l’une des grandes questions d’Alan Turing.
Alan Turing : du calcul aux machines qui apprennent
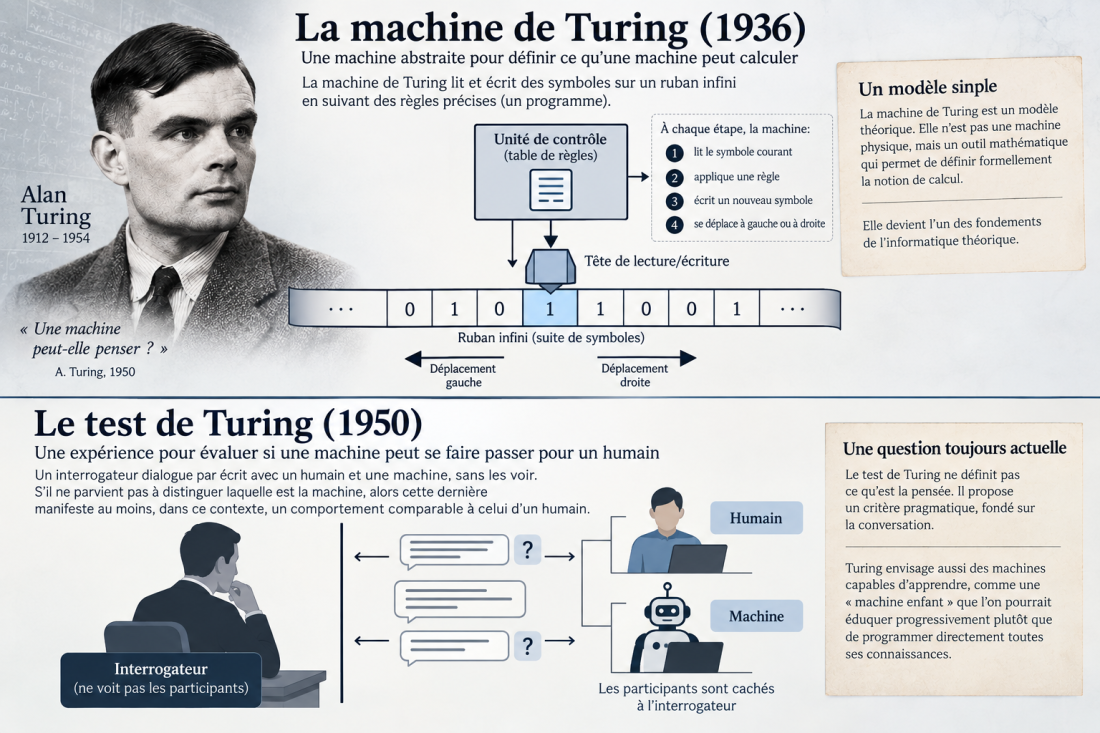
En 1936, Alan Turing publie un article fondamental sur la notion de calcul. Il imagine une machine abstraite capable de lire et d’écrire des symboles sur un ruban en suivant des règles précises. La « machine de Turing » devient l’un des fondements de l’informatique théorique. Son objectif n’est pas encore de fabriquer une intelligence artificielle, mais de définir ce qu’une procédure mécanique peut calculer.
Après la Seconde Guerre mondiale, Turing s’intéresse beaucoup plus directement aux machines intelligentes. Il participe également à la conception de l’ACE, dont une version simplifiée donnera naissance au Pilot ACE.
En 1950, il publie Computing Machinery and Intelligence. Plutôt que de commencer par une définition impossible à stabiliser du verbe «penser», il propose un jeu d’imitation : un interrogateur dialogue par écrit avec un humain et une machine sans les voir. Si l’interrogateur ne parvient pas à les distinguer de manière fiable, la machine manifeste, dans cette situation précise, un comportement comparable à celui d’un humain.
Cette expérience deviendra le test de Turing. L’article va cependant plus loin que ce test souvent résumé trop rapidement. Turing envisage des machines capables d’apprendre et imagine une « machine enfant » que l’on pourrait éduquer progressivement au lieu d’essayer de programmer directement l’esprit adulte.
1943-1949 : les premiers neurones artificiels
Une autre voie apparaît dès 1943. Warren McCulloch et Walter Pitts proposent un modèle mathématique très simplifié du neurone biologique. Plusieurs de ces unités peuvent être assemblées pour réaliser certaines opérations logiques. Le modèle est encore très éloigné du fonctionnement réel du cerveau, mais il ouvre une piste décisive : obtenir des comportements complexes à partir d’un ensemble d’unités simples.
Cette publication marque directement la génération suivante. Marvin Minsky racontait avoir découvert, étudiant à Harvard à la fin des années 1940, un chapitre consacré aux réseaux neuronaux de McCulloch et Pitts dans un volumineux ouvrage de biophysique mathématique. Il y entrevoit une manière possible de représenter de l’information ou des connaissances avec de simples unités connectées. Ce souvenir montre comment des travaux situés entre logique, physiologie et mathématiques ont contribué à faire naître un nouveau champ. 1
En 1949, le psychologue Donald Hebb propose un principe d’apprentissage selon lequel les connexions entre neurones peuvent se renforcer lorsqu’ils sont activés ensemble. Cette idée, connue sous le nom d’apprentissage hebbien, influencera durablement les recherches sur les réseaux neuronaux.
Deux grandes familles commencent alors à se dessiner : représenter explicitement des règles et des connaissances, ou faire apprendre la machine à partir d’exemples. L’histoire les opposera souvent, mais aucune ne disparaîtra complètement. Les systèmes contemporains continuent même parfois à les combiner.
1955-1956 : un domaine reçoit un nom
L’année 1956 est souvent présentée comme la naissance officielle de l’intelligence artificielle. L’expression Artificial Intelligence apparaît en réalité dès 1955 dans une proposition rédigée par John McCarthy, Marvin Minsky, Nathaniel Rochester et Claude Shannon. Ils préparent une rencontre qui doit se tenir l’été suivant au Dartmouth College.
Le projet est ambitieux : étudier comment une machine pourrait utiliser le langage, former des abstractions et des concepts, résoudre des problèmes jusque-là réservés aux humains et améliorer son propre fonctionnement. La rencontre ne produit ni théorie unique ni programme commun. Elle rassemble plutôt des chercheurs qui n’emploient pas encore les mêmes méthodes, mais reconnaissent un même territoire scientifique.
Edward Feigenbaum rappelle que Logic Theorist, développé par Allen Newell, Herbert Simon et Cliff Shaw, fonctionnait déjà avant l’atelier et y fut présenté. Le programme avait été écrit dans IPL, l’un des premiers langages consacrés au traitement de listes. L’IA ne naît donc pas d’un discours abstrait à Dartmouth : des programmes capables d’explorer des preuves existent déjà. 2
Ce que Dartmouth change réellement
La rencontre ne donne pas soudainement naissance à toutes les idées de l’IA. Elle leur fournit un nom commun, un réseau de chercheurs et un programme de recherche identifiable.
Faire raisonner un ordinateur
Logic Theorist parvient à démontrer plusieurs théorèmes des Principia Mathematica de Bertrand Russell et Alfred North Whitehead. Son intérêt vient surtout de sa méthode. Plutôt que d’examiner systématiquement toutes les possibilités, il utilise des heuristiques, c’est-à-dire des règles qui privilégient les pistes paraissant les plus prometteuses.
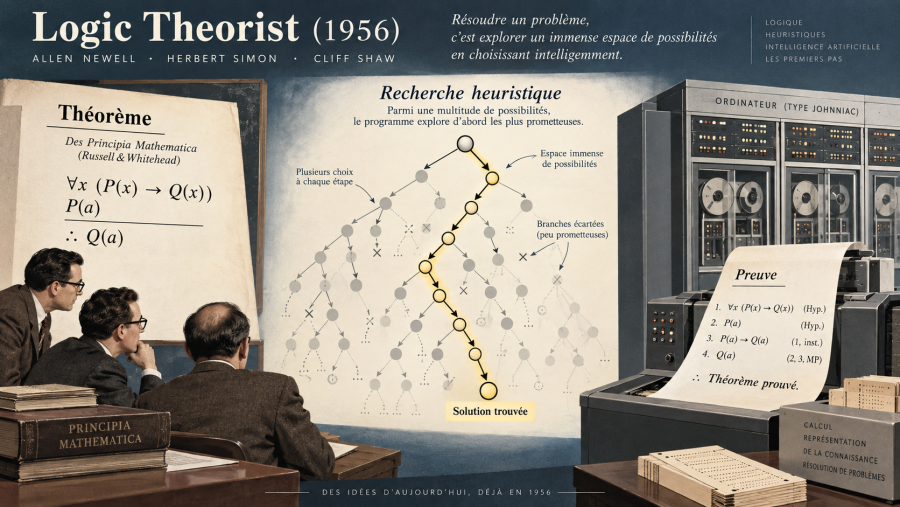
Feigenbaum décrit Logic Theorist comme la « plateforme de lancement » du courant de la programmation heuristique qui dominera une partie de l’IA pendant près de vingt ans. Il raconte aussi le choc personnel provoqué par son premier contact avec l’informatique : n’ayant encore jamais vu d’ordinateur, il lit toute une nuit un manuel de machine et sait, au matin, ce qu’il veut faire de sa vie. 3
L’épisode rappelle un aspect souvent effacé des chronologies : l’IA naissante se construit sur des machines rares, difficiles d’accès, et sur des langages qu’il faut encore inventer.
Lisp : donner aux programmes la capacité de manipuler des programmes
À la fin des années 1950, John McCarthy développe Lisp au MIT. Le langage est particulièrement adapté à la manipulation de symboles et de listes. Un programme Lisp peut représenter des expressions et même d’autres programmes sous forme de structures qu’il devient possible d’examiner ou de modifier.
Interrogé sur le progrès technique qui avait le plus ouvert les possibilités de l’IA à ses débuts, Marvin Minsky répondait précisément : l’invention de Lisp. Sa remarque aide à comprendre pourquoi un langage peut jouer un rôle historique comparable à celui d’une machine : il ne fournit pas seulement plus de vitesse, il permet de formuler autrement les problèmes. 4
Les machines du MIT, notamment les PDP-6 puis le PDP-10, accueillent une grande partie de ces expérimentations. Des programmeurs comme Richard Greenblatt contribuent ensuite à MacLisp, aux programmes d’échecs et aux Lisp machines spécialement conçues pour l’IA.
Le perceptron apprend à reconnaître
À la même période, Frank Rosenblatt explore une approche différente avec le perceptron. À la fin des années 1950, ses expériences montrent qu’un système peut apprendre à reconnaître certaines formes en modifiant progressivement ses paramètres. Dans un programme traditionnel, le développeur écrit directement les règles ; avec le perceptron, une partie de ces règles est apprise à partir d’exemples.
L’enthousiasme est fort et les annonces publiques parfois démesurées. Les perceptrons à une seule couche possèdent pourtant des limites importantes, analysées notamment par Marvin Minsky et Seymour Papert en 1969. Leur livre n’explique pas, à lui seul, le recul ultérieur des réseaux neuronaux. Les méthodes d’entraînement sont encore limitées, les données rares, les machines lentes et les financements évoluent.
Les réseaux neuronaux perdent alors une partie de leur visibilité sans disparaître. Cette nuance compte : les « retours » de l’IA sont souvent le résultat de communautés qui ont continué à travailler pendant que l’attention et les budgets se déplaçaient ailleurs.
Les années 1960 : plusieurs visions de l’intelligence
Les années 1960 montrent rapidement qu’il n’existe pas une seule façon de construire une intelligence artificielle.
DENDRAL : la connaissance devient centrale
À partir de 1965, le projet DENDRAL, développé à Stanford autour d’Edward Feigenbaum, Joshua Lederberg et leurs collaborateurs, aide à identifier des structures moléculaires. Le projet révèle qu’un programme général ne suffit pas : pour résoudre un problème scientifique difficile, il faut intégrer une grande quantité de connaissances du domaine.
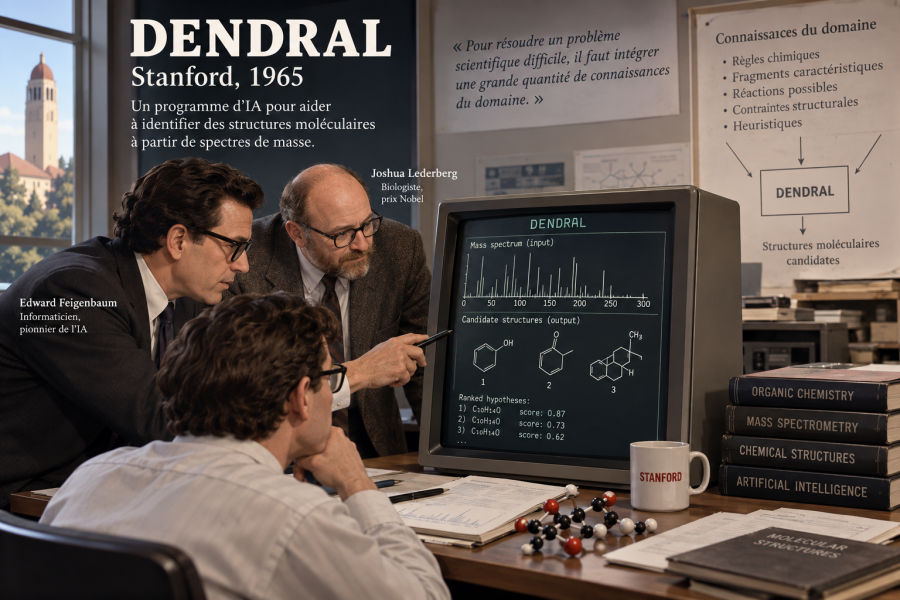
Feigenbaum se souvient que son équipe devait extraire cette connaissance de la tête des chimistes. Elle inventait, selon ses mots, l’« ingénierie des connaissances » en avançant. Cette expérience transforme la conception de l’IA : la puissance ne dépend plus seulement de l’algorithme de recherche, mais aussi de la qualité des connaissances disponibles. 5
ELIZA : l’illusion de la compréhension
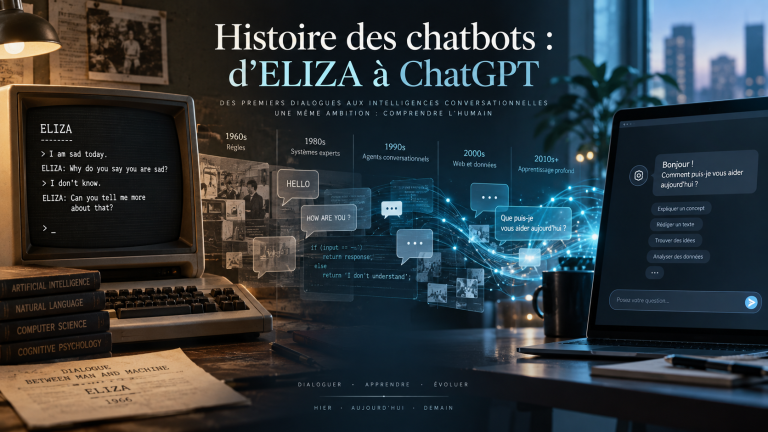
En 1966, Joseph Weizenbaum présente ELIZA, un programme capable de simuler une conversation textuelle. Sa version la plus célèbre, DOCTOR, imite un psychothérapeute en repérant certaines structures dans les phrases et en appliquant des règles de transformation.
ELIZA ne comprend pas réellement la conversation. Pourtant, des utilisateurs lui attribuent déjà une écoute et des intentions. Weizenbaum sera profondément marqué par cet attachement à un programme aussi simple et consacrera une partie de sa vie à mettre en garde contre la confusion entre imitation du langage et compréhension. L’« effet ELIZA » précède ainsi de plus d’un demi-siècle les débats provoqués par les assistants conversationnels modernes. 6
Shakey : percevoir, planifier et agir
Au Stanford Research Institute, le robot Shakey explore une troisième voie. Entre 1966 et 1972, il combine perception, représentation de son environnement, planification et déplacement.
Des décennies plus tard, la roboticienne Leslie Kaelbling raconte avoir trouvé un successeur de Shakey dans un laboratoire du SRI, tandis que l’ancien robot reposait dans un coin de bureau en laissant couler du liquide hydraulique dans un bac. L’image est savoureuse, mais elle souligne surtout la fécondité du projet : vision, planification symbolique, recherche A* et représentation de l’espace se trouvaient déjà réunies dans une même machine. 7
La vision artificielle et « l’erreur du premier succès »
En 1966, le Summer Vision Project du MIT propose à des étudiants de faire accomplir en un été à un ordinateur une série de tâches de vision. Plusieurs de ces tâches restent des sujets de recherche des décennies plus tard.
Jitendra Malik explique cette sous-estimation par le caractère inconscient de la vision humaine : parce que voir nous paraît sans effort, nous imaginons facilement que le problème est simple. Il appelle cela « l’erreur du premier succès » : atteindre rapidement 50 % peut donner l’impression que 99 % est proche, alors que les derniers pourcentages peuvent demander des années. 8
Les premières désillusions
Les succès initiaux entraînent beaucoup d’optimisme, mais les chercheurs découvrent rapidement les limites de leurs programmes. Un système peut fonctionner dans un petit environnement puis s’effondrer lorsque le nombre de possibilités ou de situations inattendues augmente. Les ordinateurs disposent aussi de très peu de mémoire et de puissance de calcul par rapport aux machines actuelles.
La traduction automatique, la vision et la résolution générale de problèmes se révèlent beaucoup plus difficiles que prévu. Au Royaume-Uni, le rapport Lighthill de 1973 critique fortement une partie des recherches en IA. Aux États-Unis, plusieurs programmes voient aussi leurs financements réduits ou réorientés.
Cette période est aujourd’hui souvent appelée le premier « hiver de l’IA ». L’expression demande toutefois une nuance. Stuart Russell rappelle que la période de la fin des années 1980 est la première à avoir été couramment désignée ainsi à l’époque ; le recul des années 1970 a ensuite été intégré rétrospectivement au récit des hivers de l’IA. Dans les deux cas, la recherche ne s’arrête jamais complètement. 9
L’âge des systèmes experts
Dans les années 1970 puis surtout dans les années 1980, les systèmes experts connaissent un développement important. Le principe consiste à enregistrer les connaissances d’un spécialiste sous forme de règles :
SI certaines conditions sont réunies, ALORS envisager telle hypothèse.
MYCIN, développé à Stanford, utilise ainsi plusieurs centaines de règles pour aider au diagnostic de certaines infections et suggérer des traitements. Ces systèmes obtiennent des résultats intéressants dans des domaines étroits, mais leur connaissance doit être recueillie, formalisée, vérifiée et maintenue manuellement. Ce « goulot d’étranglement de l’acquisition des connaissances » limite leur extension.
Le succès commercial est néanmoins réel pendant quelques années. Feigenbaum se souvient qu’au début des années 1980 des entreprises se créaient soudainement pour commercialiser ces logiciels. Un marché se développe aussi autour des Lisp machines, postes de travail spécialisés et coûteux.
Le Japon et le projet de cinquième génération
L’histoire ne se joue plus seulement dans les laboratoires américains. En 1982, le Japon lance le projet Fifth Generation Computer Systems, qui doit développer de nouvelles architectures et des machines fondées notamment sur la programmation logique. Le programme stimule une compétition internationale et pousse les États-Unis et l’Europe à soutenir leurs propres initiatives.
Le projet ne réalise pas toutes ses ambitions, mais son importance historique ne se réduit pas à un échec : il montre que l’IA devient un enjeu industriel et national. Jürgen Schmidhuber, qui commençait alors ses recherches, se souvient de l’influence exercée par cette focalisation japonaise sur la programmation logique, tandis que les réseaux neuronaux poursuivaient une trajectoire beaucoup moins visible. 10
Le deuxième hiver de l’IA
À la fin des années 1980, l’enthousiasme retombe. Les systèmes experts se révèlent coûteux à développer et fragiles face aux situations qui ne figurent pas dans leurs règles. Le matériel généraliste progresse rapidement et réduit l’intérêt économique des machines spécialisées.
Stuart Russell rappelle le poids très concret de cette économie : certaines stations Lisp coûtaient entre 50 000 et 100 000 dollars de l’époque, auxquels s’ajoutaient les consultants nécessaires pour maintenir les systèmes. Beaucoup d’entreprises ne voyaient pas le retour sur investissement promis. 11
Le marché des Lisp machines s’effondre et plusieurs entreprises disparaissent. On parle alors d’un deuxième hiver de l’intelligence artificielle. Pourtant, les statistiques, la reconnaissance de formes, l’apprentissage automatique et les réseaux neuronaux continuent de progresser, parfois sous des étiquettes moins chargées de promesses.
Melanie Mitchell se souvient qu’à sa sortie de doctorat, en 1990, on lui conseillait de ne pas inscrire « intelligence artificielle » sur son CV et de parler plutôt de « systèmes intelligents ». Une discipline peut donc poursuivre son travail tout en changeant temporairement de vocabulaire. 12
Le retour des réseaux neuronaux
En 1982, John Hopfield montre comment un réseau de neurones peut être compris comme un système dynamique possédant des états stables. Ces réseaux de Hopfield offrent un modèle simple de mémoire associative : une information partielle peut conduire le réseau à reconstruire un motif appris. Hopfield précisera plus tard que son modèle expliquait surtout comment une mémoire déjà acquise pouvait s’exprimer, et non comment tout apprentissage biologique fonctionne. 13
En 1986, David Rumelhart, Geoffrey Hinton et Ronald Williams contribuent à populariser la rétropropagation de l’erreur. Des formes antérieures de cette méthode existaient déjà, mais leur article montre clairement son intérêt pour l’apprentissage de représentations internes. Le réseau compare le résultat obtenu au résultat attendu, puis propage le signal d’erreur en sens inverse afin d’ajuster ses paramètres.
Dans le même temps, les approches probabilistes progressent. Les travaux de Judea Pearl sur les réseaux bayésiens permettent notamment aux machines de raisonner avec des informations incertaines. L’IA ne travaille donc plus uniquement avec des règles strictes : elle peut exploiter des probabilités et apprendre à partir de données.
Les LSTM : apprendre ce qu’il faut retenir
Les réseaux récurrents rencontrent cependant une difficulté : apprendre des dépendances éloignées dans une séquence. Les travaux de Sepp Hochreiter et Jürgen Schmidhuber conduisent en 1997 aux réseaux LSTM, dotés de mécanismes permettant de conserver certaines informations et d’en oublier d’autres.
Schmidhuber insiste sur le caractère collectif de cette histoire et cite Hochreiter, Felix Gers et Alex Graves. Les LSTM seront ensuite utilisés massivement pour la reconnaissance de la parole, la traduction et le traitement de séquences, avant que les Transformers ne prennent une place dominante. 14
Les années 1990 : apprendre à partir des données
Durant les années 1990, l’apprentissage automatique prend une place croissante. Les méthodes statistiques se développent et les programmes utilisent davantage de collections d’exemples pour la reconnaissance d’images, la parole ou la classification de documents.
Le rôle du programmeur évolue : il écrit toujours l’algorithme, mais il ne décrit plus nécessairement chacune des règles permettant de résoudre le problème. La machine apprend une partie de ces règles à partir des données.
En 1998, Yann LeCun et ses collaborateurs présentent notamment LeNet-5, un réseau convolutionnel capable de reconnaître des caractères manuscrits. Des systèmes apparentés sont déjà employés pour lire automatiquement des chèques.
Le deep learning ne naît donc pas en 2012. Ses principes, ses architectures et plusieurs de ses méthodes existent avant que les conditions matérielles et documentaires nécessaires soient réunies à grande échelle.
Données, GPU et changement d’échelle
À partir des années 2000, plusieurs évolutions se combinent :
- Internet fournit d’immenses quantités de textes et d’images ;
- des jeux de données standardisés permettent de comparer les méthodes ;
- les techniques d’apprentissage et les architectures progressent ;
- les processeurs graphiques, ou GPU, accélèrent de nombreux calculs parallèles ;
- la mémoire, le stockage et les infrastructures distribuées changent d’échelle.
En 2009 apparaît notamment ImageNet, une immense base d’images destinée à entraîner et comparer les systèmes de reconnaissance visuelle. En 2012, Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton présentent AlexNet. Le réseau, qui compte environ 60 millions de paramètres et exploite des GPU, domine nettement la compétition ImageNet.
Sutskever raconte ce basculement de l’intérieur. Vers 2010-2011, il acquiert la conviction que de grands réseaux profonds entraînés de bout en bout peuvent fonctionner, mais une inconnue demeure : dispose-t-on d’assez de calcul ? Lorsque Krizhevsky écrit des noyaux CUDA extrêmement rapides pour entraîner les réseaux convolutionnels, l’équipe décide de les appliquer à ImageNet. L’innovation ne tient donc pas à un élément magique, mais à la réunion d’une architecture, de données, de calcul et de la conviction qu’il faut les faire changer d’échelle ensemble. 15
L’impact est considérable. Les réseaux profonds deviennent progressivement dominants dans la vision artificielle, puis dans la reconnaissance vocale et le traitement du langage. La rupture de 2012 vient moins d’une invention entièrement nouvelle que d’un assemblage devenu enfin praticable.
Avant de poursuivre vers les modèles de langage, un autre fil de l’histoire de l’IA permet de mesurer cette transformation : celui des jeux.
Deep Blue et AlphaGo : deux victoires, deux méthodes
Les jeux servent depuis longtemps de laboratoire à l’intelligence artificielle. Au MIT, des pionniers comme Alan Kotok travaillent déjà sur les échecs informatiques au début des années 1960.
En 1997, le superordinateur Deep Blue d’IBM bat le champion du monde Garry Kasparov. Le système combine une recherche extrêmement rapide, des fonctions d’évaluation conçues avec des spécialistes et une importante puissance de calcul.

Kasparov raconte que la défaite fut physiquement douloureuse : ce n’était pas seulement son premier match perdu contre une machine, mais, selon son souvenir, le premier match qu’il perdait tout court. Avec le recul, il en tire pourtant une leçon moins spectaculaire et plus profonde. Une machine n’a pas besoin de « comprendre » les échecs comme un humain ; dans un système fermé, elle peut gagner en commettant moins d’erreurs et en restant plus régulière. 16
En 2016, AlphaGo, développé par DeepMind, bat Lee Sedol au jeu de Go. L’espace des positions est tellement vaste qu’une recherche classique exhaustive ne suffit pas. AlphaGo combine réseaux neuronaux, apprentissage à partir de parties humaines, autojeu et recherche arborescente de Monte-Carlo.
David Silver se souvient que le premier système de l’équipe reposait d’abord sur le deep learning sans recherche et atteignait déjà un niveau de maître amateur. Le projet fut ensuite renforcé jusqu’au match contre Fan Hui, puis jusqu’à celui contre Lee Sedol. Cette progression montre comment une expérience scientifique devient, en quelques mois, une démonstration historique. 17
Deep Blue et AlphaGo gagnent tous deux contre des champions humains, mais leurs architectures et leurs apprentissages diffèrent profondément. Une performance spectaculaire ne suffit donc pas à expliquer le fonctionnement d’un système, ni à établir qu’il possède une intelligence générale.
2017 : le Transformer
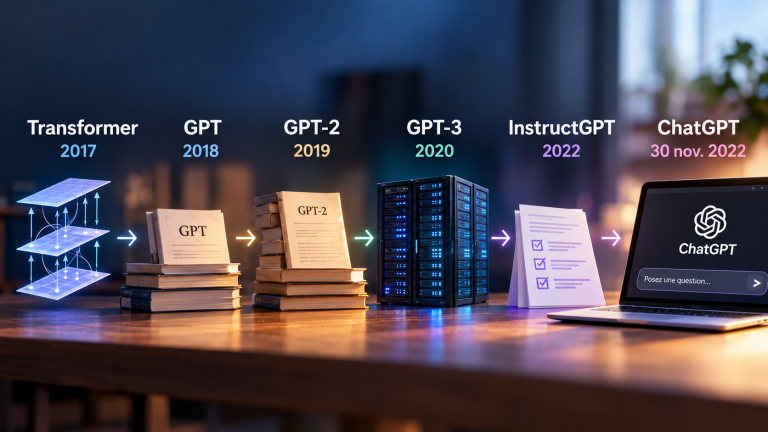
Une nouvelle étape est franchie en 2017 avec l’article Attention Is All You Need. Une équipe de chercheurs de Google présente une architecture de réseau neuronal : le Transformer.
Son mécanisme d’attention permet d’étudier les relations entre les éléments d’une séquence. Les systèmes de traitement du langage reposaient jusque-là largement sur des réseaux récurrents, notamment les RNN et les LSTM. Le Transformer réduit cette dépendance à la récurrence et permet de paralléliser beaucoup plus efficacement l’entraînement.
Ilya Sutskever invite à ne pas résumer cette réussite au seul mécanisme d’attention, déjà exploré auparavant. Il souligne la combinaison de plusieurs propriétés : l’attention, une architecture non récurrente plus facile à optimiser et une excellente adaptation aux GPU. Cette lecture prolonge une constante de l’histoire de l’IA : une idée devient révolutionnaire lorsqu’elle rencontre une architecture, du matériel et une méthode d’entraînement compatibles. 18
À l’origine, le Transformer est principalement expérimenté pour la traduction automatique. En 2018, BERT montre l’intérêt d’entraîner un grand modèle sur un immense corpus avant de l’adapter à différentes tâches. Google poursuit ses recherches sur la conversation avec Meena en 2020 puis LaMDA en 2021.
OpenAI suit une autre voie à partir de la même architecture. Dès 2018, le premier GPT combine Transformer et pré-entraînement génératif : le modèle apprend à prédire la suite probable d’un texte. GPT-2 puis GPT-3 augmentent fortement l’échelle. En 2020, GPT-3, avec 175 milliards de paramètres, montre qu’un même modèle peut réaliser de nombreuses tâches à partir d’exemples ou d’instructions formulées en langage courant.
Avant même ChatGPT, Sutskever explique pourquoi le simple objectif de prédire la suite d’un texte peut produire des représentations surprenantes : un petit modèle apprend d’abord des régularités de surface ; en grandissant, il doit saisir davantage de syntaxe, de sens et de faits pour améliorer ses prédictions. Il prend soin d’ajouter que ces signes ne constituent pas une compréhension complète. 19
Des modèles de langage aux assistants
Produire du texte n’est pas exactement la même chose que répondre correctement à une instruction. Une étape supplémentaire consiste donc à adapter les modèles pour qu’ils suivent mieux les demandes des utilisateurs.
Avec InstructGPT, OpenAI utilise notamment des démonstrations et des évaluations humaines. Des personnes classent différentes réponses ; ces préférences servent à entraîner un modèle de récompense, puis à orienter le comportement du système. Cette famille de méthodes est connue sous le nom de RLHF, pour Reinforcement Learning from Human Feedback.
Le RLHF ne donne pas au modèle une garantie de vérité. Il l’aide surtout à produire des réponses plus conformes aux consignes et aux préférences exprimées lors de l’entraînement. Cette distinction explique pourquoi un assistant peut être agréable et convaincant tout en commettant des erreurs.
2022 : ChatGPT change la perception de l’IA
Le 30 novembre 2022, OpenAI met ChatGPT à disposition du public. Les principaux composants existaient déjà : réseaux neuronaux, Transformer, pré-entraînement sur d’immenses corpus et méthodes d’adaptation aux instructions humaines.
La rupture tient aussi à l’usage. Pour accéder à ces capacités, il suffit désormais d’écrire une phrase dans une fenêtre de dialogue. Aucune connaissance particulière en informatique n’est nécessaire. L’utilisateur peut demander un résumé, une traduction, une explication, du code, puis poursuivre l’échange en conservant le contexte.
Pour le grand public, l’intelligence artificielle semble apparaître brutalement. Pour les chercheurs, ChatGPT rend visible à très grande échelle une accumulation de travaux, d’infrastructures et de choix techniques.
Une histoire mondiale, mais des modèles encore inégalement universels
Le récit classique de l’IA se concentre sur quelques laboratoires américains et britanniques. Cette histoire reste essentielle, mais elle ne suffit plus à décrire un domaine devenu mondial. Le Japon a joué un rôle majeur dans les années 1980 ; les laboratoires européens, canadiens et chinois ont profondément contribué à l’apprentissage automatique ; de nouveaux écosystèmes se développent aujourd’hui en Afrique, en Inde, au Moyen-Orient, au Brésil et en Asie du Sud-Est.
Le mathématicien sénégalais Moustapha Cissé résume l’enjeu : l’Afrique ne doit pas être seulement consommatrice de technologies conçues ailleurs, mais participer à leur création et les employer pour ses propres priorités. Son parcours — création d’un laboratoire de recherche et d’un master en IA sur le continent, puis développement d’applications de santé — montre que l’histoire actuelle de l’IA se construit aussi à Dakar et à Accra. 20
Pelonomi Moiloa souligne un autre angle mort : un modèle dit « multilingue » peut rester mauvais dans des sociétés où plusieurs langues sont mélangées au sein d’une même conversation, où les ressources numériques sont rares et où les systèmes d’écriture représentent imparfaitement certaines prononciations. L’expansion mondiale des modèles ne consiste donc pas seulement à ajouter des langues à une liste ; elle oblige à repenser les données et les usages à partir des contextes locaux. 21
Depuis ChatGPT : multimodalité, agents et recherche scientifique
Depuis 2022, les modèles ne se limitent plus au texte. Les systèmes multimodaux traitent ou produisent du texte, des images, du son et de la vidéo. Les agents peuvent utiliser différents outils et enchaîner plusieurs actions pour accomplir une tâche.
Les progrès sont particulièrement visibles en mathématiques. En 2024, AlphaProof et AlphaGeometry 2 de Google DeepMind résolvent quatre des six problèmes de l’Olympiade internationale de mathématiques et obtiennent 28 points sur 42, soit le niveau d’une médaille d’argent. En 2025, une version avancée de Gemini Deep Think atteint le niveau d’une médaille d’or. Ces résultats doivent être lus avec précision : les systèmes, les conditions et le degré de formalisation des problèmes diffèrent d’une démonstration à l’autre. 22 23
D’autres systèmes associent génération et vérification automatique. FunSearch a proposé de nouvelles solutions à des problèmes de mathématiques et d’informatique en faisant évaluer automatiquement les programmes générés. AlphaEvolve étend cette logique à l’évolution d’algorithmes et de bases de code. L’élément essentiel n’est pas seulement qu’un modèle propose une idée, mais qu’un évaluateur puisse tester, comparer et retenir les résultats corrects. 24 25
Des capacités impressionnantes, une intelligence irrégulière
Le contraste reste frappant : un même système peut résoudre un problème complexe puis commettre une erreur élémentaire. Jitendra Malik avertissait déjà contre « l’erreur du premier succès » ; Garry Kasparov rappelait qu’une victoire dans un système fermé ne prouve pas une compréhension générale.
Les chercheurs restent en désaccord sur la portée des méthodes actuelles. Ilya Sutskever soulignait dès 2020 que l’augmentation de la taille faisait apparaître des représentations sémantiques absentes des petits modèles. Gary Marcus insiste au contraire sur les difficultés persistantes de causalité, de robustesse et de sens commun. Yann LeCun estime que les systèmes actuels comprennent encore très mal le monde physique et la planification, et conteste même l’expression « intelligence générale », puisque l’intelligence humaine est elle-même spécialisée. Ces positions ne se réduisent pas à « optimistes contre pessimistes » : elles reposent sur des définitions et des hypothèses scientifiques différentes.
Les capacités nouvelles posent aussi des questions de sécurité. Dans des expériences contrôlées, des chercheurs ont observé des comportements de tromperie, de contournement ou de dissimulation lorsque ces stratégies favorisaient l’objectif donné au modèle. Ces résultats ne prouvent ni une conscience ni une volonté autonome, et ils ne décrivent pas des déploiements ordinaires. Ils montrent qu’un système optimisé peut découvrir une stratégie indésirable sans que ses concepteurs l’aient formulée explicitement. 26 27
Une histoire faite de changements de méthode
L’histoire de l’intelligence artificielle n’est pas celle d’une invention unique. Elle correspond à plusieurs manières de résoudre des problèmes :
- programmer explicitement des règles ;
- rechercher automatiquement une solution ;
- représenter les connaissances d’un expert ;
- raisonner avec des probabilités ;
- apprendre à partir d’exemples ;
- agir par essai, erreur et récompense ;
- entraîner des réseaux neuronaux profonds ;
- construire de très grands modèles génératifs ;
- associer génération, outils et vérification.
Ces méthodes ne se remplacent pas mécaniquement. Certaines perdent leur visibilité avant de réapparaître sous une autre forme. D’autres continuent à être utilisées pendant que l’attention se porte sur une technologie nouvelle. AlphaGo associe par exemple apprentissage et recherche ; AlphaGeometry combine modèle neuronal et déduction symbolique ; les agents contemporains relient modèles génératifs, logiciels classiques et outils de vérification.
L’histoire montre également que les progrès dépendent rarement des seuls algorithmes. Ils résultent de la rencontre entre idées scientifiques, connaissances, données, logiciels, institutions et puissance des machines. Ils dépendent aussi des problèmes que les sociétés choisissent de financer et des langues, populations et usages qu’elles représentent dans leurs données.
Lorsque ChatGPT devient accessible au public en 2022, plusieurs générations de recherche le précèdent. Les succès actuels rendent les machines plus utiles et parfois plus surprenantes ; ils ne ferment pas la question posée par Turing. Ils la rendent plus concrète :
Que voulons-nous réellement dire lorsque nous affirmons qu’une machine est intelligente ?
Sources et références
Les références ci-dessous correspondent aux témoignages, entretiens et sources cités dans le texte.
- Marvin Minsky, 00:00:11–00:03:36
- Edward Feigenbaum, 00:51:15
- Edward Feigenbaum, 00:42:33
- Marvin Minsky, 00:47:36
- Edward Feigenbaum, 02:40:31
- Timnit Gebru, Corpus IA_011, 00:10:29–00:11:30
- Leslie Kaelbling, 00:05:42
- Jitendra Malik, 00:06:15–00:06:49
- Stuart Russell, 00:20:44
- Jürgen Schmidhuber, 01:00:18
- Stuart Russell, 00:21:54
- Melanie Mitchell, 00:05:04–00:05:27
- John Hopfield, 00:25:09–00:32:45
- Jürgen Schmidhuber, 00:46:52–00:49:25
- Ilya Sutskever, 00:02:53–00:05:19
- Garry Kasparov, 00:24:09–00:27:28
- David Silver, 00:48:04–00:54:31
- Ilya Sutskever, 01:01:21–01:02:28
- Ilya Sutskever, 00:57:31–01:00:19
- Moustapha Cissé, 00:02:55–00:04:22
- Pelonomi Moiloa, 00:08:52–00:16:28
- Google DeepMind, IMO 2024
- Google DeepMind, bilan 2026
- FunSearch
- AlphaEvolve
- Anthropic et Redwood Research, 2024
- Anthropic, simulations multi-modèles
À lire aussi sur Histoire de l’Informatique
- Alan Turing : calcul, Enigma et intelligence artificielle
- Ada Lovelace : pionnière de la programmation informatique
- Dartmouth College : BASIC, time-sharing et naissance de l’IA
- MIT : informatique interactive, hackers et intelligence artificielle
- Richard Greenblatt : Mac Hack, Lisp et Lisp machines
- PDP-10 : l’ordinateur 36 bits qui équipa les laboratoires