Comment fonctionne une intelligence artificielle ?
Lorsqu’on utilise ChatGPT, un logiciel capable de reconnaître une image ou une intelligence artificielle qui joue au Go, le résultat peut donner l’impression qu’une machine observe, comprend puis réfléchit avant de répondre. La réalité est différente, mais pas moins étonnante.
Une intelligence artificielle moderne n’est ni un cerveau numérique rempli de connaissances, ni une gigantesque collection de règles écrites une par une par des programmeurs. Dans les systèmes fondés sur l’apprentissage automatique, une grande partie du comportement est acquise à partir de données. Pour les réseaux neuronaux actuels, apprendre consiste essentiellement à ajuster un très grand nombre de valeurs numériques afin d’obtenir progressivement de meilleurs résultats.
Pour comprendre ce mécanisme, il faut partir d’une différence fondamentale : dans un programme classique, nous écrivons les règles ; avec le machine learning, nous construisons un système capable d’en apprendre une partie.
Programme classique ou intelligence artificielle : qu’est-ce qui change ?
Dans un programme traditionnel, le développeur décrit explicitement ce que l’ordinateur doit faire. Une règle peut par exemple prendre cette forme :
SI age < 18
ALORS appliquer_reduction()
La décision ne contient ici aucune surprise : quelqu’un a prévu la situation et écrit la règle correspondante. Cette approche est très efficace lorsque le problème peut être décrit précisément.
Essayons maintenant de programmer à la main la reconnaissance d’un chat sur n’importe quelle photographie. Nous pourrions chercher deux oreilles, des moustaches, quatre pattes ou une certaine forme de tête. Mais un chat peut être couché, vu de dos, partiellement caché, photographié de nuit ou réduit à quelques pixels. Très vite, la liste des règles devient impossible à écrire.
L’apprentissage automatique inverse alors le problème. Au lieu d’expliquer à la machine comment reconnaître tous les chats possibles, on lui présente des exemples :
image 1 → chat
image 2 → chien
image 3 → chat
image 4 → cheval
Le système modifie progressivement son fonctionnement pour produire de meilleures réponses sur ces exemples. La différence essentielle est donc la suivante : le programmeur écrit toujours le programme qui apprend, mais il n’écrit plus nécessairement toutes les règles finales permettant de résoudre la tâche.
Un modèle, c’est quoi exactement ?
Le mot modèle revient constamment lorsqu’on parle d’intelligence artificielle. Dans sa forme la plus simple, un modèle est une fonction mathématique contenant des valeurs réglables appelées paramètres. Modifier ces paramètres modifie le résultat produit.
On peut imaginer un exemple extrêmement simple :
sortie = entrée × poids + biais
Le poids et le biais sont deux paramètres. Lors de l’apprentissage, le système cherche des valeurs qui permettent à cette fonction de produire de meilleurs résultats.
Un réseau neuronal reprend cette idée à une échelle beaucoup plus grande. Il contient de nombreuses couches de calcul et parfois des milliards de paramètres. Un modèle annoncé avec « 7 milliards de paramètres » contient donc approximativement sept milliards de valeurs numériques apprises pendant son entraînement. Elles ne correspondent pas chacune à un fait ou à une règle identifiable : leur action est distribuée dans l’ensemble du réseau.
Pourquoi parle-t-on de neurones artificiels ?
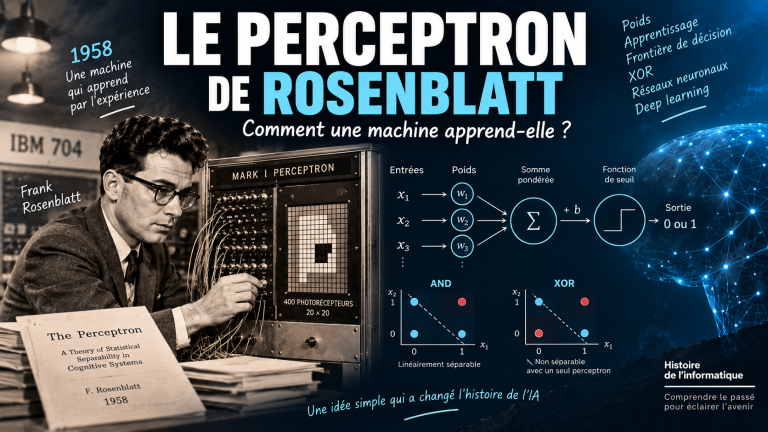
Le terme peut être trompeur. Un neurone artificiel n’est pas une copie informatique fidèle d’un neurone biologique. C’est avant tout une petite opération mathématique qui reçoit plusieurs nombres, leur applique des poids, les additionne puis transforme le résultat.
Pris isolément, un tel neurone ne fait presque rien d’intéressant. Mais lorsque des millions d’opérations sont reliées en couches et que leurs paramètres sont correctement ajustés, le réseau peut construire des transformations extrêmement complexes.
entrée
   ↓
couche 1
   ↓
couche 2
   ↓
couche 3
   ↓
sortie
Dans un système de vision, l’entrée peut être constituée des nombres représentant les pixels d’une photographie. Les premières transformations peuvent devenir sensibles à certaines structures simples, tandis que les couches suivantes combinent progressivement ces informations pour produire des représentations plus complexes. Il ne faut cependant pas imaginer un « neurone moustache » puis un « neurone chat » parfaitement identifiable : l’information est généralement répartie entre de nombreuses activations.
Cette capacité à apprendre des représentations constitue l’un des apports essentiels du deep learning. Dans les approches plus anciennes, les spécialistes devaient souvent choisir eux-mêmes les caractéristiques intéressantes. Avec les réseaux profonds, une partie de ces représentations intermédiaires est apprise automatiquement.
Comment une intelligence artificielle apprend-elle ?
Au début de l’entraînement, les paramètres d’un réseau sont mal réglés. Le modèle produit donc de mauvaises réponses. Supposons qu’une photographie montre un chat et que le réseau estime seulement à 23 % la probabilité qu’il s’agisse d’un chat. Il faut alors répondre à deux questions : de combien s’est-il trompé, et quels paramètres faut-il modifier pour faire un peu mieux la prochaine fois ?
Une fonction de perte, ou loss function, mesure d’abord l’erreur. L’objectif de l’apprentissage devient alors très concret : réduire cette erreur. Le gradient indique comment une petite modification des différents paramètres influencerait le résultat, et un algorithme d’optimisation utilise cette information pour les corriger.
Il reste cependant un problème : l’erreur est observée à la sortie alors que les paramètres sont répartis dans toutes les couches. La rétropropagation, ou backpropagation, permet de calculer la contribution de ces différentes couches à l’erreur et de propager les corrections vers l’arrière.
prédiction
    ↓
mesure de l'erreur
    ↓
calcul des gradients
    ↓
correction des paramètres
    ↓
nouvelle prédiction
Ce cycle est répété encore et encore sur d’immenses quantités de données. Entraîner un réseau neuronal consiste donc, en grande partie, à faire des prédictions, mesurer les erreurs et modifier progressivement des nombres.
Le principe est relativement simple à énoncer. Ce qui change tout, c’est son échelle.
Supervisé, auto-supervisé, renforcement : plusieurs façons d’apprendre
Toutes les intelligences artificielles ne sont pas entraînées de la même manière. Dans l’apprentissage supervisé, chaque exemple possède une réponse connue : une image est étiquetée « chat », « chien » ou « cheval », et le modèle peut comparer directement sa prédiction avec la bonne réponse.
Pour les grands modèles de langage, il serait impossible de demander à des humains d’étiqueter manuellement les milliards de phrases utilisées pendant l’entraînement. Une grande partie de l’apprentissage est donc auto-supervisée : les données elles-mêmes fournissent les réponses. À partir de :
La capitale de la France est Paris.
on peut par exemple demander au modèle de prédire la suite de :
La capitale de la France est…
Enfin, dans l’apprentissage par renforcement, un système agit et reçoit une information sur la qualité de ses actions. Les programmes de jeu comme AlphaGo ont notamment exploité ce principe. Ces méthodes diffèrent, mais elles ont un point commun : l’expérience sert à modifier le comportement futur du modèle.
Pourquoi les GPU ont-ils joué un rôle aussi important ?
Les réseaux neuronaux modernes réalisent une quantité gigantesque d’opérations sur des matrices de nombres. Les GPU, initialement développés pour le graphisme, se sont révélés particulièrement adaptés à ce type de calcul parce qu’ils peuvent effectuer énormément d’opérations similaires en parallèle.
Le succès du deep learning ne vient donc pas seulement de nouveaux algorithmes. Il résulte de la rencontre entre plusieurs évolutions : davantage de données, de meilleures méthodes d’apprentissage, des modèles plus grands et une puissance de calcul devenue suffisante. Une idée mathématique peut ainsi exister pendant des années avant que le matériel permette réellement de l’exploiter à grande échelle.
Comment passe-t-on d’un réseau neuronal à ChatGPT ?
Un grand modèle de langage applique ces mêmes principes au texte. Mais un réseau neuronal ne manipule pas directement les mots tels que nous les voyons. Le texte doit d’abord être transformé en nombres.
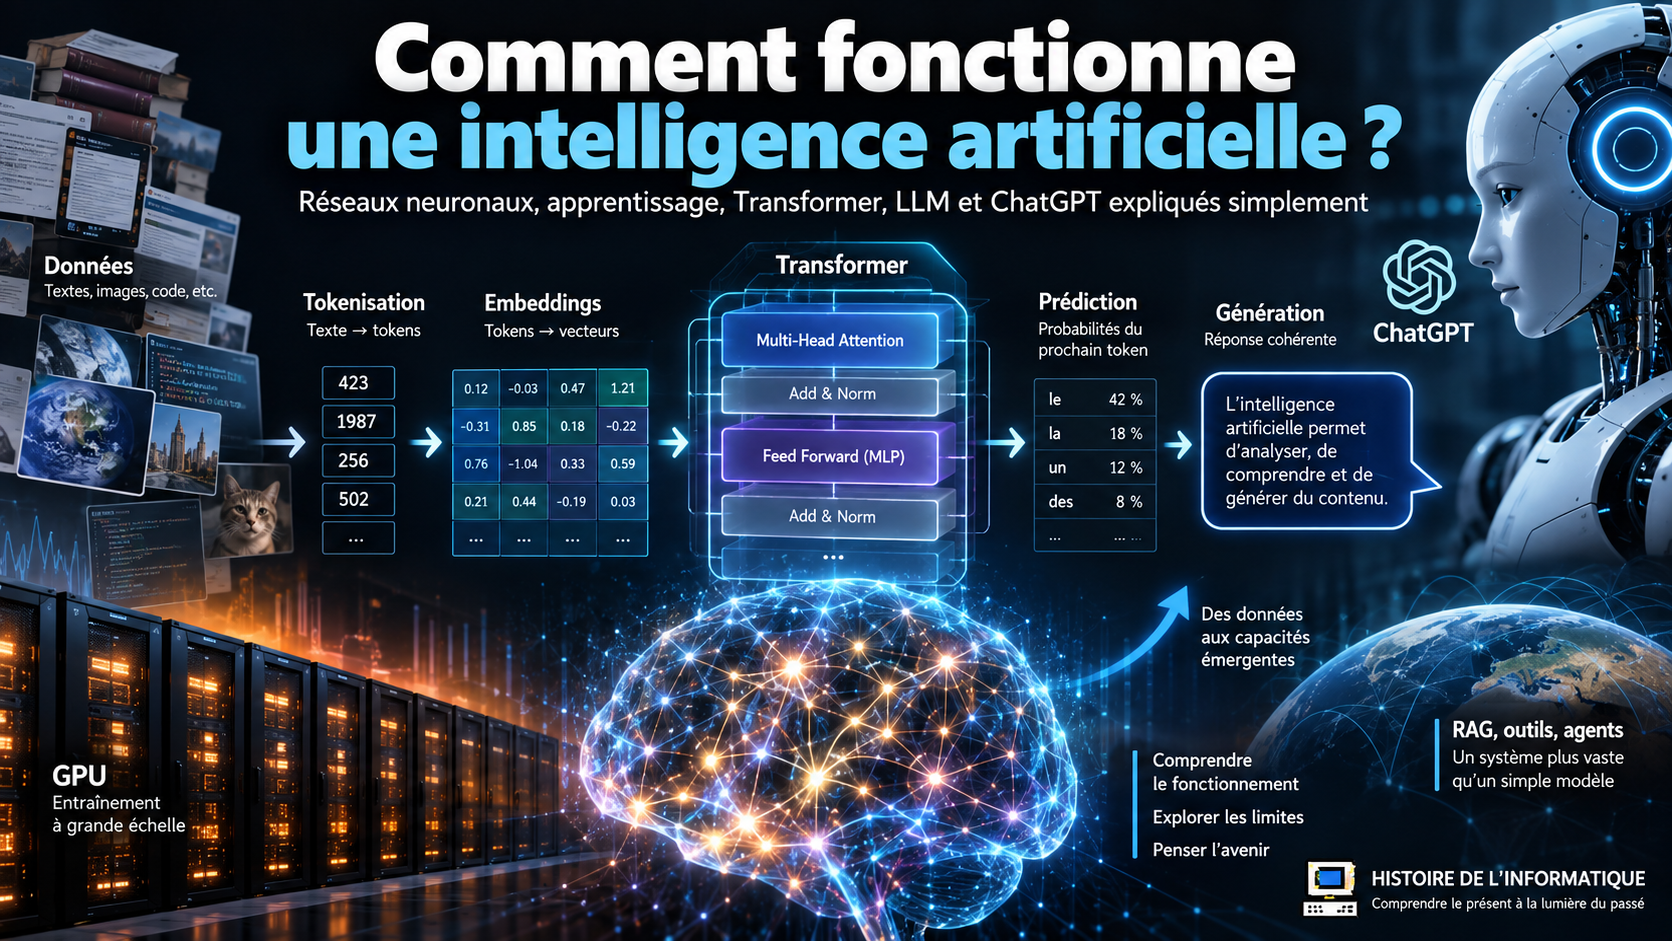
La première étape est la tokenisation. Une phrase est découpée en unités appelées tokens. Un token peut être un mot entier, une partie de mot, un nombre ou un signe de ponctuation. Chaque token est ensuite associé à une représentation numérique appelée embedding.
texte
  ↓
tokens
  ↓
représentations numériques
  ↓
réseau neuronal
Ces représentations sont apprises pendant l’entraînement. Elles permettent au système de manipuler mathématiquement des relations entre les éléments du texte, mais elles ne forment pas un dictionnaire simple où une dimension signifierait « animal », une autre « couleur » et une troisième « intelligence ». L’information est beaucoup plus distribuée.
Le Transformer : relier les éléments du contexte
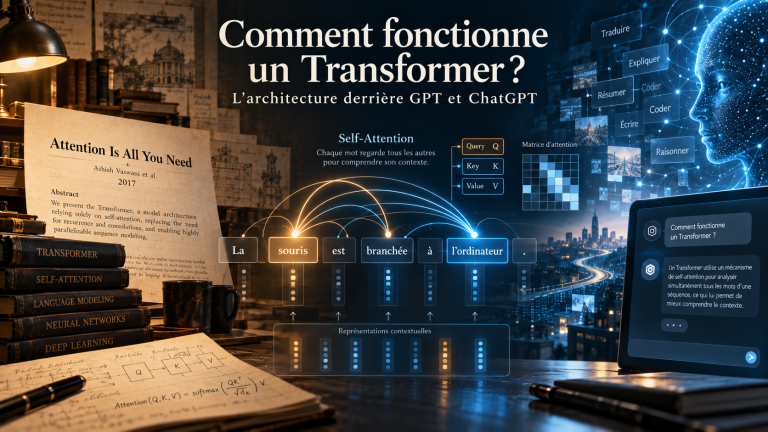
Les grands modèles de langage contemporains reposent largement sur une architecture apparue en 2017 : le Transformer. Son mécanisme d’attention permet aux différents tokens d’une séquence d’évaluer les relations qui les unissent.
Dans :
Marie prend son téléphone parce qu’elle doit appeler Paul.
le mot « elle » est fortement lié à « Marie ». Le Transformer permet au réseau de représenter ce type de relation, même lorsque les éléments sont éloignés dans le texte. Chaque couche modifie ainsi progressivement la représentation des tokens en fonction de leur contexte.
Le fonctionnement détaillé de la self-attention, des mécanismes Query-Key-Value et des différentes parties de cette architecture est expliqué dans notre article consacré au fonctionnement du Transformer.
Que fait réellement GPT pendant son entraînement ?
Le principe de base d’un modèle GPT est étonnamment simple à formuler : prédire le prochain token. Si le modèle reçoit :
La Terre tourne autour du…
il doit apprendre que « Soleil » constitue une continuation beaucoup plus probable que « fourchette » ou « chaussure ».
Cette opération est répétée sur une immense quantité de textes. Après chaque prédiction, la réponse produite est comparée avec la véritable suite, l’erreur est calculée, puis la rétropropagation ajuste les paramètres.
texte
   ↓
prédiction du token suivant
   ↓
comparaison avec la vraie suite
   ↓
erreur
   ↓
rétropropagation
   ↓
ajustement des paramètres
Dire qu’un grand modèle de langage « prédit le prochain token » est donc vrai, mais incomplet. Pour réussir cette tâche sur des textes très variés, le réseau doit apprendre de nombreuses régularités : syntaxe, relations entre concepts, structures de programmes, correspondances entre langues ou formes habituelles d’un raisonnement. Une tâche d’apprentissage relativement simple peut ainsi conduire à l’apparition de capacités beaucoup plus riches.
Le modèle mémorise-t-il simplement Internet ?
Pas exactement. Les grands réseaux peuvent mémoriser certaines séquences ou certains faits, mais ils apprennent également des régularités permettant de produire des combinaisons nouvelles. Un modèle n’est donc ni une simple base de données ni une encyclopédie compressée dans laquelle chaque information posséderait une adresse précise.
Il n’existe généralement pas un emplacement contenant « tout ce que le modèle sait sur Alan Turing ». Les informations sont réparties dans les paramètres et dans les activations produites lorsque le modèle traite un contexte. Cette représentation distribuée explique à la fois la souplesse des réseaux et la difficulté à comprendre précisément ce que chacun de leurs milliards de paramètres a appris.
Pourquoi une IA peut-elle halluciner ?
Un modèle de langage apprend avant tout à produire une continuation cohérente avec son contexte. Or une phrase plausible n’est pas nécessairement une phrase vraie. Si les représentations du modèle sont insuffisantes, si la question est ambiguë ou si une continuation incorrecte semble statistiquement crédible, il peut produire une affirmation fausse avec beaucoup d’assurance.
C’est ce que l’on appelle généralement une hallucination. Le système ne choisit pas consciemment de mentir : son mécanisme de génération n’est tout simplement pas une consultation garantie d’une base de faits certifiés.
Comment transforme-t-on un modèle de langage en assistant ?
Un modèle entraîné uniquement à prédire la suite de textes n’est pas automatiquement un bon assistant. Après le pré-entraînement, des étapes supplémentaires servent donc à lui apprendre à mieux suivre les instructions et à produire des réponses jugées utiles.
On peut notamment lui montrer des couples « instruction → bonne réponse ». Des évaluateurs humains peuvent également comparer plusieurs réponses afin d’indiquer lesquelles sont préférables. Le RLHF, pour Reinforcement Learning from Human Feedback, fait historiquement partie des méthodes utilisées à cette étape, même si les techniques de post-entraînement se sont depuis diversifiées.
Le point essentiel est que le modèle conversationnel utilisé par l’utilisateur n’est pas simplement le modèle brut issu du pré-entraînement. Son comportement a été ajusté pour le dialogue et le suivi d’instructions.
Cette évolution depuis les premiers programmes conversationnels jusqu’aux grands modèles actuels est détaillée dans notre article sur l’histoire des chatbots, d’ELIZA à ChatGPT.
Entraînement et utilisation : deux moments très différents
Cette distinction est fondamentale. Pendant l’entraînement, les paramètres du modèle sont modifiés. Le système traite des données, calcule des erreurs puis ajuste ses poids. Cette phase peut nécessiter d’énormes quantités de calcul.
données
   ↓
prédiction
   ↓
erreur
   ↓
rétropropagation
   ↓
modification des paramètres
Lors de l’inférence, c’est-à-dire lorsque nous utilisons le modèle, ses paramètres restent en principe fixes. Notre question traverse le réseau, qui calcule une réponse à partir de ce qu’il a appris.
question
   ↓
modèle entraîné
   ↓
calcul
   ↓
réponse
Lorsque vous posez une question à un LLM, celui-ci ne réentraîne donc pas ses milliards de paramètres à partir de votre message. C’est aussi pourquoi un ordinateur personnel puissant peut exécuter certains modèles en local alors qu’entraîner ces mêmes modèles depuis zéro demanderait des ressources incomparablement plus importantes.
Que se passe-t-il lorsqu’on pose une question à ChatGPT ?
Prenons la question : « Pourquoi le ciel est-il bleu ? ». Le texte est d’abord découpé en tokens, puis converti en représentations numériques. Ces représentations traversent les différentes couches du modèle, qui calculent progressivement une représentation du contexte. À la sortie, le réseau attribue un score aux différents tokens pouvant suivre.
Ces scores sont transformés en probabilités. Le système sélectionne ensuite un token, l’ajoute au texte déjà produit et recommence tout le calcul pour choisir le suivant.
question
   ↓
tokens
   ↓
embeddings
   ↓
Transformer
   ↓
probabilités du prochain token
   ↓
sélection d'un token
   ↓
ajout au contexte
   ↓
nouveau calcul
Une réponse qui semble apparaître d’un seul bloc est donc généralement construite token après token.
Paramètres et contexte : deux formes d’information différentes
Il faut également distinguer ce que le modèle a appris pendant son entraînement de ce qu’on lui fournit pendant une conversation. Les paramètres résultent de l’apprentissage préalable ; le contexte correspond aux informations disponibles pour la requête actuelle : votre question, les messages précédents, des instructions ou éventuellement des documents.
PARAMÈTRES
ce qui a été appris pendant l'entraînement

CONTEXTE
ce qui est fourni pour la tâche actuelle
Ajouter un document dans une conversation ne signifie donc pas nécessairement que le modèle « l’apprend » en modifiant ses paramètres. Le document agit plutôt comme une forme de mémoire de travail disponible pour produire la réponse.
Une IA moderne peut aussi utiliser des outils
Un assistant actuel n’est souvent plus seulement un réseau neuronal. Il peut également accéder à un moteur de recherche, des documents, une calculatrice, du code ou d’autres services. Dans un système de type RAG, des informations pertinentes sont d’abord recherchées puis ajoutées au contexte avant la génération de la réponse.
Les systèmes dits agents vont plus loin : le modèle peut choisir une action, utiliser un outil, examiner le résultat puis décider de l’étape suivante. Dans ce cas, ce que l’utilisateur appelle « l’IA » correspond en réalité à plusieurs technologies assemblées autour du modèle.
Alors, comment fonctionne réellement une intelligence artificielle ?
Il n’existe pas un mécanisme unique valable pour toutes les formes d’intelligence artificielle. Un système expert fondé sur des règles, un programme de jeu et un grand modèle de langage peuvent fonctionner de manières très différentes. Pour les systèmes modernes reposant sur le deep learning, on peut néanmoins résumer le principe de cette façon :
un modèle apprend en ajustant un très grand nombre de paramètres numériques afin de devenir meilleur pour produire les résultats attendus à partir des données qui lui sont présentées.
Dans un grand modèle de langage, le chemin ressemble alors à ceci :
textes d'entraînement
        ↓
tokens et représentations numériques
        ↓
réseau Transformer
        ↓
prédiction
        ↓
mesure de l'erreur
        ↓
ajustement des paramètres
        ↓
répétition à très grande échelle
        ↓
modèle entraîné
Puis, lorsque l’utilisateur pose une question :
question
   ↓
tokens
   ↓
modèle entraîné
   ↓
calcul du prochain token
   ↓
répétition
   ↓
réponse
Une intelligence artificielle moderne n’est donc ni une copie numérique du cerveau humain, ni une gigantesque liste de règles, ni une simple base de données. Elle est le résultat d’un apprentissage mathématique à grande échelle, dans lequel des milliards de paramètres ont été ajustés progressivement à partir de données.
Nous savons précisément décrire les opérations utilisées pour entraîner ces réseaux et produire leurs réponses. En revanche, lorsque des milliards de paramètres interagissent dans de nombreuses couches, comprendre exactement comment chaque représentation interne contribue à une capacité donnée devient beaucoup plus difficile.
C’est peut-être là que se trouve l’aspect le plus fascinant de ces systèmes : des opérations mathématiques relativement simples, répétées et combinées à une échelle gigantesque, peuvent produire des comportements qui deviennent eux-mêmes difficiles à résumer simplement.