L’IA comprend-elle vraiment ?
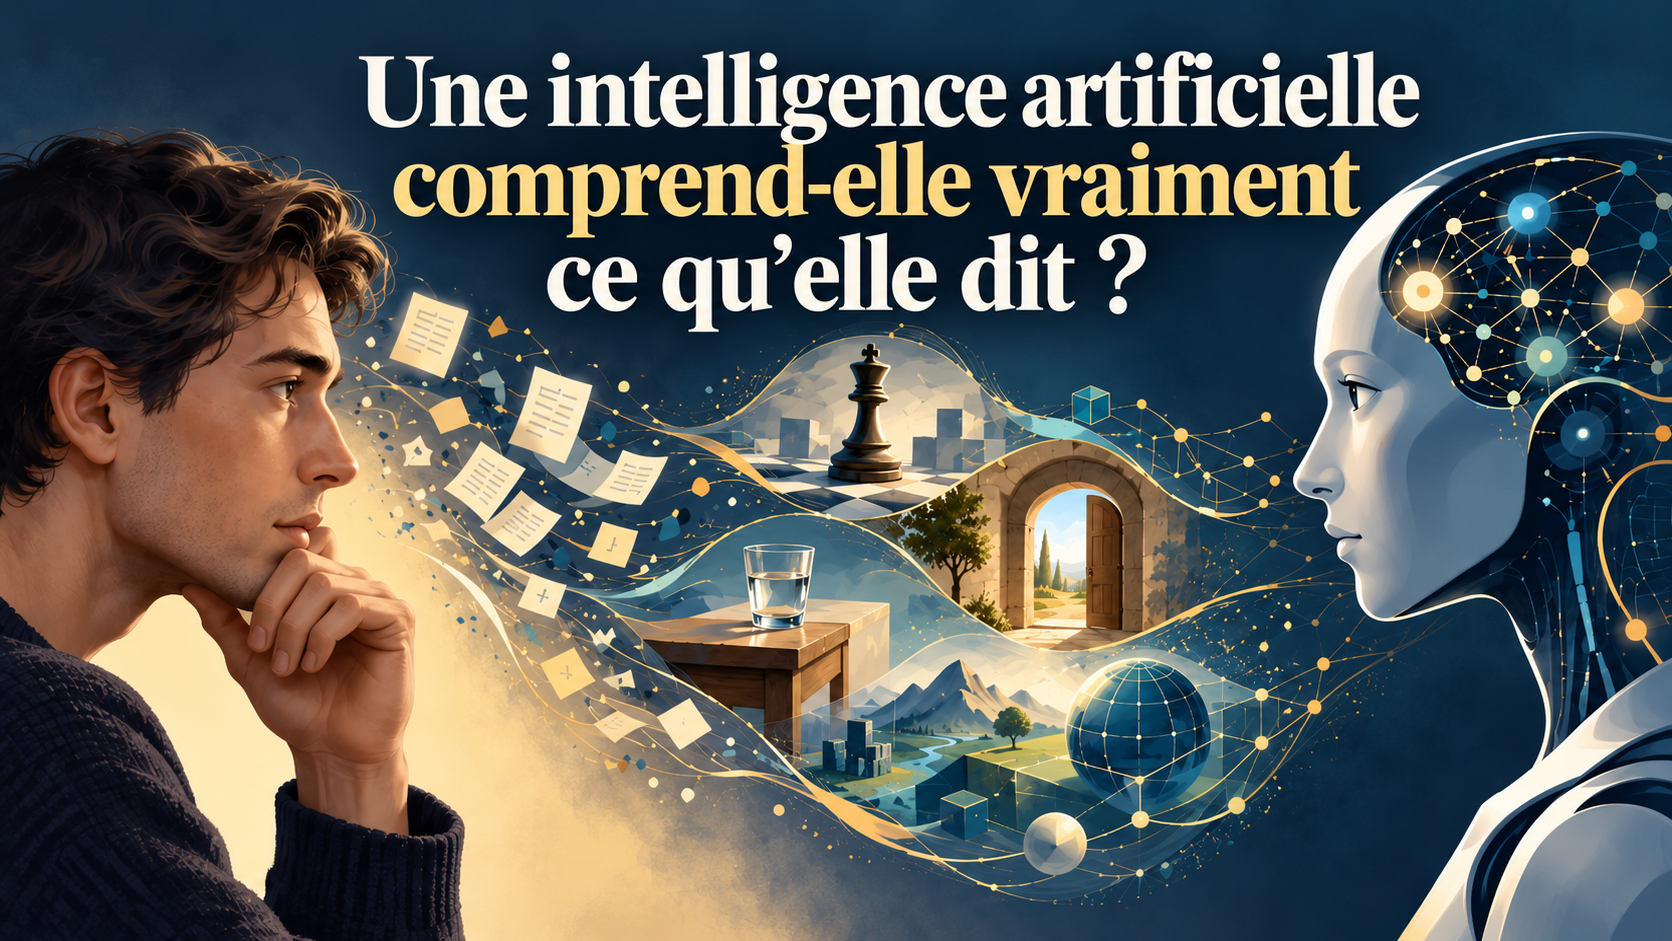
Une intelligence artificielle peut expliquer une plaisanterie, résoudre un exercice ou raconter pourquoi un personnage est triste. Mais comprend-elle réellement ce qu’elle raconte ? Pour répondre, encore faut-il savoir ce que signifie comprendre : reconnaître une situation, saisir les relations entre ses éléments, prévoir ce qui va se produire ou réutiliser une idée dans un contexte nouveau.
Cette question traverse toute l’histoire de l’intelligence artificielle. De Turing aux modèles du monde actuels, chercheurs et philosophes ne s’opposent pas seulement sur les capacités des machines : ils ne demandent pas toujours les mêmes preuves pour parler de compréhension.
1950 : Turing déplace la question
En 1950, Alan Turing propose de remplacer la question « les machines peuvent-elles penser ? » par une épreuve plus concrète : un échange écrit au cours duquel un humain tente de distinguer une machine d’une autre personne. Le problème devient alors observable : quels comportements permettraient de reconnaître une forme d’intelligence ?[1]
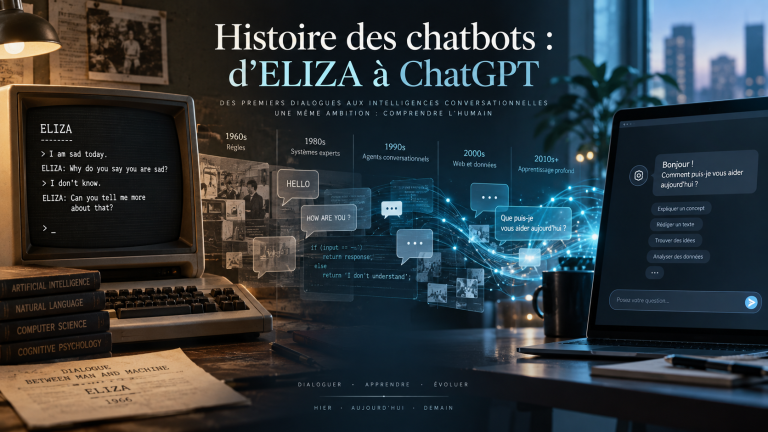
Mais produire une réponse convaincante suffit-il à montrer que la machine comprend ce qu’elle dit ? L’histoire des chatbots, d’ELIZA à ChatGPT, montre justement combien le dialogue nous pousse facilement à attribuer des connaissances, des intentions ou même des émotions à notre interlocuteur.
Pour évaluer une machine, il faut donc aller au-delà de l’impression produite et observer ce qui se passe lorsque la situation change.
1980 : la chambre chinoise de John Searle
En 1980, le philosophe John Searle imagine une expérience devenue célèbre : la « chambre chinoise ». Une personne qui ne connaît pas le chinois est enfermée dans une pièce. Elle reçoit des symboles chinois et possède des instructions lui indiquant quels autres symboles renvoyer.
Pour quelqu’un situé à l’extérieur, ses réponses pourraient paraître parfaitement pertinentes. Pourtant, la personne ne comprend toujours pas le chinois.
Pour Searle, cette expérience montre qu’appliquer correctement des règles à des symboles ne suffit pas nécessairement à en comprendre le sens.[2] Son argument a suscité de nombreuses objections, mais il pose une question qui reste actuelle : une machine peut-elle produire les bonnes réponses sans comprendre ce dont elle parle ?
Apprendre, raisonner et comprendre
Ces trois capacités sont souvent confondues.
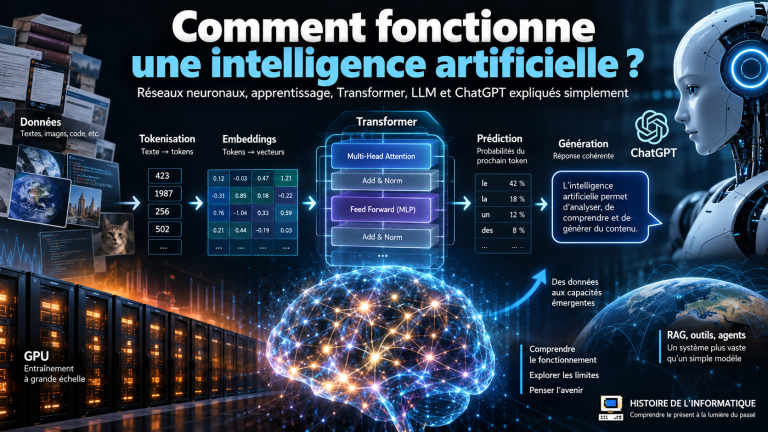
Dans un réseau neuronal, apprendre consiste notamment à ajuster des paramètres à partir d’exemples. Le système découvre ainsi des régularités qu’il peut ensuite utiliser sur de nouvelles données. Il ne se contente donc pas nécessairement de mémoriser des réponses. Notre article sur le fonctionnement d’une intelligence artificielle explique plus précisément ce mécanisme.
Raisonner, c’est relier plusieurs informations pour produire une conclusion ou préparer une action. Mais réussir un raisonnement particulier ne prouve pas que le système saura en faire autant dans une situation très différente.
La compréhension est encore plus difficile à définir. Faut-il pouvoir s’adapter à l’inédit ? Comprendre les causes d’un événement ? Relier une idée abstraite à une expérience du monde ? Conserver un raisonnement cohérent lorsqu’un élément du problème change ?
Quant à la conscience, c’est encore une autre question : comprendre quelque chose et éprouver subjectivement quelque chose ne sont pas synonymes.
2019 : Marcus cherche les règles, Mitchell les analogies
Pour Gary Marcus, le sens commun demande davantage que la reconnaissance de régularités. Dans un entretien de 2019, il défend une combinaison de réseaux neuronaux et de mécanismes capables de manipuler plus explicitement des symboles, des règles et des relations. Il souligne néanmoins que les outils classiques de logique ne suffisent pas, à eux seuls, à reproduire toute la souplesse du raisonnement humain.[3]
La même année, Melanie Mitchell s’intéresse à une autre capacité : reconnaître une même structure derrière des situations qui semblent différentes. Avec le programme Copycat, elle a étudié la manière dont un système peut construire des analogies et appliquer un concept à un nouveau problème.[4]
Prenons un exemple simple. Une file d’attente informatique et celle d’une boulangerie n’ont presque rien en commun en apparence. Pourtant, elles peuvent suivre la même règle : le premier arrivé est le premier servi. Comprendre l’analogie suppose de reconnaître cette structure malgré des objets très différents.
Marcus et Mitchell soulèvent ainsi deux aspects complémentaires du problème : quelles structures une machine doit-elle apprendre, et peut-elle les réutiliser lorsque l’apparence du problème change ?
2020 : que découvre un réseau en apprenant à prédire ?
Ilya Sutskever défend une autre idée : apprendre à prédire du texte peut conduire un réseau à construire des représentations internes de certaines propriétés de ce texte.
Dans un entretien de 2020, il revient sur une expérience publiée par OpenAI quelques années auparavant. Un réseau entraîné à prédire le caractère suivant dans des avis de clients avait développé une unité interne fortement liée au caractère positif ou négatif des textes.[5]
Le réseau avait donc appris une propriété utile sans recevoir explicitement la consigne « détermine si cet avis est positif ou négatif ». Sutskever y voit un signe de compréhension sémantique partielle, sans parler pour autant d’une compréhension complète.
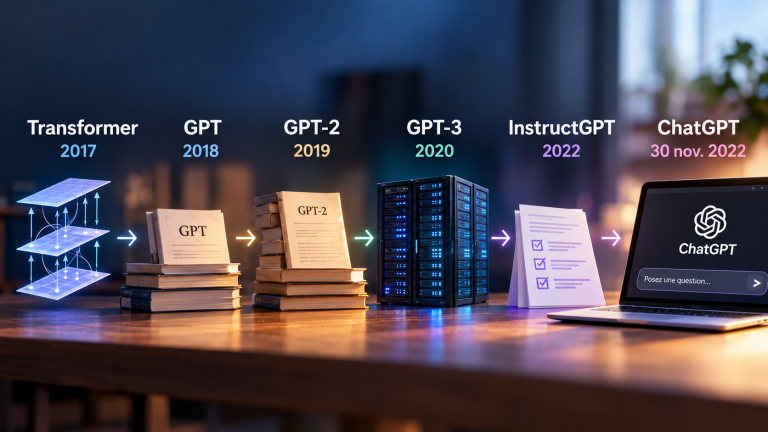
Cette question devient particulièrement importante avec les grands modèles de langage. L’architecture Transformer, utilisée notamment par GPT, permet à ces modèles d’exploiter les relations entre les différents éléments d’un texte. Leur objectif d’apprentissage peut sembler simple — prédire la suite — alors que les représentations nécessaires pour y parvenir peuvent devenir beaucoup plus complexes.
Chollet : savoir faire ou savoir apprendre ?
François Chollet propose de regarder le problème autrement. Dans son entretien de 2020, il distingue la compétence déjà acquise de la capacité à acquérir rapidement une compétence nouvelle.
Un ordinateur peut devenir extraordinairement fort aux échecs après un entraînement massif. Mais cette performance ne nous dit pas nécessairement comment il réagira face à un problème entièrement nouveau. Observer un humain apprendre les règles d’un nouveau jeu à partir de quelques explications apporte une information différente sur sa capacité d’adaptation.[6]
C’est précisément l’objectif du test ARC, présenté par Chollet en 2019 : confronter les systèmes à de petits problèmes visuels nouveaux, dans lesquels ils doivent découvrir une règle puis l’appliquer.
Le désaccord porte donc aussi sur la preuve recherchée. Faut-il considérer comme significatif qu’un réseau développe des représentations porteuses de sens, ou lui demander surtout de montrer qu’il peut généraliser bien au-delà de ce qu’il a rencontré pendant son apprentissage ?
Les mots suffisent-ils pour comprendre le monde ?
Une autre difficulté concerne l’origine du sens. Un enfant ne découvre pas seulement le mot « chaud ». Il touche des objets, ressent la chaleur, voit la vapeur d’une casserole et apprend qu’il peut se brûler. Le mot finit par être relié à une multitude d’expériences.
En 1990, Stevan Harnad formalise cette difficulté sous le nom de problème de l’ancrage des symboles.[7] Comment les symboles manipulés par un système peuvent-ils acquérir un sens qui ne dépende pas uniquement d’autres symboles ?
Pour un modèle principalement entraîné sur du texte, la question devient centrale : peut-il construire une représentation suffisamment riche du monde à partir de ce que les humains en ont écrit ?
2020–2025 : du langage aux modèles du monde
En 2020, Dileep George distingue justement un modèle du monde décrit par les textes d’un modèle du monde lui-même. Il doute alors que l’augmentation de la taille des modèles de langage suffise à leur donner le sens commun : une grande partie de ce que nous savons n’est jamais explicitement formulée, précisément parce que cela nous paraît évident.[8]
Si quelqu’un écrit qu’un verre est posé au bord d’une table, un humain dispose déjà de nombreuses connaissances sur la gravité, la matière, les mouvements ou la fragilité du verre. Rien de tout cela n’a besoin d’être expliqué dans la phrase.
En 2025, Yann LeCun met lui aussi l’accent sur les « modèles du monde » : des représentations permettant de prévoir comment une situation peut évoluer et quelles seront les conséquences d’une action. Il prend notamment l’exemple d’animaux capables d’enchaîner plusieurs gestes pour atteindre un objectif sans passer par le langage.[9]
LeCun défend donc un apprentissage davantage fondé sur l’observation et l’expérience du monde physique. Sa proposition n’est pas identique à celle de George, mais toutes deux conduisent à la même interrogation : le langage suffit-il pour construire toutes les connaissances nécessaires à une intelligence générale ?
La question est devenue d’autant plus visible depuis l’apparition des modèles GPT et de ChatGPT, capables d’utiliser le langage avec une aisance qui rend parfois difficile de distinguer compétence linguistique et compréhension du monde.
Comment tester la compréhension d’une IA ?
Plutôt que de chercher un verdict définitif — « l’IA comprend » ou « l’IA ne comprend pas » — ces travaux invitent à tester des capacités précises.
Un système peut-il appliquer une règle dans une situation qu’il n’a jamais rencontrée ? Modifier sa conclusion lorsqu’une donnée change ? Repérer une contradiction ? Prévoir les conséquences d’une action ? Réutiliser un concept dans un domaine différent ?
Prenons un verre posé sur une table. Un modèle peut expliquer qu’il risque de tomber si on le pousse vers le bord. Mais que se passe-t-il si la table est inclinée ? Si le verre est attaché par une ficelle ? Ou si la scène se déroule en apesanteur ?
La question n’est plus seulement de savoir si le modèle connaît une réponse, mais s’il peut adapter son raisonnement lorsque les relations entre les éléments changent.
Une réussite fournit alors un indice sur une capacité donnée. Une erreur en révèle une limite. Aucune expérience isolée ne permet cependant de trancher toute la question.
Demander simplement si une IA « comprend » est probablement trop vague. Il est plus instructif de demander ce qu’elle comprend, dans quelles conditions, et jusqu’où cette compréhension résiste lorsque le problème change.
Depuis Turing, le défi reste finalement le même : transformer une immense question sur l’intelligence en expériences suffisamment précises pour mesurer ce que les machines savent réellement faire.
Sources et entretiens
- Alan Turing, Computing Machinery and Intelligence, 1950.
- John Searle, Minds, Brains, and Programs, Behavioral and Brain Sciences, 1980.
- Gary Marcus, entretien avec Lex Fridman, 2019, repères du corpus : 30:59–32:19 et 1:13:06–1:13:35.
- Melanie Mitchell, entretien avec Lex Fridman, 2019, 36:12–37:34.
- Ilya Sutskever, entretien avec Lex Fridman, 2020, 59:25–1:00:42.
- François Chollet, entretien avec Lex Fridman, 2020, 33:12–34:47 ; On the Measure of Intelligence, 2019.
- Stevan Harnad, The Symbol Grounding Problem, Physica D, 1990.
- Dileep George, entretien avec Lex Fridman, 2020, 1:33:41–1:35:05.
- Yann LeCun, AI Inside, 2025, repères du corpus : 26:57–28:15 ; transcription officielle pour les modèles du monde. Les minutages peuvent varier selon la version et les publicités.