Le Transformer
Le Transformer est l’une des architectures les plus importantes de l’intelligence artificielle moderne. Présenté en 2017 dans l’article scientifique Attention Is All You Need, il se trouve aujourd’hui au cœur de nombreux grands modèles de langage, notamment GPT, et donc de ChatGPT. Pourtant, son fonctionnement paraît souvent difficile à comprendre lorsqu’on rencontre pour la première fois des termes comme self-attention, Query, Key ou Value.
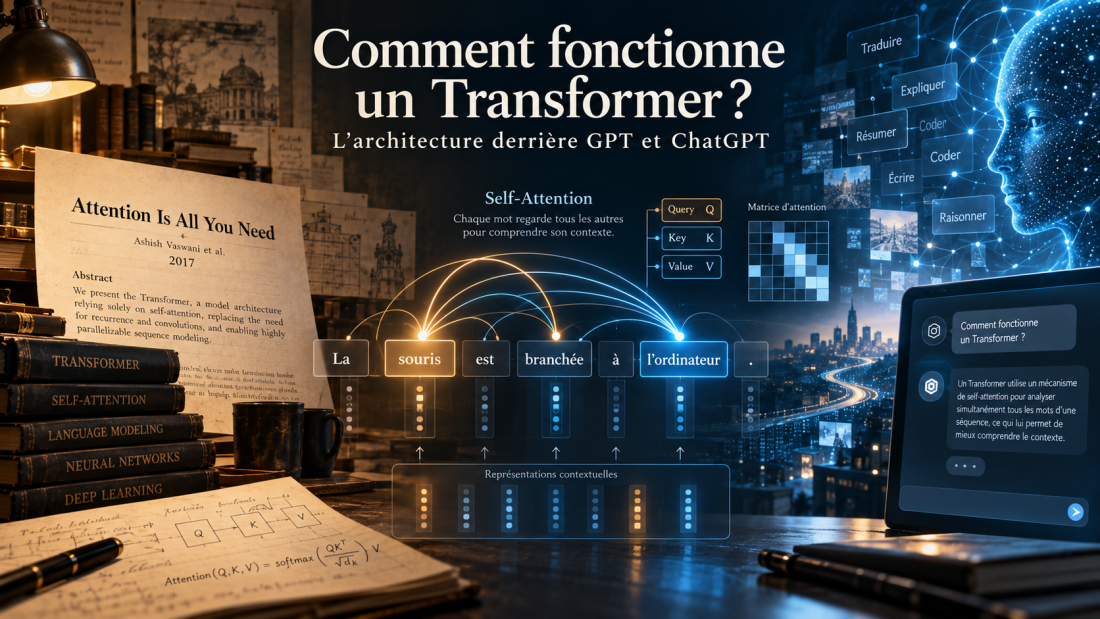
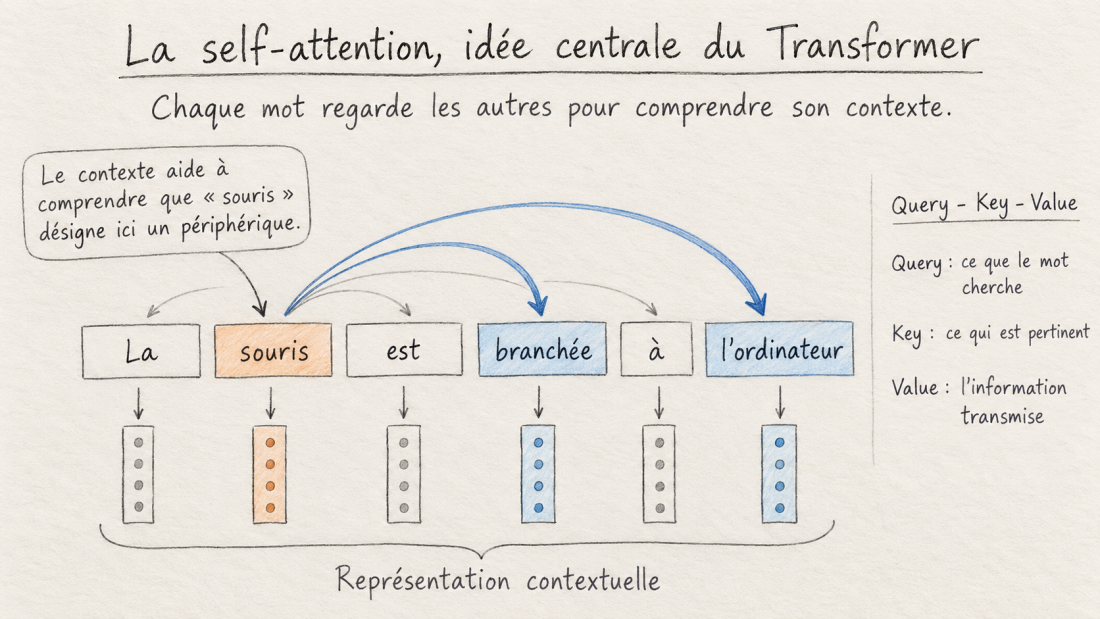
Derrière ce vocabulaire se cache une idée assez simple : pour interpréter un élément d’une phrase, il faut regarder les relations qu’il entretient avec les autres. Dans « la souris est branchée à l’ordinateur », nous comprenons immédiatement que « souris » désigne un périphérique et non un animal. Ce sont les mots « branchée » et « ordinateur » qui orientent notre interprétation. Le Transformer cherche, par des opérations mathématiques, à exploiter ce principe du contexte.
Avant le Transformer : traiter une phrase pas à pas
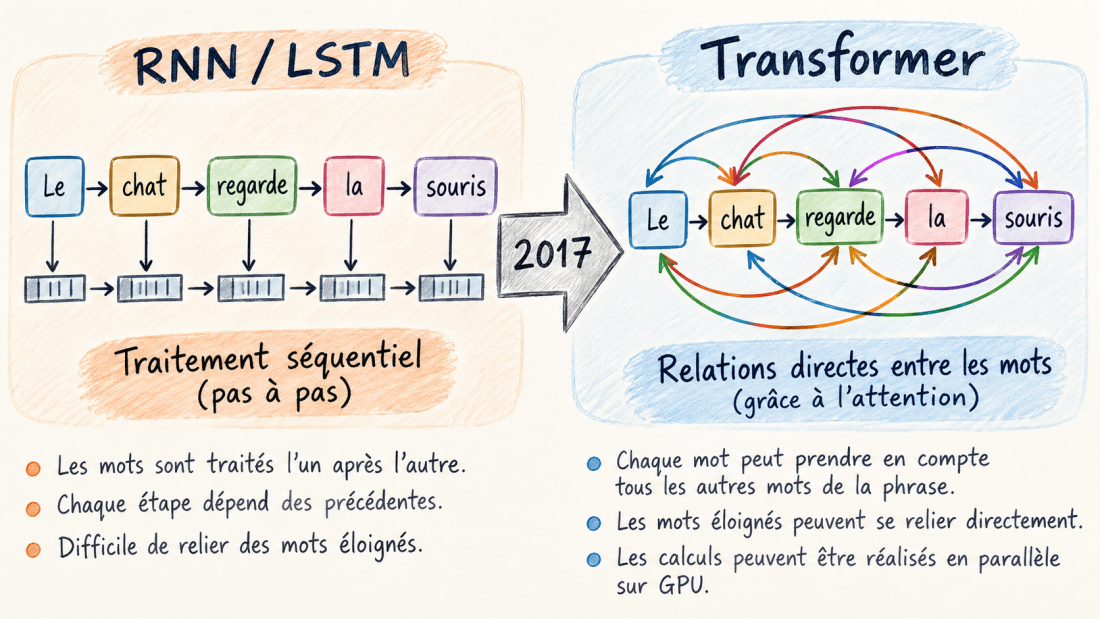
Avant 2017, les réseaux neuronaux utilisés pour traiter le langage reposent souvent sur des architectures récurrentes, les RNN, notamment leur variante LSTM, conçue pour mieux conserver certaines informations au fil d’une séquence. Une phrase est alors traitée progressivement, chaque étape utilisant une partie de l’information produite par les précédentes.
Le → chat → regarde → la → souris
Cette approche fonctionne, mais elle possède une limite importante : le calcul reste en grande partie séquentiel. Pour avancer dans la phrase, il faut attendre les étapes précédentes. Or les GPU, devenus essentiels au fonctionnement des intelligences artificielles modernes, sont particulièrement efficaces lorsqu’ils peuvent réaliser un très grand nombre d’opérations en parallèle. À mesure que les jeux de données et les modèles grandissent, cette contrainte devient de plus en plus importante.
L’attention existait avant le Transformer
Le Transformer n’a pas inventé le mécanisme d’attention. En 2014, les travaux de Dzmitry Bahdanau, Kyunghyun Cho et Yoshua Bengio proposent déjà de l’utiliser pour améliorer la traduction automatique. Le réseau peut privilégier certaines parties de la phrase source au moment de produire sa traduction.
Si l’on veut traduire The black cat sleeps on the sofa, le système a intérêt, lorsqu’il produit le mot « chat », à accorder beaucoup d’importance à cat et beaucoup moins à sofa. L’idée essentielle est déjà là : toutes les informations ne sont pas également utiles à chaque instant.
2017 : Attention Is All You Need
En 2017, huit chercheurs publient un article qui va profondément transformer le domaine : Attention Is All You Need. Leur proposition est radicale : au lieu d’ajouter simplement l’attention à un réseau récurrent, ils construisent une architecture dans laquelle l’attention devient le principal mécanisme permettant aux éléments d’une séquence d’échanger de l’information. Cette architecture reçoit le nom de Transformer.
Elle n’est pas conçue à l’origine pour créer un chatbot. Les premières expériences concernent surtout la traduction automatique. Pourtant, l’idée va rapidement dépasser ce domaine et devenir une étape majeure de l’histoire de l’intelligence artificielle.
La self-attention : chaque élément prend en compte son contexte
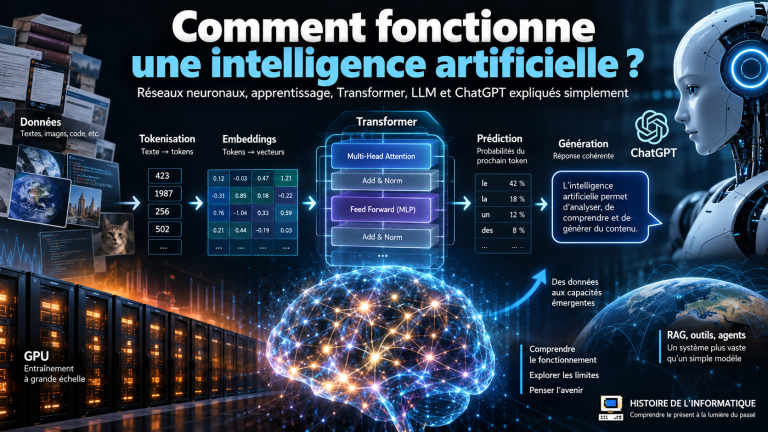
Reprenons notre exemple : » La souris est branchée à l’ordinateur » . Un ordinateur ne manipule pas directement le concept de « souris ». Le texte est d’abord découpé en éléments appelés tokens, qui peuvent correspondre à des mots, à des morceaux de mots ou à des signes de ponctuation. Chaque token est ensuite transformé en une représentation numérique composée de nombreuses valeurs.
La self-attention, ou auto-attention, permet à chaque position d’évaluer ses relations avec les positions auxquelles elle a accès. Dans un encodeur qui peut examiner toute la phrase, la représentation de « souris » peut ainsi recevoir davantage d’informations provenant de « branchée » et « ordinateur ».
La   souris   est   branchée   à   l'ordinateur
       ↑               │                 │
       └───────────────┴─────────────────┘
             informations utiles
Cet exemple suppose un accès au contexte des deux côtés. Dans GPT, chaque position ne peut utiliser que les tokens qui la précèdent et
le token présent à cette position. Par exemple, pour prédire la suite de « La Terre tourne autour du », le modèle ne peut pas consulter « Soleil », même si
ce mot figure déjà dans le texte d’entraînement : un masque d’attention le lui cache.
C’est un point essentiel : le Transformer construit des représentations qui dépendent du contexte. Le mot « avocat » pourra ainsi être représenté différemment dans « l’avocat défend son client » et dans « je coupe un avocat ».
Query, Key et Value : que signifient ces trois termes ?
Pour réaliser cette opération, le Transformer calcule, à partir de la représentation de chaque élément, trois vecteurs appelés Query, Key et Value. Les noms peuvent sembler abstraits, mais l’intuition est relativement simple. La Query représente ce que l’élément cherche, la Key permet d’évaluer la pertinence d’un élément, et la Value correspond à l’information qu’il peut transmettre.
On peut imaginer que le token « souris » demande silencieusement : « Quels éléments peuvent m’aider à préciser mon rôle ici ? ». Sa Query est comparée aux Keys des positions accessibles, y compris la sienne. Ces comparaisons produisent des scores, convertis en poids par une opération appelée softmax. Les Values sont ensuite combinées selon ces poids : certaines contribuent davantage que d’autres au résultat.
Bien entendu, aucune question n’est réellement formulée. Ces vecteurs sont calculés grâce à des transformations dont les paramètres sont appris pendant l’entraînement. La métaphore aide seulement à rendre l’opération plus intuitive.
Pourquoi plusieurs têtes d’attention ?
Un Transformer ne réalise généralement pas une seule opération d’attention. Il en effectue plusieurs en parallèle : c’est la multi-head attention, ou attention multi-têtes. On peut imaginer plusieurs regards portés simultanément sur la même phrase, chacun utilisant ses propres transformations de Query, Key et Value. Leurs résultats sont ensuite réunis.
Ces têtes peuvent apprendre à mettre en évidence des relations différentes : dépendances entre mots éloignés, structures locales ou régularités présentes dans les données. Il serait toutefois trompeur de dire qu’une tête est « la tête de la grammaire » et une autre « la tête du sens ». Ces spécialisations ne sont pas programmées à l’avance ; elles émergent de l’apprentissage.
Comment le Transformer connaît-il l’ordre des mots ?
Comparez « le chien poursuit le chat » et « le chat poursuit le chien ». Les mêmes mots sont présents, mais leur ordre change complètement le sens. Or le mécanisme d’attention, à lui seul, ne contient pas naturellement la notion de premier, deuxième ou troisième élément.
Le modèle doit donc disposer d’une information de position. Dans l’architecture de 2017, celle-ci est ajoutée à la représentation de chaque token grâce à des fonctions utilisant des sinus et des cosinus. D’autres méthodes intégreront ensuite la position différemment, mais l’objectif reste le même : tenir compte à la fois de l’élément présent et de sa place dans la séquence.
Le        → position 1
chien     → position 2
poursuit  → position 3
le        → position 4
chat      → position 5
Le Transformer n’est pas uniquement de l’attention
Le titre Attention Is All You Need est devenu si célèbre qu’il peut donner une fausse impression. Un Transformer contient aussi des réseaux neuronaux généralement appelés feed-forward, ainsi que des connexions résiduelles et des mécanismes de normalisation. L’attention joue un rôle central dans la circulation de l’information, mais elle ne constitue pas l’intégralité du modèle.
Très schématiquement, l’attention combine les informations entre positions, puis le réseau feed-forward transforme la représentation de chaque position. Ces blocs sont répétés plusieurs fois.
représentation des tokens
          ↓
    self-attention
          ↓
 réseau feed-forward
          ↓
nouvelle représentation
Ce schéma simplifie volontairement les connexions résiduelles et la normalisation, qui accompagnent ces opérations.
Encodeur et décodeur : le Transformer original
L’architecture présentée en 2017 comporte deux grandes parties : un encodeur et un décodeur. L’encodeur transforme la phrase d’entrée en une série de représentations contextualisées. Le décodeur les consulte ensuite pour produire progressivement la sortie.
Dans une tâche de traduction, on peut ainsi fournir une phrase anglaise à l’encodeur et laisser le décodeur générer sa version française.
"The cat is sleeping"
        ↓
     encodeur
        ↓
représentations de la phrase
        ↓
     décodeur
        ↓
"Le chat dort"
Le décodeur utilise deux formes d’attention : une auto-attention sur le texte de sortie déjà disponible, et une attention croisée vers les représentations produites par l’encodeur. Les modèles apparus ensuite reprendront cette architecture de différentes manières.
Transformer, BERT, GPT et ChatGPT : quelle différence ?
| Terme | Ce que c’est |
|---|---|
| Transformer | Une architecture de réseau neuronal présentée en 2017. |
| BERT | Un modèle de type encodeur, qui utilise le contexte situé des deux côtés d’une position pour représenter le texte. |
| GPT | Une famille de modèles génératifs reposant sur des Transformers de type décodeur à attention causale. |
| ChatGPT | Un assistant conversationnel qui exploite des modèles de langage, avec des mécanismes et des outils destinés notamment au dialogue et au suivi des instructions. |
Transformer, GPT et ChatGPT ne désignent donc pas la même chose : une architecture générale, une famille de modèles et un assistant qui permet de les utiliser.
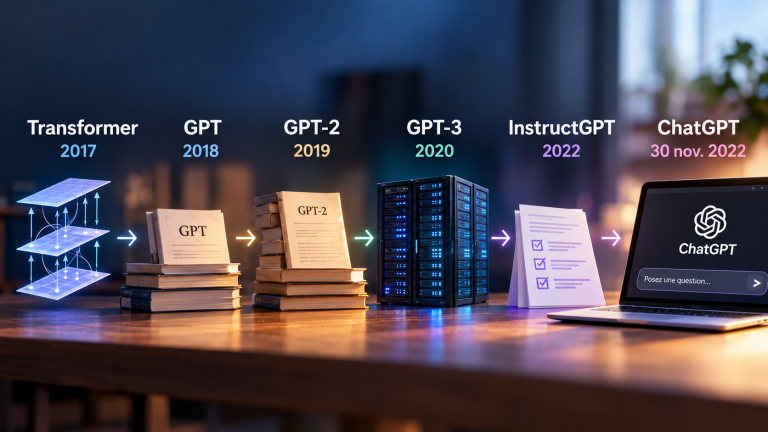
Cette évolution s’inscrit dans une histoire beaucoup plus ancienne, depuis ELIZA et les premiers chatbots jusqu’à ChatGPT.
Comment GPT utilise-t-il l’attention ?
GPT apprend notamment à prédire le token suivant d’une séquence. Après « La Terre tourne autour du… », une continuation comme « Soleil » est beaucoup plus vraisemblable que « fourchette » ou « chaussure ». Mais pendant cet apprentissage, le modèle ne doit pas pouvoir consulter à l’avance le token qu’il doit prédire.
On utilise donc une attention causale : chaque position peut prendre en compte les positions précédentes et elle-même, mais pas les suivantes.
La       → peut voir : La
Terre    → La Terre
tourne   → La Terre tourne
autour   → La Terre tourne autour
du       → La Terre tourne autour du
           puis prédiction du token suivant
Il faut ici distinguer entraînement et génération. Pendant l’entraînement, le texte est déjà connu : les calculs de nombreuses positions peuvent être réalisés en parallèle, avec un masque qui empêche de consulter la suite. Lors de la génération autorégressive ordinaire, en revanche, le modèle avance token par token, chaque nouvel élément rejoignant le contexte utilisé pour produire le suivant.
Pourquoi le Transformer a-t-il changé l’intelligence artificielle ?
Le succès du Transformer ne repose pas sur une propriété magique. Les éléments éloignés d’une séquence peuvent échanger directement de l’information, une grande partie des calculs peut être parallélisée et l’architecture s’adapte bien aux GPU et aux autres accélérateurs.
Dans un entretien avec Lex Fridman en 2020, Ilya Sutskever insiste précisément sur cette combinaison : l’attention compte, mais aussi l’efficacité sur GPU et l’absence de récurrence, qui facilite l’optimisation. Son témoignage rappelle que la réussite du Transformer tient également à une qualité très concrète : mieux exploiter le calcul disponible.
L’architecture peut être agrandie à des modèles possédant des millions puis des milliards de paramètres. Son principe sera aussi appliqué aux images, au son, à la vidéo et à des systèmes multimodaux capables de combiner plusieurs types d’informations.
Comme souvent dans l’histoire de l’IA, la rupture apparaît lorsque une architecture, des méthodes d’apprentissage, d’immenses quantités de données et une puissance de calcul suffisante se rencontrent.
Une faiblesse : l’attention coûte cher
Dans la self-attention classique, chaque position peut être comparée à toutes les positions autorisées par le masque. Lorsque la longueur du contexte augmente, le nombre de relations à calculer augmente très rapidement. Pour n éléments, le coût de l’attention dense augmente approximativement comme n², à dimensions de modèle constantes.
Un texte deux fois plus long peut ainsi demander environ quatre fois plus de comparaisons dans cette partie du calcul. Cela contribue au coût du traitement des contextes très longs.
Des techniques comme FlashAttention accélèrent cette opération en réduisant les échanges avec la mémoire du GPU et en évitant de stocker toute la matrice des poids d’attention. Elles conservent une attention exacte : le coût arithmétique reste quadratique, même si l’exécution devient plus efficace et la consommation de mémoire diminue.
Ces contraintes expliquent aussi pourquoi les autres architectures restent utiles. Dans un entretien publié par Alura en 2025, le chercheur Anderson Rocha évoque le choix de RNN ou de LSTM adaptés pour certaines tâches sur des appareils aux ressources limitées. Sur un téléphone ou une montre connectée, le meilleur modèle dépend aussi du matériel disponible et de la possibilité de communiquer avec le cloud.
L’attention nous montre-t-elle ce que « pense » l’IA ?
Les poids d’attention peuvent être visualisés. On peut ainsi observer qu’une position accorde davantage de poids à certaines autres positions du texte. Cela aide à étudier le comportement du modèle, mais il faut éviter d’en tirer des conclusions trop simples.
Un poids d’attention élevé ne signifie pas nécessairement : « voilà la raison pour laquelle l’intelligence artificielle a pris cette décision ». Le résultat provient de nombreuses couches, de très nombreux paramètres et d’une succession de transformations. L’attention permet d’observer une partie de la circulation de l’information, mais elle ne constitue pas à elle seule une explication complète du fonctionnement du modèle.
Une idée simple au cœur de machines immenses
Les Transformers peuvent comporter des dizaines de couches et des milliards de paramètres. Pourtant, l’intuition qui a rendu cette architecture célèbre reste accessible : pour représenter un élément, utilisons les relations qu’il entretient avec les autres.
Un mot change de sens selon son contexte. Une phrase peut dépendre d’une information écrite plusieurs lignes auparavant. Dans une image, une zone prend son sens en relation avec les autres. Le Transformer fournit une mécanique mathématique permettant d’exploiter ces relations à grande échelle.
Cela ne suffit pas à assimiler son fonctionnement à la compréhension humaine. Mais le modèle peut apprendre, à partir d’un très grand nombre d’exemples, quelles relations sont utiles pour accomplir une tâche. Présentée en 2017 pour améliorer la traduction automatique, cette architecture est devenue une composante majeure de l’intelligence artificielle générative.
Le chemin qui mène de cette architecture à ChatGPT est raconté plus largement dans notre article consacré à l’histoire des chatbots, d’ELIZA à ChatGPT.
Sources principales
- Ashish Vaswani et al., Attention Is All You Need, 2017.
- Dzmitry Bahdanau, Kyunghyun Cho et Yoshua Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, 2014.
- Alec Radford et al., Improving Language Understanding by Generative Pre-Training, 2018.
- Jacob Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2018.
- Ilya Sutskever, entretien avec Lex Fridman, épisode 94, 8 mai 2020, notamment le passage sur le Transformer vers 1 h 01–1 h 03.
- Tri Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, 2022.
- Anderson Rocha, entretien avec Alura, épisode 132, 26 mars 2025, notamment le passage sur les contraintes matérielles vers 8–9 minutes.