Histoire du Web : comment Tim Berners-Lee a inventé le WWW au CERN
En 1989, Internet existe déjà. Des chercheurs échangent des courriels, transfèrent des fichiers et utilisent des ordinateurs à distance. Pourtant, passer simplement d’un document à un autre reste compliqué.
Au CERN, près de Genève, Tim Berners-Lee imagine une solution : relier des informations conservées sur différentes machines. Son projet donnera naissance au World Wide Web (WWW).
L’histoire du Web commence donc dans un laboratoire de physique. Comment un outil conçu pour les scientifiques est-il devenu un moyen universel de publier et de consulter des informations ?
Internet avant le Web : un réseau sans pages Web
Internet et le Web sont souvent confondus. Pourtant, ils ne désignent pas la même chose.
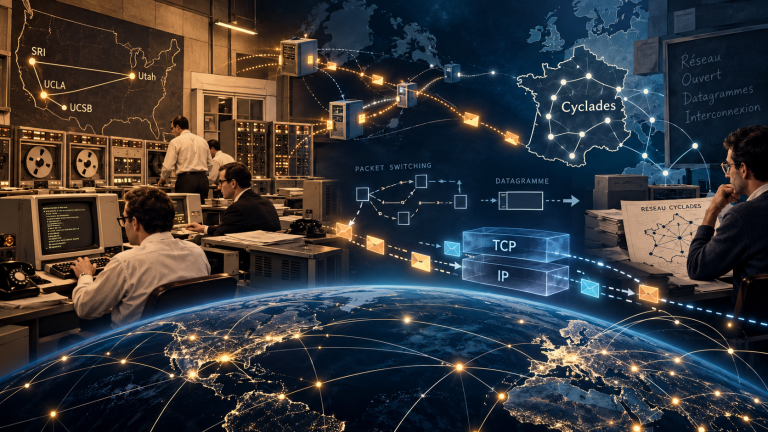
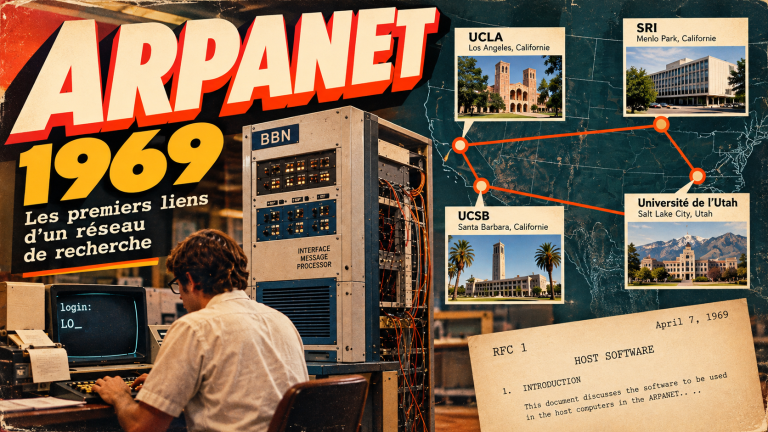
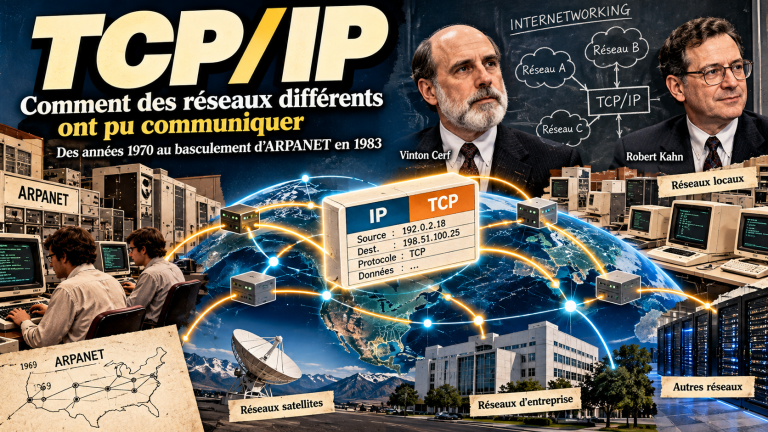
Internet est un ensemble de réseaux informatiques interconnectés. Son développement passe notamment par ARPANET, lancé en 1969, puis par les protocoles TCP/IP. Le courrier électronique et le transfert de fichiers existaient bien avant les pages Web.
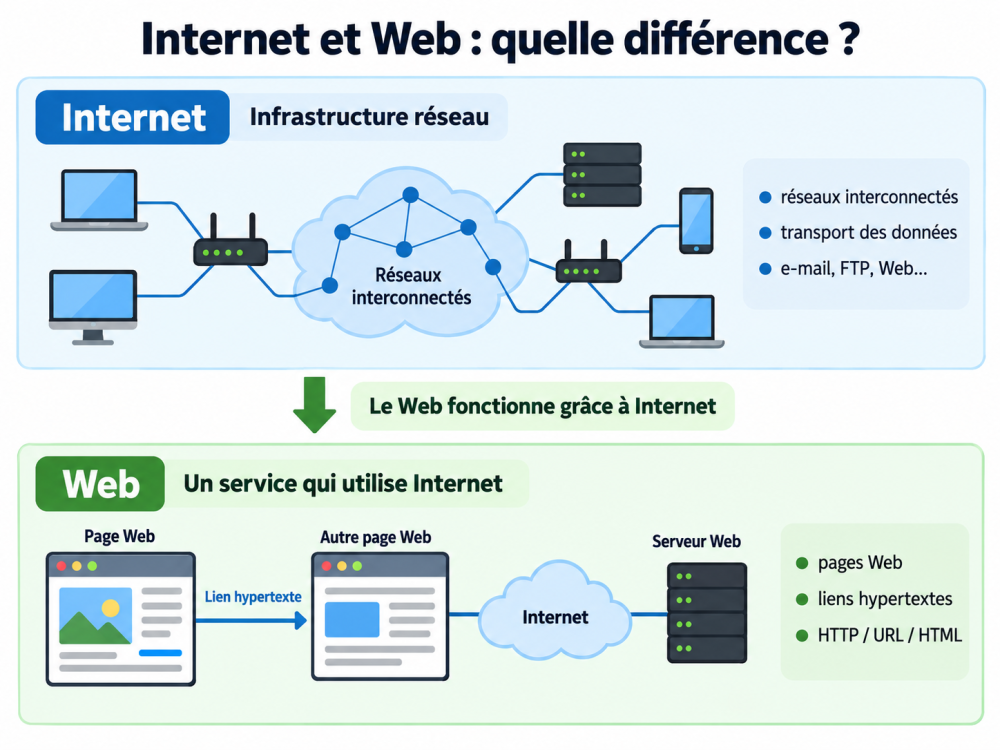
En revanche, le Web utilise Internet pour donner accès à des documents reliés par des liens hypertextes. Cliquer sur un lien permet de consulter une autre ressource, parfois hébergée à l’autre bout du monde.
Tim Berners-Lee a donc inventé le Web, pas Internet. L’histoire du réseau lui-même fait l’objet de notre article sur ARPANET, Cyclades et la naissance d’Internet.
En France, le Minitel illustre déjà l’intérêt des services consultables à distance. Toutefois, il utilise un réseau et une organisation différents. Le Web propose une autre approche : chaque organisme peut publier ses documents et créer des liens vers ceux des autres.
1989 : au CERN, un problème de partage documentaire
À la fin des années 1980, le CERN réunit des équipes scientifiques internationales. Elles produisent des rapports, des notices techniques, des résultats d’expériences et des annuaires.
Or, ces informations sont dispersées entre plusieurs ordinateurs et logiciels. Retrouver un document impose parfois de changer de machine ou de connaître des commandes particulières.
Imaginons un chercheur lisant la notice d’un programme. Pour retrouver le rapport qu’elle mentionne, il doit quitter son application, chercher un autre serveur et recommencer sa recherche. Les données existent, mais leurs relations sont difficiles à suivre.
En mars 1989, Berners-Lee propose une solution dans Information Management: A Proposal. Son idée consiste à relier les documents par des références directement consultables.
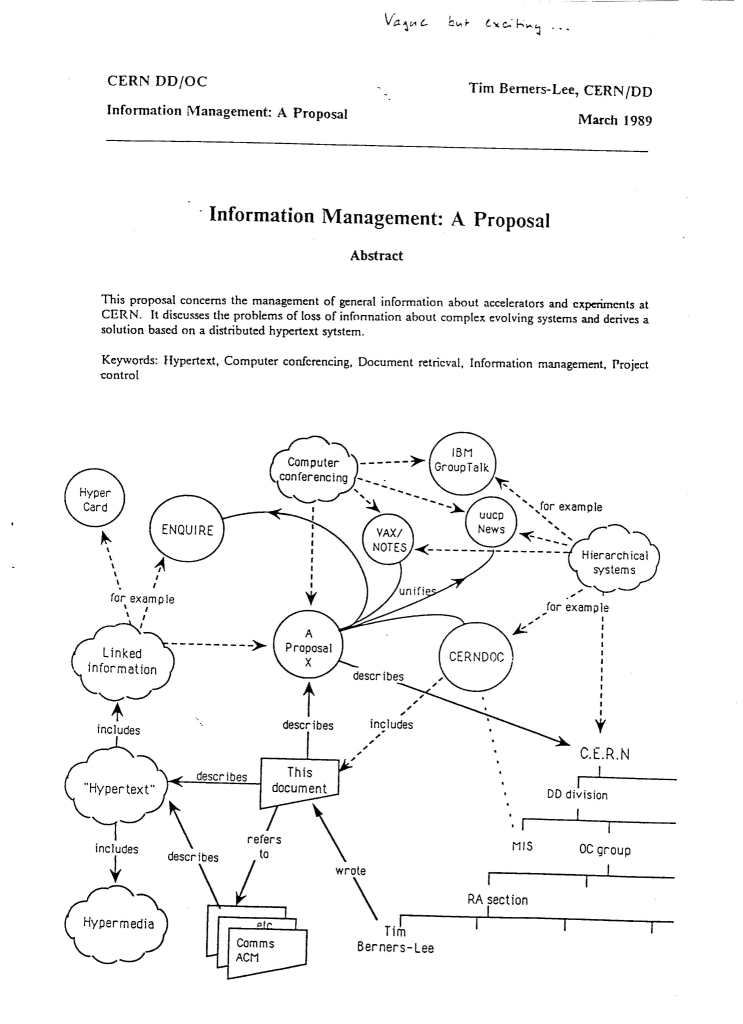
Source : archives du CERN.
Ce principe s’appelle l’hypertexte : des liens permettent de naviguer entre des informations associées. Il n’est pas nouveau : Vannevar Bush, Douglas Engelbart et Ted Nelson avaient déjà exploré des idées voisines.
L’apport de Berners-Lee est de combiner l’hypertexte et les réseaux. Les documents pourront ainsi se trouver sur des ordinateurs différents. Son responsable, Mike Sendall, juge la proposition « vague, mais prometteuse ». L’expérimentation peut commencer.
Robert Cailliau, un acteur essentiel
En 1990, l’ingénieur belge Robert Cailliau rejoint à son tour le projet. Il aide à le formaliser et à le défendre au CERN.
Le 12 novembre 1990, les deux hommes signent une proposition commune : WorldWideWeb: Proposal for a HyperText Project. Cailliau contribuera ensuite à promouvoir le Web. Il sera notamment à l’initiative de sa première conférence internationale, organisée en 1994.
Berners-Lee reste l’inventeur du Web. Sa réussite doit néanmoins beaucoup aux collaborations nouées autour de cette idée.
1990 : le NeXT, HTML, HTTP et les URL
Encore faut-il transformer le projet en logiciels utilisables. À l’automne 1990, Tim Berners-Lee utilise au CERN une station de travail NeXT, un ordinateur haut de gamme au boîtier cubique noir, conçu par l’entreprise fondée par Steve Jobs en 1985. Cette machine fonctionne sous NeXTSTEP, un système d’exploitation de type UNIX doté d’une interface graphique et d’outils de programmation avancés.
Cet environnement graphique facilite le développement. Ainsi, avant la fin de l’année, Berners-Lee fait fonctionner un serveur et un navigateur-éditeur Web. Trois mécanismes complémentaires rendent leur dialogue possible.
HTML : structurer une page
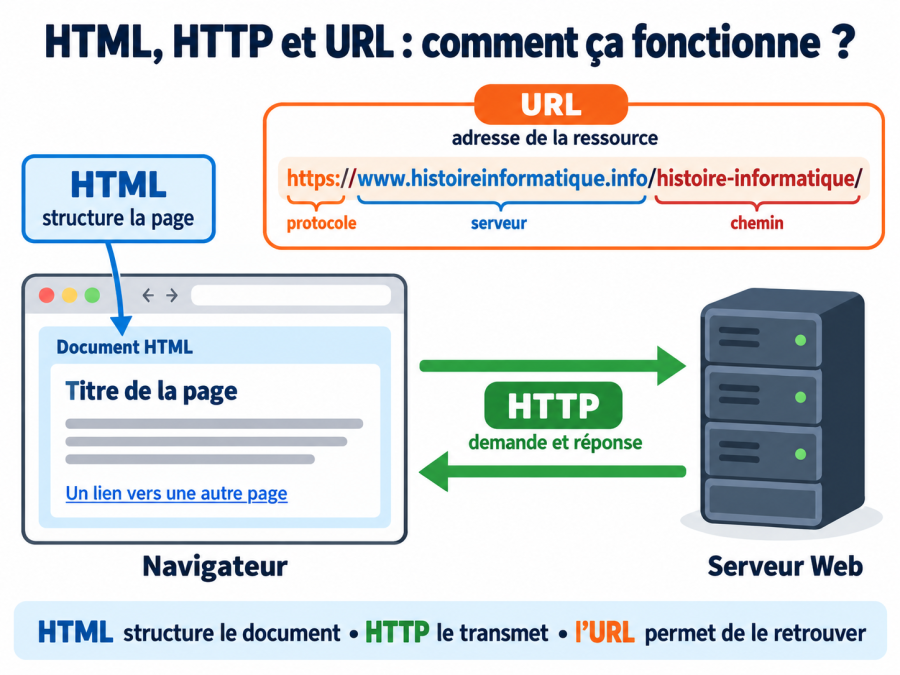
Le HTML (HyperText Markup Language) décrit le contenu d’un document. Il permet notamment de signaler les titres, les paragraphes et les liens.
Ensuite, le navigateur interprète ces indications pour afficher une page. À l’origine, l’objectif est surtout de partager de l’information, pas de créer des mises en page spectaculaires.
HTTP : demander et recevoir un document
Le HTTP (HyperText Transfer Protocol) organise la communication entre le navigateur et le serveur.
Concrètement, le navigateur envoie une requête. Le serveur lui répond en transmettant la ressource demandée. Ce dialogue s’appuie sur Internet, dont les protocoles sont expliqués dans notre histoire de TCP/IP.
URL : une adresse pour chaque ressource
Enfin, une URL (Uniform Resource Locator) indique où trouver une ressource et comment y accéder.
Dans https://www.histoireinformatique.info/histoire-informatique/, on distingue notamment le protocole, le serveur et le chemin d’accès.
Lorsqu’un internaute clique sur un lien, son navigateur utilise l’URL pour identifier la ressource demandée. Il envoie alors une requête HTTP au serveur. Celui-ci peut répondre en transmettant un document HTML, que le navigateur interprète pour afficher la page.
En résumé : HTML structure les documents, HTTP définit les règles de communication entre navigateur et serveur, et les URL permettent de localiser les ressources. Cette association constitue le socle du premier Web, qui s’appuie sur les protocoles d’Internet pour faire circuler les informations.
Le premier navigateur et le premier site Web
Berners-Lee nomme son premier navigateur WorldWideWeb. Il sera ensuite rebaptisé Nexus pour le distinguer du projet lui-même.
Contrairement à une idée répandue, ce navigateur possède déjà une interface graphique. Sur NeXT, ses utilisateurs peuvent cliquer sur les liens. Ils peuvent même modifier des documents directement dans le logiciel.
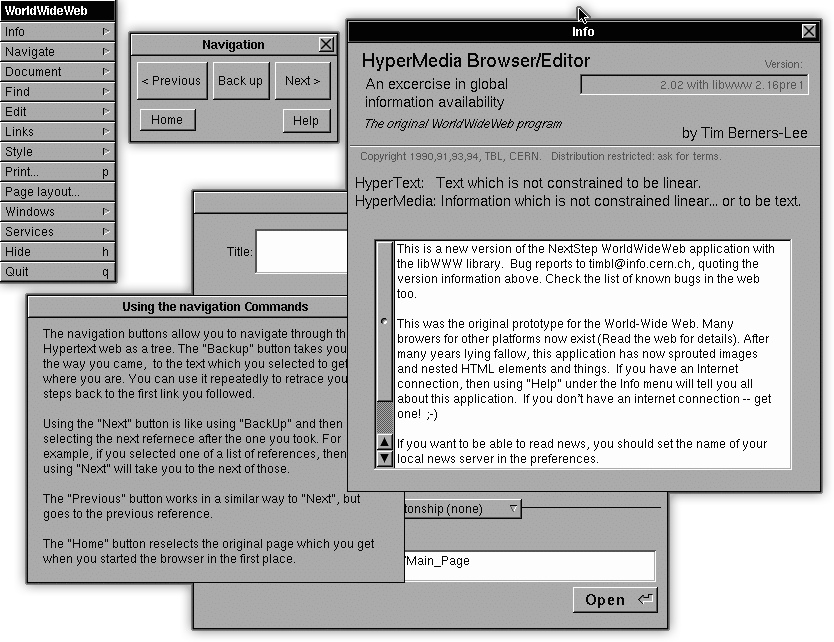
Le problème est que les ordinateurs NeXT restent peu répandus et coûteux. Pour rendre le Web accessible à davantage de chercheurs, Nicola Pellow, étudiante en stage au CERN, développe dès la fin de 1990 un navigateur beaucoup plus simple : le Line Mode Browser.
Contrairement au navigateur graphique de Berners-Lee, celui-ci fonctionne entièrement en mode texte. Il n’affiche ni images ni boutons et ne nécessite pas de souris. Les liens hypertextes apparaissent sous forme de références numérotées : l’utilisateur saisit un numéro au clavier pour accéder au document correspondant.
Cette simplicité constitue son principal avantage. De ce fait, le logiciel peut fonctionner sur différentes familles d’ordinateurs et être utilisé depuis des terminaux textuels, y compris sur des systèmes qui ne disposent pas d’une interface graphique moderne.
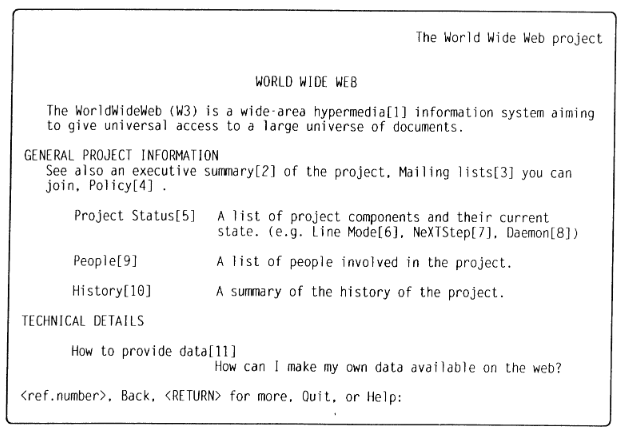
Disponible au CERN dès mars 1991, le Line Mode Browser permet ainsi à un nombre croissant de scientifiques de consulter les premières pages Web. Moins sophistiqué que le navigateur NeXT, il joue pourtant un rôle essentiel : il contribue à faire du Web un système accessible indépendamment du matériel utilisé.
info.cern.ch : le premier site Web
Parallèlement, le premier serveur Web fonctionne sur le NeXT de Berners-Lee. Son adresse est info.cern.ch.
La première page présente le projet, explique l’hypertexte et indique comment installer son propre serveur. Son adresse historique est http://info.cern.ch/hypertext/WWW/TheProject.html.
Le système fonctionne au CERN dès la fin de 1990. En mars 1991, les logiciels sont accessibles à d’autres collègues du laboratoire. Puis Berners-Lee annonce le Web sur des groupes de discussion Internet en août 1991.
En décembre, le laboratoire américain SLAC installe le premier serveur Web hors d’Europe. Le projet quitte progressivement son berceau suisse.
Bien plus tard, en 2013, le CERN a restauré une version ancienne du site. Attention : cette restitution ne doit pas être confondue avec une capture authentique de décembre 1990.
1993 : Mosaic et l’ouverture du Web
Au début des années 1990, plusieurs navigateurs apparaissent, parmi lesquels Erwise, ViolaWWW et MidasWWW. Cependant, le Web reste principalement utilisé dans les milieux scientifiques. Il faut encore rendre sa consultation plus simple et plus attrayante.
En 1993, le NCSA Mosaic apporte une réponse. Conçu au National Center for Supercomputing Applications (NCSA), à l’université de l’Illinois, notamment par Marc Andreessen et Eric Bina, ce navigateur contribue à populariser le Web.
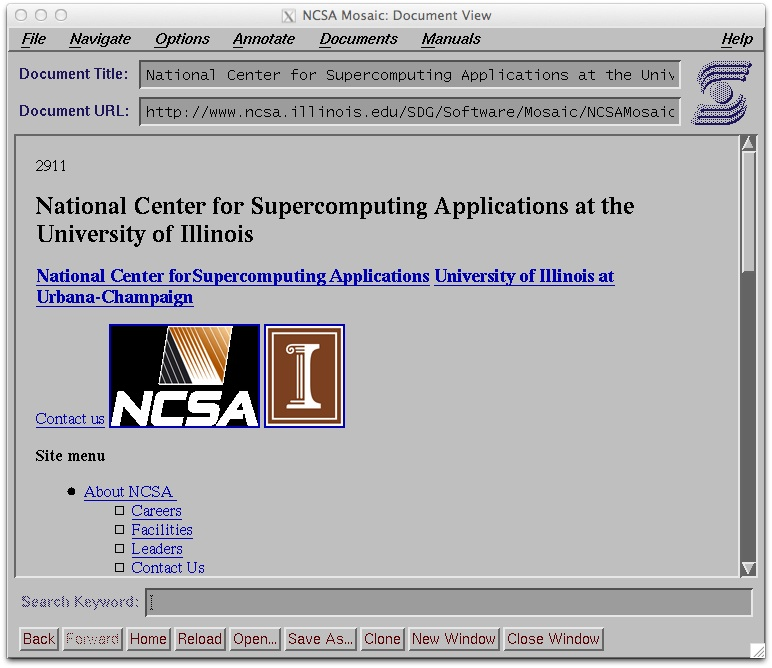
Mosaic n’est ni le premier navigateur Web ni le premier navigateur graphique : Tim Berners-Lee avait déjà créé un navigateur-éditeur graphique sur NeXT en 1990. Sa réussite tient plutôt à une interface plus facile à prendre en main. On peut suivre les liens à la souris, revenir à la page précédente et consulter l’historique sans connaître de commandes compliquées.
Surtout, Mosaic affiche les images directement dans la page, au milieu du texte. Auparavant, leur consultation exigeait souvent une manipulation ou un affichage séparé. Désormais, une page Web peut ressembler à un document illustré, mêlant titres, photographies et liens cliquables. L’intérêt du Web devient visible immédiatement, même pour un non-spécialiste.
Initialement disponible sur des stations de travail UNIX, Mosaic est également diffusé sur Macintosh et Windows en 1993. Sa relative facilité d’installation et les échanges entre ses développeurs et les premiers utilisateurs favorisent son adoption. Le Web commence ainsi à sortir des seuls laboratoires pour toucher un public bien plus large.
Mosaic n’a pas inventé le Web : il a contribué à le rendre populaire. Cette diffusion dépend cependant d’une autre condition : permettre à chacun de créer ses propres outils et ses propres serveurs sans dépendre d’un fournisseur unique.
30 avril 1993 : le CERN libère les logiciels du Web
Le 30 avril 1993, le CERN autorise gratuitement l’utilisation, la copie, la modification et la redistribution de composants essentiels du Web.
La décision concerne notamment le navigateur en mode texte, un serveur et une bibliothèque logicielle. En 1994, une version ultérieure sera distribuée sous licence libre explicite.
Cette ouverture permet à chacun de développer des outils compatibles, sans payer de redevances au CERN. Ainsi, le Web peut prospérer sans dépendre d’un fournisseur unique.
Pourquoi le Web se diffuse si rapidement
Fin 1993, on compte plus de 500 serveurs Web connus. Fin 1994, ils sont environ 10 000, selon le CERN.
Cette croissance tient d’abord à une architecture décentralisée. Une université ou une entreprise peut installer son serveur, publier des documents et créer des liens vers d’autres sites.
Elle repose également sur des technologies communes, utilisables sur plusieurs systèmes d’exploitation. Les machines UNIX, déjà présentes dans les laboratoires, participent à cette première diffusion. Retrouvez leur histoire dans notre article consacré à UNIX.
De Mosaic à Netscape : le grand public arrive
En 1994, Marc Andreessen et Jim Clark fondent l’entreprise qui deviendra Netscape Communications. Son navigateur Netscape Navigator rencontre rapidement le succès.
Progressivement, avec la multiplication des sites et le développement des accès commerciaux à Internet, le Web touche de nouveaux publics. La concurrence avec Internet Explorer marquera ensuite une autre période : celle des « guerres des navigateurs ».
1994-1995 : le W3C et la contribution française
Cette croissance soulève une nouvelle question : comment garantir qu’un site fonctionne avec différents navigateurs et systèmes d’exploitation ? Les standards communs deviennent essentiels pour éviter la fragmentation du Web.
En octobre 1994, Berners-Lee fonde le World Wide Web Consortium (W3C) au Massachusetts Institute of Technology (MIT). Sa mission est de coordonner l’élaboration de standards ouverts et de favoriser la compatibilité entre les logiciels.
La France participe rapidement à cet effort. En avril 1995, l’INRIA (Institut national de recherche en informatique et en automatique) devient le premier hôte européen du W3C, aux côtés du MIT. L’institut contribue ainsi à développer les collaborations entre chercheurs et industriels européens autour d’un Web interopérable.
Le principe reste celui qui guidait Berners-Lee dès 1989 : permettre aux informations de circuler malgré la diversité des machines et des logiciels. Le Web n’était pas né pour créer des boutiques ou des réseaux sociaux, mais avant tout pour relier des connaissances.
Cette invention a profondément transformé les usages d’Internet. Pour la replacer dans une perspective plus large, consultez notre histoire générale de l’informatique.
Sources historiques et documents
- CERN — La naissance du Web.
- CERN — A short history of the Web.
- Tim Berners-Lee — Information Management: A Proposal, mars 1989.
- Tim Berners-Lee et Robert Cailliau — WorldWideWeb: Proposal for a HyperText Project, novembre 1990.
- W3C — A Little History of the World Wide Web.
- CERN — Licensing the Web.
- Computer History Museum — Browsers: Windows on the Web.
- NCSA — université de l’Illinois — NCSA Mosaic : développement et diffusion du navigateur.
- CERN — CERN Computer Newsletter, n° 204, octobre–décembre 1991 : capture du Line Mode Browser.
- W3C — MIT and INRIA will jointly host the World Wide Web Consortium, communiqué du 7 avril 1995.