Le perceptron
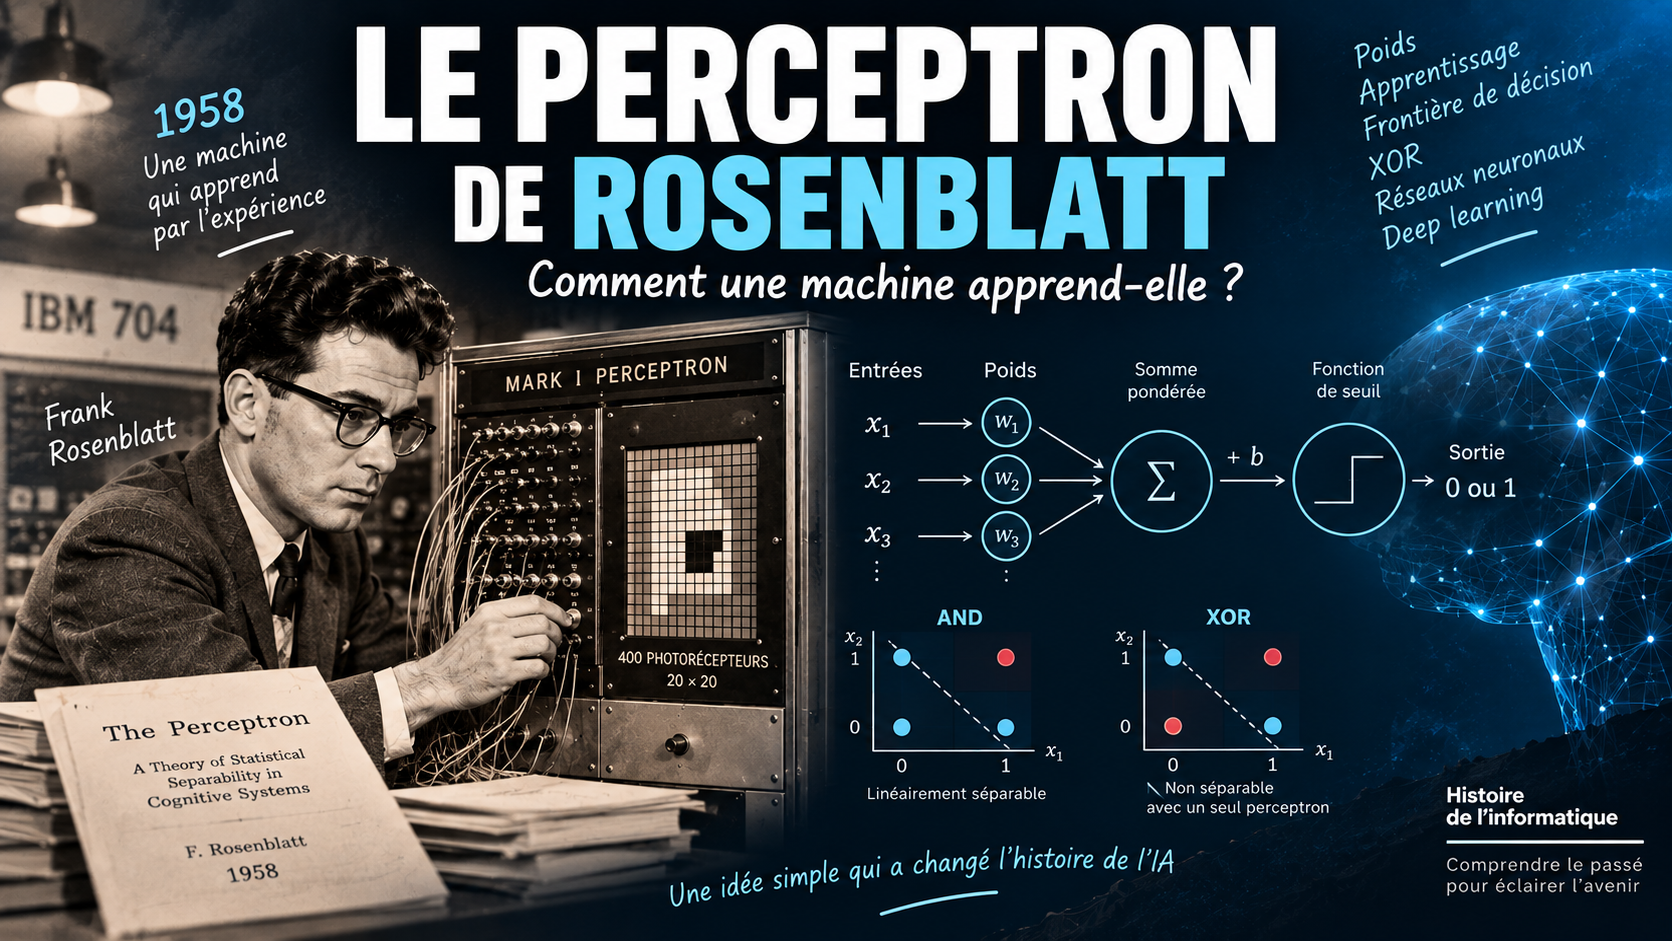
Le perceptron, imaginé par Frank Rosenblatt à la fin des années 1950, est l’un des modèles fondateurs de l’apprentissage automatique. Son principe paraît aujourd’hui presque élémentaire : recevoir plusieurs valeurs, leur attribuer des poids, les additionner puis prendre une décision. Pourtant, derrière ces quelques opérations se trouve une idée qui va profondément modifier l’histoire de l’intelligence artificielle : une machine peut apprendre en modifiant elle-même certains de ses paramètres à partir de ses erreurs.
À une époque où une grande partie des recherches cherche plutôt à reproduire le raisonnement humain grâce à des règles et à la logique, Rosenblatt explore une autre voie. Au lieu de programmer directement la solution, il propose un système capable d’ajuster son comportement à partir d’exemples. Cette opposition entre règles écrites par l’homme et connaissances acquises par apprentissage traversera toute l’histoire de l’informatique et de l’intelligence artificielle.
1958 : une machine qui apprend par l’expérience
Le contexte est important. Deux ans auparavant, le Dartmouth Summer Research Project on Artificial Intelligence avait contribué à faire de l’intelligence artificielle un domaine de recherche identifié. Parmi les ambitions de cette nouvelle discipline figurent le raisonnement, le langage, la résolution de problèmes, mais aussi la possibilité pour une machine d’apprendre.
Frank Rosenblatt, psychologue et chercheur au Cornell Aeronautical Laboratory, s’intéresse précisément à cette dernière piste. Son objectif dépasse la construction d’un simple programme de classification. Il cherche à comprendre comment un ensemble d’unités élémentaires, inspiré très librement du fonctionnement des neurones biologiques, pourrait modifier ses connexions afin d’améliorer progressivement ses réponses.
Le perceptron apparaît dans ses travaux dès 1957. En janvier 1958, Rosenblatt publie notamment The Perceptron: A Theory of Statistical Separability in Cognitive Systems. Mais c’est surtout une démonstration organisée le 7 juillet 1958 par l’Office of Naval Research qui attire l’attention du public.
Lors de cette présentation, un IBM 704 simule le fonctionnement du système et apprend à distinguer des cartes selon la position de marques placées dessus. Le lendemain, le New York Times consacre un article à cette expérience sous un titre particulièrement évocateur : New Navy Device Learns by Doing. La machine « apprend en faisant ». Pour le grand public de 1958, l’idée est spectaculaire.
Le Mark I Perceptron : l’apprentissage devient une machine
Il faut toutefois distinguer cette première démonstration du véritable Mark I Perceptron, construit ensuite comme une machine spécialisée. Rosenblatt ne souhaite pas seulement simuler son modèle sur un ordinateur conventionnel : il veut également en expérimenter une réalisation physique.
Le Mark I possède notamment une sorte de rétine composée de 20 × 20 photorécepteurs, soit 400 points sensibles à la lumière. Des connexions relient ces entrées à d’autres unités et certains paramètres peuvent être modifiés pendant l’apprentissage. Des dispositifs électromécaniques servent même à matérialiser une partie des poids ajustables.
Vu depuis 2026, l’ensemble paraît rudimentaire. Pourtant, le principe est déjà remarquable : le comportement de la machine ne dépend plus uniquement d’une succession d’instructions explicitement écrites à l’avance. Une partie de ce comportement résulte des valeurs acquises pendant l’apprentissage.
Le perceptron historique était plus complexe que notre schéma
Aujourd’hui, lorsqu’on explique le perceptron en machine learning, on le représente généralement sous une forme très simple :
x1 ──w1──┐
x2 ──w2──┼──► somme ──► seuil ──► sortie
x3 ──w3──┘
Cette représentation est excellente pour comprendre son fonctionnement mathématique, mais elle simplifie fortement les systèmes étudiés par Rosenblatt. Ses modèles distinguent notamment des unités sensorielles, des unités d’association et des unités de réponse.
Le perceptron que nous allons maintenant étudier est donc surtout le classificateur linéaire qui est aujourd’hui enseigné sous ce nom. Il permet de comprendre avec quelques équations l’idée essentielle : des entrées sont combinées à l’aide de poids, et ces poids peuvent être modifiés par apprentissage.
Comment fonctionne un perceptron ?
Imaginons un perceptron recevant trois valeurs :
x1
x2
x3
À chacune correspond un nombre appelé poids :
w1
w2
w3
Le système multiplie chaque entrée par son poids puis additionne les résultats. Il ajoute également une valeur supplémentaire appelée biais, ou bias :
z = w1x1 + w2x2 + w3x3 + b
Avec un nombre quelconque d’entrées, on peut écrire plus simplement :
z = w · x + b
Le terme w · x est le produit scalaire du vecteur des poids par celui des entrées.
Le perceptron applique ensuite une fonction de seuil. Dans sa forme la plus simple :
si z ≥ 0
    sortie = 1
sinon
    sortie = 0
En quelques multiplications et une addition, plusieurs valeurs sont ainsi transformées en une décision binaire.
Les poids : ce que la machine va apprendre
Les poids déterminent l’influence de chaque entrée sur la décision. Imaginons, de manière très simplifiée, que trois entrées correspondent à des caractéristiques détectées dans une image :
x1 = présence d'un contour vertical
x2 = présence d'une zone sombre
x3 = présence d'une forme ronde
Le perceptron pourrait posséder :
w1 = 0,7
w2 = -0,3
w3 = 1,1
La troisième caractéristique contribue alors davantage à une décision positive. La deuxième agit au contraire dans l’autre sens.
Si un programmeur choisissait lui-même toutes ces valeurs, nous resterions proches d’une programmation classique. L’intérêt du perceptron apparaît lorsque la machine corrige automatiquement ses poids à partir des exemples qu’on lui présente.
C’est ici que se produit le changement essentiel : le programmeur définit le mécanisme d’apprentissage, mais il ne fixe plus directement tous les paramètres qui produiront la décision finale.
Un exemple : apprendre la fonction AND
Prenons une fonction très simple, la porte logique AND. Elle doit produire 1 uniquement lorsque ses deux entrées valent 1 :
x1    x2    sortie attendue

0     0           0
0     1           0
1     0           0
1     1           1
Supposons que les poids et le biais aient finalement les valeurs suivantes :
w1 = 1
w2 = 1
b  = -1,5
Pour :
x1 = 0
x2 = 1
le calcul donne :
z = (0 × 1) + (1 × 1) - 1,5
z = -0,5
Le résultat est négatif. La sortie vaut donc 0.
Avec :
x1 = 1
x2 = 1
nous obtenons :
z = (1 × 1) + (1 × 1) - 1,5
z = 0,5
Cette fois, le résultat est positif et la sortie vaut 1. Ces paramètres permettent donc de reproduire correctement la fonction AND.
Mais nous venons de choisir les poids nous-mêmes. Le véritable intérêt du perceptron consiste précisément à pouvoir les découvrir par apprentissage.
Comment le perceptron apprend-il ?
Le principe est simple. On présente au perceptron un exemple dont on connaît déjà la bonne réponse. Il effectue son calcul, produit une prédiction puis compare cette prédiction avec la classe attendue.
Lorsqu’il se trompe, ses poids sont modifiés.
Avec des classes représentées par -1 et +1, une écriture classique de la règle de mise à jour est :
w ← w + η y x
et pour le biais :
b ← b + η y
Dans cette notation, x est le vecteur contenant les entrées, y représente la classe correcte et η, la lettre grecque êta, désigne le taux d’apprentissage.
Le processus peut être résumé ainsi :
exemple
   ↓
calcul
   ↓
prédiction
   ↓
comparaison avec la réponse attendue
   ↓
erreur ?
   ↓
correction des poids
   ↓
exemple suivant
Il n’y a donc aucune magie dans l’apprentissage. La machine produit une réponse, son erreur indique dans quelle direction certains paramètres doivent être déplacés, puis l’opération recommence avec d’autres exemples.
Cette idée — améliorer un modèle en ajustant progressivement ses paramètres — deviendra l’un des principes fondamentaux du machine learning.
Ce que le perceptron apprend réellement
Avec seulement deux entrées, nous pouvons représenter chaque exemple comme un point dans un plan :
(x1, x2)
Or l’équation :
w1x1 + w2x2 + b = 0
correspond à une droite.
Cette droite divise le plan en deux régions. D’un côté, le perceptron prédit une classe ; de l’autre, il prédit la seconde.
L’apprentissage consiste donc, géométriquement, à déplacer cette frontière jusqu’à séparer correctement les exemples.
Avec trois variables, la frontière devient un plan. Avec quatre, cent ou mille variables, nous ne pouvons plus la dessiner facilement, mais le principe reste identique. On parle alors d’un hyperplan.
C’est pour cette raison que le perceptron simple est qualifié de classificateur linéaire.
Le théorème de convergence
Ce mécanisme très simple possède une propriété mathématique remarquable. Si les deux catégories que nous voulons apprendre sont réellement séparables par un hyperplan, alors l’algorithme du perceptron finit par trouver une séparation après un nombre fini de corrections.
C’est le théorème de convergence du perceptron.
Cette propriété donne une base théorique solide à l’algorithme. Dans certaines conditions, l’apprentissage ne fonctionne pas seulement parce qu’on l’observe expérimentalement : on peut démontrer qu’il convergera vers une solution.
Mais la condition est capitale : il faut qu’une séparation linéaire existe.
Et cette limite va devenir célèbre.
XOR : quatre points suffisent pour mettre le perceptron en difficulté
Prenons maintenant l’opération logique XOR, le « ou exclusif » :
x1    x2    XOR

0     0      0
0     1      1
1     0      1
1     1      0
Dans un plan, les points appartenant aux deux catégories se trouvent en diagonale. Il faudrait séparer :
(0,0) et (1,1)
de :
(0,1) et (1,0)
Or aucune droite unique ne peut réaliser cette séparation.
On pourrait entraîner le perceptron pendant une heure, un mois ou un siècle : il ne trouverait toujours pas les bons poids.
La raison est fondamentale : il n’existe aucun jeu de poids permettant à un perceptron linéaire unique de représenter XOR.
Le problème ne vient donc ni d’un manque de données ni d’un ordinateur trop lent. Il vient directement de l’architecture du modèle.
1969 : Minsky et Papert examinent les limites
En 1969, Marvin Minsky et Seymour Papert publient Perceptrons: An Introduction to Computational Geometry. Minsky est alors l’une des grandes figures de la recherche en intelligence artificielle menée notamment au MIT. Leur ouvrage analyse mathématiquement les capacités et les limites de certaines classes de perceptrons.
Cette période est parfois racontée de manière trop simple : Minsky et Papert auraient démontré que « les réseaux neuronaux ne fonctionnent pas », ce qui aurait immédiatement provoqué leur abandon. La réalité est plus nuancée.
Le perceptron monocouche possède effectivement d’importantes limitations, dont l’impossibilité de résoudre certaines classifications non linéaires. Mais des réseaux comportant plusieurs couches peuvent représenter des fonctions beaucoup plus complexes. Le véritable problème des années 1960 et 1970 est aussi pratique : entraîner efficacement ces réseaux reste difficile et la puissance de calcul disponible est minuscule comparée à celle dont disposeront les chercheurs plusieurs décennies plus tard.
L’enthousiasme initial avait également été considérable. Dès 1958, certaines projections imaginent des machines capables de reconnaître des personnes, de parler ou de traduire. Le décalage entre ces espoirs et les capacités réellement disponibles participe lui aussi au reflux de l’intérêt.
Pourquoi plusieurs couches changent-elles la situation ?
Un perceptron simple ne peut construire qu’une séparation linéaire. Mais il est possible de combiner plusieurs unités :
entrées
   ↓
couche cachée
   ↓
couche cachée
   ↓
sortie
Chaque couche effectue une transformation des informations qu’elle reçoit. En combinant plusieurs transformations simples, le réseau peut finalement représenter des relations qui ne sont plus linéaires.
XOR, impossible pour un perceptron unique, devient alors soluble avec un petit réseau comportant une couche intermédiaire.
Mais cette solution fait apparaître un nouveau problème. Lorsque la sortie finale est fausse, comment savoir quelles connexions situées dans les couches précédentes doivent être modifiées ?
De la règle du perceptron à la rétropropagation
Avec un perceptron simple, les poids sont directement reliés à la sortie. La correction est donc relativement facile.
Dans un réseau multicouche, l’erreur finale dépend de nombreux paramètres répartis dans plusieurs niveaux. Il faut pouvoir déterminer dans quelle mesure chacun d’eux a contribué au résultat.
La rétropropagation du gradient permet justement de calculer cette influence en remontant mathématiquement depuis l’erreur finale vers les couches précédentes. Une méthode d’optimisation peut ensuite ajuster les poids.
En 1986, David Rumelhart, Geoffrey Hinton et Ronald Williams publient un article devenu emblématique de cette renaissance des réseaux multicouches. Les unités cachées peuvent apprendre des représentations intermédiaires utiles au problème au lieu que le programmeur doive définir lui-même toutes les caractéristiques pertinentes.
Le mécanisme général devient :
entrée
   ↓
calcul du réseau
   ↓
prédiction
   ↓
mesure de l'erreur
   ↓
calcul des gradients
   ↑
rétropropagation
   ↑
modification des poids
La règle utilisée par le perceptron et la rétropropagation ne sont pas identiques. Elles appartiennent cependant à la même idée générale : faire évoluer les paramètres du modèle à partir de l’écart entre ce qu’il produit et ce que l’on souhaite obtenir.
Le neurone moderne n’est plus exactement un perceptron
Le perceptron classique produit une décision brutale :
0 ou 1
Sa fonction de seuil convient parfaitement à son fonctionnement, mais elle ne permet pas d’utiliser directement les méthodes de descente de gradient employées dans les réseaux neuronaux modernes.
Les réseaux actuels utilisent donc d’autres fonctions d’activation, comme ReLU ou GELU selon les architectures.
La structure générale reste pourtant familière :
entrées
   ↓
poids
   ↓
somme pondérée
   ↓
biais
   ↓
fonction d'activation
   ↓
sortie
Le neurone artificiel moderne n’est donc pas simplement le perceptron de Rosenblatt reproduit des milliards de fois. Mais on reconnaît clairement une partie de son héritage conceptuel.
Du perceptron au deep learning
Entre le Mark I Perceptron et les réseaux neuronaux contemporains se trouvent plus de soixante années de recherches, d’échecs, de nouvelles architectures et surtout une augmentation extraordinaire des données et de la puissance de calcul.
Un modèle actuel peut comporter des millions ou des milliards de paramètres. Les réseaux profonds apprennent également des représentations intermédiaires extrêmement complexes. Dans un système de vision, par exemple, des couches successives peuvent devenir sensibles à des motifs locaux, puis à des structures plus élaborées. Cette approche est très éloignée du classificateur linéaire de Rosenblatt, mais elle conserve une intuition essentielle : une partie du comportement de la machine émerge des paramètres appris à partir des données.
C’est précisément ce qui rend le perceptron si intéressant dans l’histoire de l’IA. Il se situe au début d’une tradition différente de celle qui consiste à programmer explicitement toutes les règles du raisonnement.
Pourquoi le perceptron reste-t-il important ?
Le perceptron est aujourd’hui un modèle extrêmement simple. Il ne pourrait évidemment pas, à lui seul, reconnaître des millions d’images, traduire une langue ou produire un texte comparable à celui des systèmes d’IA actuels.
Sa véritable importance se trouve ailleurs.
Dans une programmation traditionnelle, on peut résumer la situation ainsi :
programmeur
    ↓
écrit les règles
    ↓
machine
    ↓
résultat
Avec l’apprentissage :
programmeur
    ↓
définit un mécanisme d'apprentissage
    ↓
données + erreurs
    ↓
ajustement des paramètres
    ↓
comportement appris
Le changement est considérable.
La question n’est plus seulement :
« Quelles règles devons-nous programmer ? »
Elle devient aussi :
« Comment construire une machine capable de découvrir elle-même les paramètres qui lui permettront de résoudre le problème ? »
Le Mark I de Rosenblatt et les modèles actuels n’ont évidemment plus la même échelle. Pourtant, lorsque les réseaux neuronaux modernes ajustent aujourd’hui leurs paramètres pendant l’entraînement, ils prolongent une idée qui faisait déjà toute l’originalité du perceptron : une machine peut améliorer son comportement en transformant ses connexions à partir de l’expérience.