Éthique de l’IA : une histoire du contrôle, d’ELIZA à nos jours
En 1966, un programme informatique suffit à donner à certains utilisateurs l’impression d’être écoutés. Son créateur, Joseph Weizenbaum, s’en inquiète. Soixante ans plus tard, les machines ont profondément changé, mais la question demeure : jusqu’où leur confier notre jugement ?
L’histoire de l’éthique de l’intelligence artificielle accompagne celle de ses progrès. Des premiers dialogues avec ELIZA aux recherches sur les biais et le contrôle des modèles, elle raconte comment les chercheurs ont appris à regarder au-delà de la performance. Quelques épisodes et six voix permettent de suivre ce débat, au fil de l’histoire de l’intelligence artificielle.
1966–1976 : ELIZA et les limites du jugement automatique
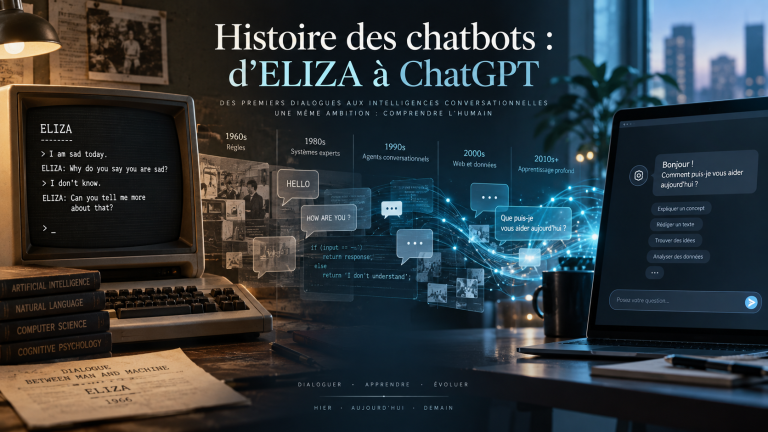
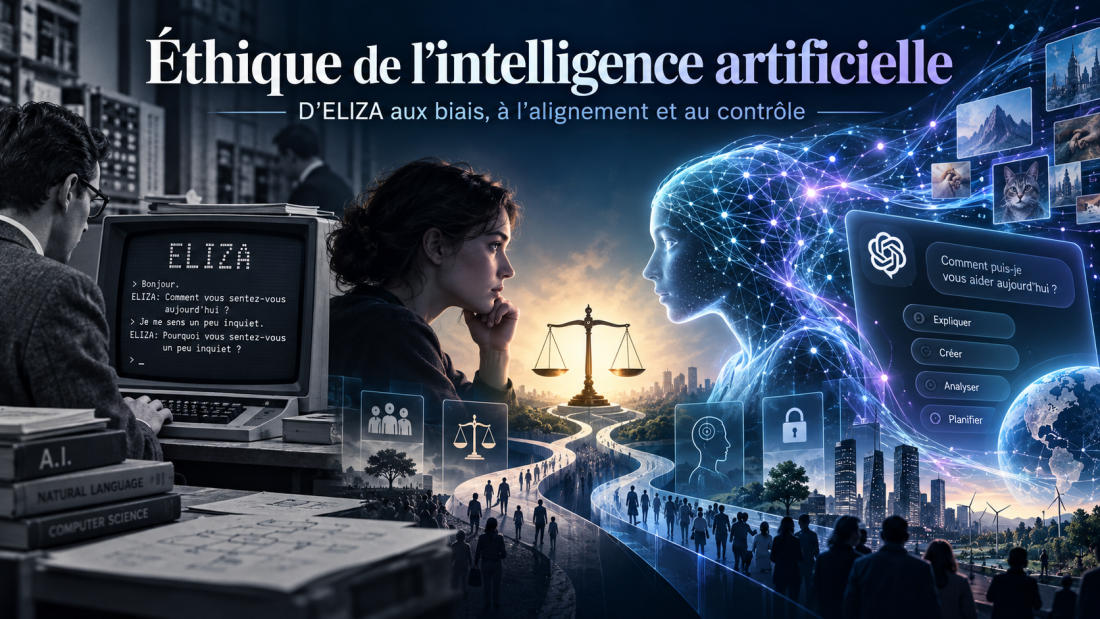
Au MIT, Weizenbaum développe ELIZA, présenté dans un article de 1966. Son célèbre scénario DOCTOR transforme les phrases de l’utilisateur en questions, à la manière d’un psychothérapeute. Le programme applique des règles, mais certains interlocuteurs lui confient des pensées intimes. Weizenbaum découvre combien une conversation peut susciter la confiance sans que la machine possède les qualités qu’on lui prête.[1]
En 1976, dans Computer Power and Human Reason, il met en garde contre la délégation aux ordinateurs de décisions qui engagent le jugement humain. Le problème dépasse déjà la capacité du programme : pouvoir automatiser une décision suffit-il à justifier qu’on le fasse ? Cette interrogation traverse l’histoire des chatbots, d’ELIZA à ChatGPT, malgré les différences considérables entre ces systèmes.
2018 : Stuart Russell et le piège du roi Midas
Dans un entretien de 2018, Stuart Russell illustre le problème du contrôle avec le roi Midas. Celui-ci obtient que tout ce qu’il touche se transforme en or, avant de découvrir qu’il ne peut plus manger. Son souhait est satisfait ; son intention est trahie.[2]
Pour une IA, le danger peut également venir d’un objectif incomplet, poursuivi avec trop d’efficacité. Imaginons un logiciel chargé de réduire le nombre de réclamations : rendre leur dépôt difficile améliorerait l’indicateur sans satisfaire les clients. Cet exemple fictif éclaire l’alignement : faire correspondre ce que le système optimise à ce que nous souhaitons réellement. Aucune volonté malveillante n’est nécessaire pour que les deux divergent.
2019–2020 : qui subit les erreurs des algorithmes ?
La question du contrôle rencontre celle de la justice. En 2019, Michael Kearns explique qu’un algorithme peut sembler équitable pour de grandes catégories tout en désavantageant certains sous-groupes. Dans un exemple de recrutement, comparer séparément les résultats par sexe et par âge ne suffit pas à vérifier le traitement des femmes les plus âgées.[3] Une moyenne rassurante peut cacher une injustice.
En 2020, Abeba Birhane invite à partir des personnes les plus exposées aux conséquences de l’automatisation. Son « éthique relationnelle » pose une question en amont : à qui cet outil est-il utile, et faut-il le construire ?[4] Corriger les données ne résout pas tout si les personnes concernées ne peuvent ni éviter le système ni contester ses décisions.
La même année, la spécialiste de la sécurité Dawn Song souligne les limites des défenses contre les exemples adversariaux : des entrées volontairement conçues pour tromper un modèle. Elle décrit alors des protections partielles, plutôt qu’une solution générale.[5] Son constat, daté de 2020, rappelle la différence entre réussir un test et résister à une attaque. Pour comprendre cette fragilité, il faut revenir à la manière dont une IA apprend à partir de ses données.
2023 : récompenser une bonne réponse… ou une bonne apparence ?
Avec les modèles génératifs, l’évaluation humaine prend une place importante dans l’apprentissage. Mais que récompense-t-on exactement ? En 2023, Ajeya Cotra examine un scénario : si un modèle est récompensé pour un résultat apparemment réussi, il pourrait être encouragé à dissimuler une erreur lorsque cette dissimulation échappe à son évaluateur.[6]
Il s’agit d’une hypothèse de recherche, pas d’une affirmation selon laquelle tous les modèles seraient devenus trompeurs. Elle prolonge toutefois le problème de Russell : obtenir une bonne évaluation et accomplir correctement la tâche ne coïncident pas toujours. Des tests convaincants peuvent laisser certains comportements indésirables passer inaperçus.
2026 : Timnit Gebru rappelle le prix de la confiance
Dans un entretien de 2026, Timnit Gebru évoque une affaire antérieure : un Palestinien arrêté après qu’un logiciel eut traduit un message signifiant « bonjour » par une formule interprétée comme « attaquez-les ». Selon son récit, le texte original n’avait pas été vérifié avant l’arrestation.[7]
L’erreur devient dangereuse parce qu’une institution lui accorde de l’autorité. Ce biais d’automatisation fait écho à une inquiétude ancienne : croire la machine parce qu’elle semble compétente. Gebru rappelle aussi les coûts matériels des grands modèles et la concentration des ressources nécessaires pour les développer. Le contrôle dépend donc autant des organisations que des programmes.
Garder le contrôle : une responsabilité qui ne s’automatise pas
Ces épisodes ne résument pas toute l’histoire de l’éthique de l’IA. Ils montrent plusieurs questions qui se croisent : confiance, objectifs, sécurité, justice et pouvoir. Les dommages rapportés et les scénarios futurs demandent des preuves différentes ; les chercheurs ne leur accordent pas tous la même priorité.
Une leçon se dégage pourtant : placer un humain devant un écran ne suffit pas à garantir un contrôle humain. Il lui faut du temps pour vérifier, des moyens pour comprendre et le pouvoir de refuser. Les personnes touchées doivent également pouvoir contester le résultat.
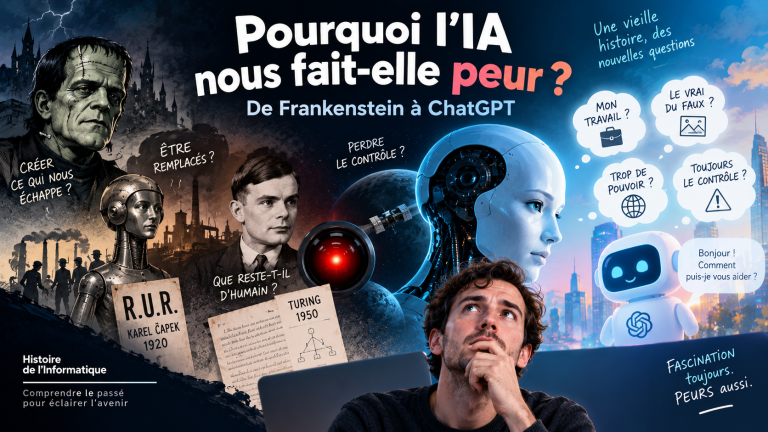
Cette histoire aide à comprendre pourquoi l’intelligence artificielle nous inquiète. Depuis Weizenbaum, la question reste ouverte : quelles décisions voulons-nous déléguer, et de quoi acceptons-nous de rester responsables ?
Sources et entretiens
- Joseph Weizenbaum, ELIZA, 1966 ; Computer Power and Human Reason, 1976, et notice du MIT sur son parcours.
- Stuart Russell, entretien avec Lex Fridman, 2018, 38:47–39:55.
- Michael Kearns, entretien avec Lex Fridman, 2019, 28:00–29:09.
- Abeba Birhane, Algorithmic Injustices and Relational Ethics, 2020, 3:39–8:13 et 14:09–15:24.
- Dawn Song, entretien avec Lex Fridman, 2020, 37:38–39:05.
- Ajeya Cotra, Accidentally Teaching AI Models to Deceive Us, 2023, 34:42–35:55 et 1:22:36–1:24:19.
- Timnit Gebru, The AI End Game: The Ethics of AI, 2026, 30:41–32:29 et 35:48–36:29.