
Qui a créé ChatGPT ?
Le 30 novembre 2022, OpenAI ouvre au public une version expérimentale gratuite de ChatGPT. Une simple fenêtre de conversation permet alors de poser une question, d’obtenir une réponse puis de poursuivre l’échange.
Qui a créé ChatGPT ? La réponse courte est OpenAI. Mais il n’existe pas un inventeur unique de ChatGPT. Le produit résulte de plusieurs années de recherche menées par de nombreuses équipes, chez OpenAI mais aussi ailleurs.
Pour comprendre sa naissance, il faut donc remonter quelques années en arrière. Tout commence par une nouvelle architecture conçue pour traiter le langage, puis viennent les modèles GPT, leur changement d’échelle, le travail sur les instructions et enfin l’idée d’en faire un véritable assistant conversationnel.
Les dates clés de la naissance de ChatGPT
- 2017 : Google Research présente l’architecture Transformer.
- 2018 : OpenAI publie les travaux sur le premier GPT.
- 2019 : GPT-2 améliore fortement la génération de texte.
- 2020 : GPT-3 atteint 175 milliards de paramètres.
- 2022 : InstructGPT améliore le suivi des instructions grâce aux retours humains.
- 30 novembre 2022 : OpenAI lance publiquement ChatGPT.
Qui a créé ChatGPT ?
ChatGPT a été créé par OpenAI, mais pour comprendre ce que cela signifie, il faut d’abord distinguer GPT de ChatGPT.
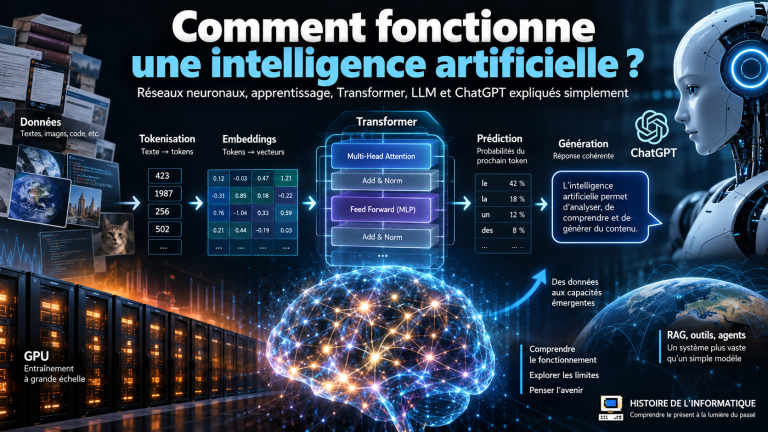
Un GPT — Generative Pre-trained Transformer — est un modèle de langage. Il apprend à partir de grandes quantités de textes à prédire quels mots ou fragments de mots ont le plus de chances de venir ensuite. À la base, il s’agit donc d’une forme très avancée de complétion de texte.
À grande échelle, cette capacité devient beaucoup plus riche. Le modèle peut rédiger, résumer, traduire, reformuler ou répondre à des questions parce qu’il a appris de nombreuses régularités du langage.
ChatGPT est autre chose : c’est un assistant conversationnel construit autour de ces modèles. OpenAI les a adaptés pour qu’ils suivent mieux les consignes, répondent sous forme de dialogue et prennent en compte les échanges précédents.
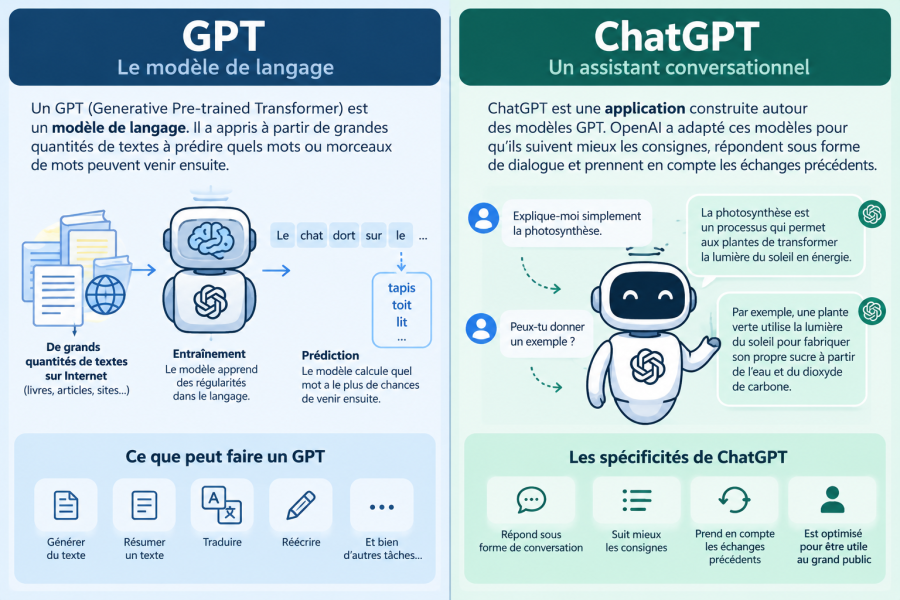
Une comparaison simple consiste à voir GPT comme le moteur et ChatGPT comme l’application qui permet de dialoguer avec ce moteur.
Cette distinction montre aussi pourquoi il serait trompeur de chercher un unique « inventeur de ChatGPT ». Le produit est le résultat d’une succession de recherches et de contributions.
En 2017, des chercheurs de Google présentent notamment l’architecture Transformer, qui deviendra la base technique des modèles GPT. OpenAI développe ensuite sa propre famille de modèles et travaille sur les méthodes permettant de les transformer en assistants plus faciles à guider.
L’histoire est donc collective. Lors de l’annonce d’OpenAI en 2015, Sam Altman et Elon Musk en sont les coprésidents, Ilya Sutskever dirige la recherche et Greg Brockman occupe le poste de directeur technique. D’autres chercheurs, dont John Schulman et Wojciech Zaremba, participent également aux débuts de l’organisation.
ChatGPT n’est donc pas l’invention soudaine d’une seule personne. Il naît d’une succession d’étapes : apprendre aux machines à produire du texte, augmenter leurs capacités, puis leur apprendre à mieux comprendre ce que l’utilisateur attend.
Quel rôle Sam Altman a-t-il joué dans l’histoire de ChatGPT ?
Sam Altman n’est pas le concepteur technique de ChatGPT, mais il joue un rôle important dans l’histoire d’OpenAI. Il participe à la création de l’organisation en 2015 et en devient ensuite l’une de ses principales figures publiques et dirigeantes.
Son rôle se situe surtout dans la direction de l’entreprise, sa stratégie et la transformation des travaux de recherche en produits accessibles au grand public. Pendant ce temps, les modèles GPT et les méthodes d’entraînement sont développés par de nombreuses équipes de chercheurs et d’ingénieurs.
Cette distinction est importante. L’histoire de ChatGPT combine recherche scientifique, ingénierie, puissance de calcul, choix de produit et mise à disposition du public.
Pour comprendre comment toutes ces contributions finissent par produire ChatGPT, il faut maintenant revenir quelques années en arrière. La première pièce technique essentielle n’est d’ailleurs pas créée chez OpenAI, mais chez Google en 2017 : le Transformer.
2017 : le Transformer change le traitement du langage
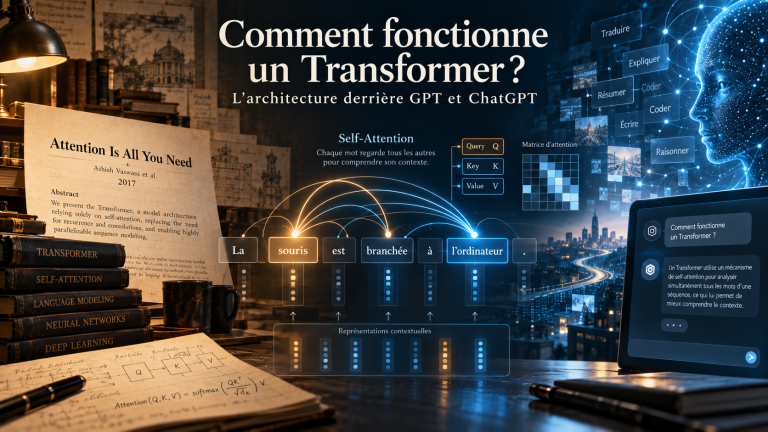
En juin 2017, huit chercheurs publient l’article Attention Is All You Need. Parmi eux figure Ashish Vaswani.
Les auteurs présentent une nouvelle architecture de réseau neuronal : le Transformer. Ils l’utilisent notamment pour des expériences de traduction automatique.
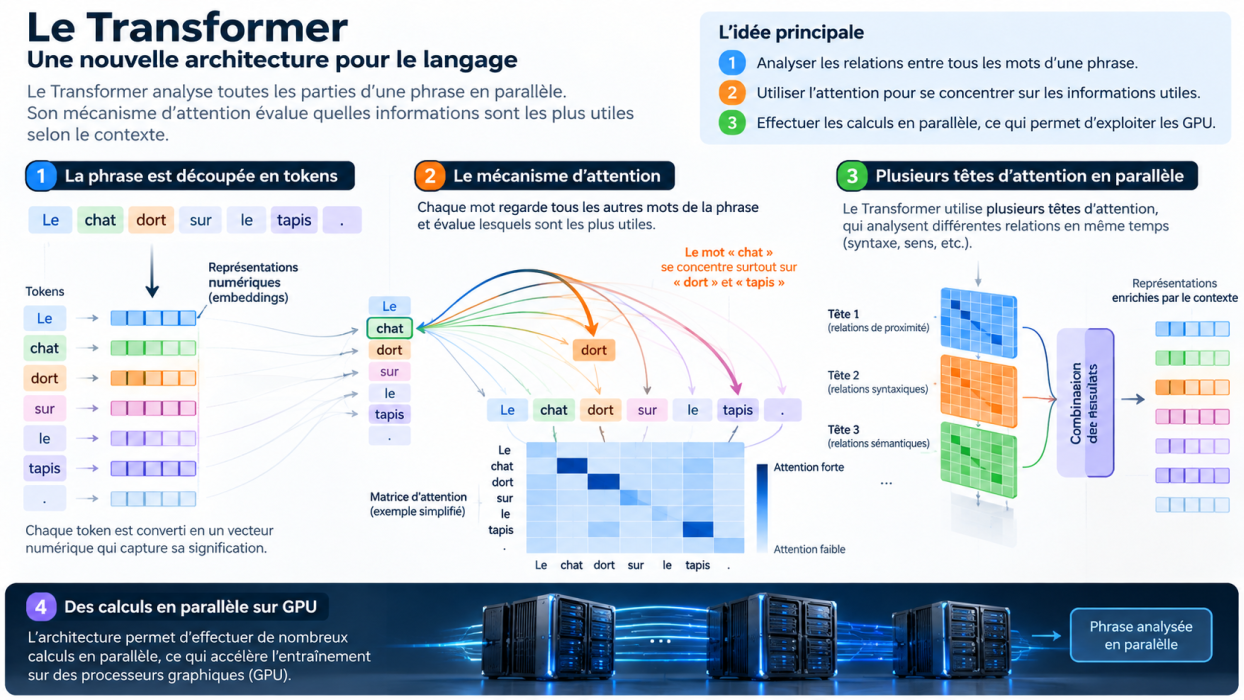
Pour traiter une phrase, le Transformer analyse les relations entre ses différents éléments. Son mécanisme d’attention évalue quelles informations comptent le plus selon le contexte.
L’architecture possède également un autre avantage majeur : elle permet d’effectuer de nombreux calculs en parallèle pendant l’entraînement. Cette caractéristique facilite son utilisation sur des processeurs graphiques puissants.
Dans un entretien publié en 2020, Ilya Sutskever nuance pourtant le rôle de l’attention. Lorsque Lex Fridman lui demande si elle explique le succès du Transformer, il répond :
« C’est une clé, mais ce n’est pas la clé. »
Sutskever insiste plutôt sur la combinaison de plusieurs idées. Le Transformer associe notamment attention, calcul parallèle et abandon des anciens réseaux récurrents.
Cette histoire illustre un mécanisme fréquent en informatique : une idée devient parfois décisive lorsque les machines permettent enfin de l’exploiter efficacement.
Le Transformer fournit donc une architecture particulièrement prometteuse. Reste encore à lui apprendre à exploiter de grandes quantités de langage. C’est précisément ce qu’OpenAI commence à expérimenter l’année suivante avec GPT.
2018 : OpenAI développe le premier GPT
En juin 2018, OpenAI présente les travaux associés au premier GPT. L’équipe utilise l’architecture Transformer avec une méthode de pré-entraînement génératif.
Le principe est simple : on montre au modèle une grande quantité de textes et on lui demande de prédire ce qui vient ensuite. Pour le premier GPT de 2018, ces textes proviennent principalement d’un corpus de plusieurs milliers de livres en anglais.
Avant d’être traité, le texte est découpé en petites unités appelées tokens : un mot entier, une partie de mot, un nombre ou un signe de ponctuation. La langue a donc son importance : le découpage n’est pas exactement le même en anglais, en français ou dans d’autres langues.
Plus une langue est présente dans les données d’entraînement, plus le modèle dispose d’exemples pour en apprendre le vocabulaire, la grammaire et les usages. Une langue peu représentée sera généralement moins bien maîtrisée.
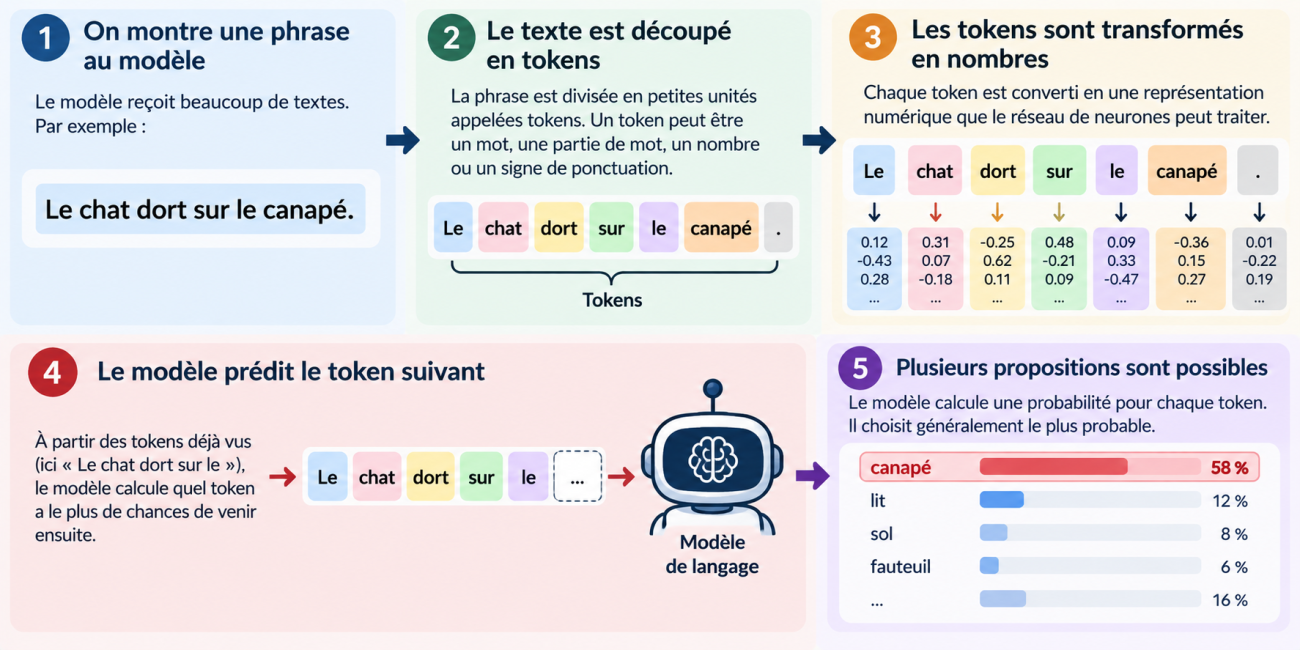
Ces tokens sont transformés en représentations numériques que le réseau peut traiter. À chaque prédiction, le modèle ajuste ses paramètres, c’est-à-dire les valeurs internes qui déterminent son comportement. Répétée sur de très nombreux textes, cette opération lui permet d’apprendre des régularités du langage.
C’est le principe du pré-entraînement : le modèle acquiert d’abord une base générale à partir des textes, avant d’être adapté à des tâches précises.
À l’époque, l’échelle reste encore modeste : l’entraînement du premier GPT mobilise huit GPU pendant environ un mois.
L’idée essentielle est désormais en place : apprendre d’abord à partir de grandes quantités de texte, puis réutiliser cet apprentissage pour différents usages.
OpenAI va alors pousser la logique plus loin : que se passe-t-il si l’on augmente fortement la taille du modèle et la quantité de données utilisées ?
2019 : GPT-2 améliore fortement la génération de texte
OpenAI présente GPT-2 en février 2019. Sa plus grande version compte environ 1,5 milliard de paramètres.
Le modèle peut désormais prolonger un texte sur plusieurs paragraphes. Ses productions restent irrégulières, mais certaines paraissent déjà étonnamment cohérentes. Le rapport technique propose un exemple devenu célèbre. Les chercheurs donnent au modèle le début d’une histoire fictive sur des licornes découvertes dans les Andes. GPT-2 poursuit ce récit sous la forme d’un article de presse et invente des chercheurs, des explications et des citations. Les auteurs précisent toutefois avoir choisi cet exemple parmi dix générations. Il ne constitue donc pas une mesure de fiabilité.
Le débat sur les risques de la génération automatique de texte précède donc de plusieurs années le lancement de ChatGPT. Il rejoint une question plus large : pourquoi l’intelligence artificielle nous fait-elle peur ?
Mais GPT-2 montre surtout que l’approche fonctionne de mieux en mieux lorsque l’on augmente l’échelle. OpenAI va pousser cette logique beaucoup plus loin dès l’année suivante.
2020 : GPT-3 change d’échelle
En mai 2020, les chercheurs présentent GPT-3. Sa plus grande version compte 175 milliards de paramètres.
Un paramètre est une valeur numérique interne du réseau neuronal, ajustée pendant l’entraînement. Il ne s’agit ni d’un mot, ni d’un token, ni d’un fait mémorisé. Le nombre de paramètres donne surtout une idée de la taille du modèle.
GPT-3 montre surtout une capacité nouvelle et très pratique : il peut souvent comprendre le type de tâche demandée simplement à partir de quelques exemples.
Imaginons qu’on lui fournisse ceci :
Français : chat — Anglais : cat
Français : maison — Anglais : house
Français : jardin — Anglais : …
Le modèle repère alors le motif : il s’agit de traduire du français vers l’anglais. Il peut donc compléter avec garden.
Les chercheurs parlent d’apprentissage en contexte. Le terme peut prêter à confusion : GPT-3 ne se réentraîne pas et ses paramètres ne changent pas. Il utilise simplement les exemples présents dans la demande pour déterminer ce que l’on attend de lui.
Cette capacité annonce l’importance future du prompt. Il devient possible de guider le modèle non seulement en lui posant une question, mais aussi en lui donnant des exemples, des consignes ou un format à respecter.
GPT-3 devient ainsi beaucoup plus souple. Pourtant, une difficulté essentielle demeure : savoir produire du texte ne signifie pas encore savoir aider correctement un utilisateur.
Ce qui manque encore : transformer GPT-3 en assistant
GPT-3 sait produire du texte, mais cela ne suffit pas pour créer un bon assistant. Le modèle doit aussi comprendre ce que son interlocuteur attend.
François Chollet évoque cette difficulté lors d’un entretien avec Lex Fridman en août 2020. Il résume le problème ainsi :
« Il peut être assez difficile de lui faire faire ce que l’on veut. »
Un modèle entraîné principalement à prolonger du texte peut choisir plusieurs directions. La demande « Explique-moi cette erreur » peut donner une explication, mais aussi un dialogue fictif ou une imitation de forum.
Produire du langage et aider un utilisateur constituent donc deux objectifs différents.
C’est ce problème qui va occuper une partie importante des recherches suivantes d’OpenAI. Il ne suffit plus d’agrandir les modèles : il faut aussi leur apprendre à mieux suivre les intentions humaines.
Cette étape conduit directement à InstructGPT.
2022 : InstructGPT apprend à mieux suivre les demandes
OpenAI présente InstructGPT le 27 janvier 2022. Cette fois, l’objectif est clair : obtenir des réponses davantage conformes aux intentions exprimées par l’utilisateur.
L’équipe fait intervenir des évaluateurs humains. Ceux-ci rédigent d’abord des exemples de bonnes réponses.
Les chercheurs utilisent ces exemples pour ajuster le modèle. Les évaluateurs comparent ensuite plusieurs réponses à une même demande et les classent.
À partir de ces choix, l’équipe entraîne un modèle de récompense. Celui-ci aide ensuite à orienter l’apprentissage par renforcement. Cette méthode porte le nom de RLHF, pour Reinforcement Learning from Human Feedback.
Une partie du travail consiste donc à définir concrètement ce qu’est une bonne réponse. Faut-il être plus clair ? Respecter davantage la consigne ? Reconnaître une incertitude ? Les évaluateurs doivent faire ce type de choix.
La publication rapporte un résultat particulièrement intéressant. Sur les tests étudiés, les évaluateurs préfèrent souvent InstructGPT à GPT-3 malgré sa taille beaucoup plus faible.
À ce stade, plusieurs pièces sont donc réunies : un grand modèle de langage, des instructions mieux suivies et des préférences humaines intégrées à l’entraînement.
Il reste encore à donner à cet ensemble une interface simple et naturelle. Quelques mois plus tard, cette interface prendra la forme d’une conversation.
30 novembre 2022 : OpenAI lance ChatGPT
Le 30 novembre 2022, OpenAI rend ChatGPT accessible au public sous forme de version de recherche gratuite.
L’entreprise adapte le premier ChatGPT à partir d’un modèle de la famille GPT-3.5 et reprend plusieurs méthodes développées avec InstructGPT.
Des formateurs humains participent également à la préparation du dialogue. Ils jouent alternativement le rôle de l’utilisateur et celui de l’assistant. La conversation transforme alors l’expérience. Après une première réponse, l’utilisateur peut demander un exemple, une précision ou une reformulation. Il n’a plus besoin de formuler une demande parfaite dès le départ. Le dialogue permet de construire progressivement ce que l’on attend du système.
Le 30 novembre 2022 est donc généralement retenu comme la date de naissance publique de ChatGPT, même si sa conception repose sur plusieurs années de recherches antérieures.
OpenAI mentionne pourtant plusieurs limites dès le lancement. ChatGPT peut fournir des réponses plausibles mais fausses. Sa réponse peut également changer selon la formulation de la question.
Malgré ces limites, quelque chose change radicalement en novembre 2022 : toutes ces technologies deviennent accessibles derrière une interface que presque tout le monde comprend immédiatement.
C’est cette simplicité qui va contribuer à transformer une expérience de recherche en phénomène mondial.
Pourquoi ChatGPT a-t-il connu un tel succès ?
ChatGPT n’introduit pas soudainement toutes ses technologies en 2022. Le Transformer existe depuis 2017, GPT depuis 2018 et les grands modèles de langage ont déjà montré leurs capacités avant son lancement.
La rupture vient aussi de leur assemblage dans une interface extrêmement simple. L’utilisateur écrit une demande en langage courant et obtient immédiatement une réponse.
Il peut ensuite poursuivre l’échange, demander une explication différente, corriger sa consigne ou préciser ce qu’il souhaite.
Avant ChatGPT, ces technologies apparaissent surtout dans des travaux de recherche, des démonstrations ou des outils destinés aux développeurs. ChatGPT les rend accessibles à un public beaucoup plus large.
Son succès repose donc à la fois sur les progrès des modèles de langage et sur la simplicité de l’interface conversationnelle.
Après 2022 : les grandes évolutions de ChatGPT
Le ChatGPT lancé en 2022 continue d’évoluer rapidement. Les modèles deviennent plus puissants, plus multimodaux et capables de consacrer davantage de calcul aux problèmes difficiles.
2023 : GPT-4
GPT-4 améliore nettement le raisonnement, le suivi des instructions et la fiabilité par rapport aux générations précédentes. Il peut également recevoir des images en entrée, ce qui ouvre ChatGPT à l’analyse visuelle.
2024 : GPT-4o
Avec GPT-4o, le « o » signifie omni. Le modèle réunit davantage le texte, l’image, la voix et la vidéo dans une même architecture et permet des échanges vocaux beaucoup plus rapides et naturels.
2024 : o1 et le raisonnement approfondi
La série o1 introduit une autre évolution : le modèle peut consacrer davantage de temps au raisonnement avant de répondre. Cette approche vise surtout les problèmes complexes en mathématiques, sciences et programmation.
2025 : o3 et o4-mini utilisent des outils
Avec o3 et o4-mini, les modèles de raisonnement peuvent aussi combiner plusieurs outils de ChatGPT : recherche sur le Web, Python, analyse de fichiers ou d’images. Le modèle ne se contente donc plus de répondre : il peut choisir des moyens pour résoudre le problème.
2025 : GPT-5 réunit réponse rapide et raisonnement
GPT-5 rapproche les modèles conversationnels et les modèles de raisonnement. Le système peut répondre rapidement aux questions simples et consacrer davantage de réflexion aux demandes complexes.
2026 : GPT-5.6 privilégie puissance et efficacité
La famille GPT-5.6 poursuit cette évolution avec plusieurs variantes adaptées à différents besoins. Sol privilégie les tâches complexes, tandis que Terra et Luna recherchent davantage d’efficacité et de rapidité.
2026 : GPT-6 Astra pousse plus loin l’utilisation d’outils
GPT-6 Astra marque une nouvelle étape dans les tâches complexes. OpenAI met particulièrement en avant ses capacités de navigation, utilisation d’ordinateur, programmation, sciences et travail professionnel. Le modèle peut ainsi raisonner sur plusieurs étapes et utiliser des outils pour accomplir une partie du travail demandé.
En quelques années, ChatGPT est donc passé d’un assistant principalement textuel à un système capable de raisonner, d’analyser plusieurs types de contenus et d’utiliser des outils pour accomplir des tâches complexes.
Sources et références
- La création d’OpenAI : OpenAI, Introducing OpenAI, décembre 2015.
- Le Transformer : Ashish Vaswani et ses coauteurs, Attention Is All You Need, 2017.
- Le premier GPT : Alec Radford et ses coauteurs, Improving Language Understanding by Generative Pre-Training, 2018.
- GPT-2 : OpenAI, présentation de GPT-2, février 2019.
- GPT-3 : Tom B. Brown et ses coauteurs, Language Models are Few-Shot Learners, 2020.
- Les témoignages de 2020 : entretiens d’Ilya Sutskever et François Chollet avec Lex Fridman.
- InstructGPT et les retours humains : Long Ouyang et ses coauteurs, Training language models to follow instructions with human feedback, 2022.
- Le lancement de ChatGPT : OpenAI, Introducing ChatGPT, 30 novembre 2022.