Histoire des chatbots : d’ELIZA à ChatGPT
Lorsque ChatGPT apparaît à la fin de 2022, des millions de personnes découvrent qu’il est possible de dialoguer avec un ordinateur presque comme avec un interlocuteur humain. On lui pose une question, on précise sa demande, on lui demande de reformuler, de traduire ou d’expliquer autrement : la conversation devient une manière naturelle de commander la machine.
Cette impression de rupture est réelle, mais l’histoire des chatbots commence près de soixante ans plus tôt. Dès les années 1960, ELIZA parvient déjà à donner à certains utilisateurs le sentiment d’être compris. Le programme ne connaît pourtant presque rien du monde et ne comprend pas le sens des phrases comme le ferait un être humain.
Un chatbot, ou agent conversationnel, est un programme conçu pour échanger avec un utilisateur en langage courant, par écrit ou oralement. Des premières règles d’ELIZA aux grands modèles de langage actuels, son histoire croise celle de l’intelligence artificielle, de la psychologie, d’Internet et des interfaces informatiques.
Elle pose surtout une question qui accompagne l’informatique depuis ses débuts : que se passe-t-il lorsque la machine utilise notre propre langage pour nous répondre ?
De Turing aux premiers programmes de conversation
1950 : Turing place le dialogue au cœur de l’intelligence
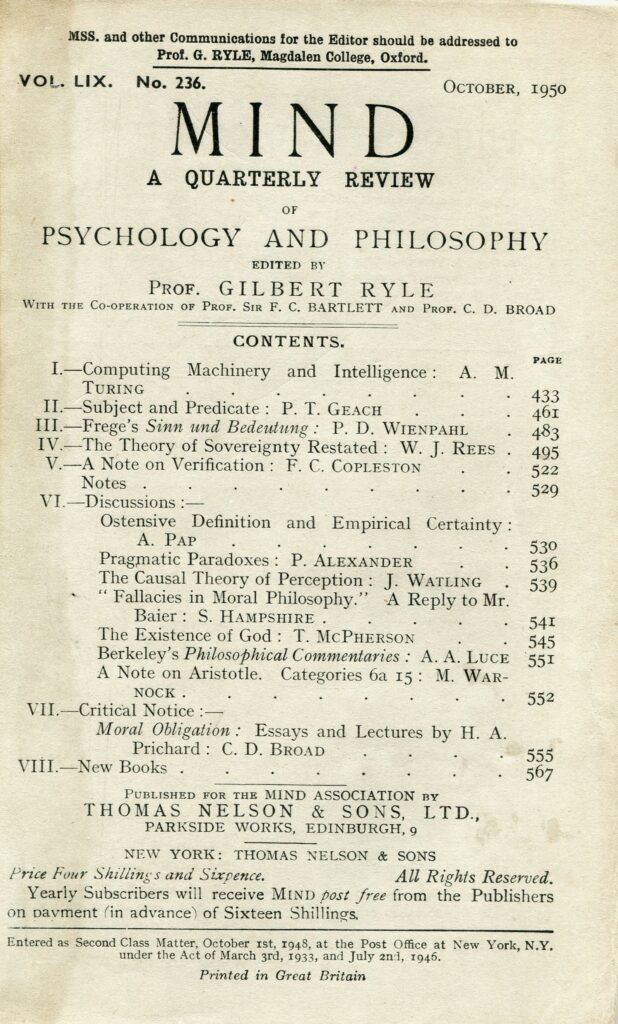
En 1950, alors que les ordinateurs électroniques occupent encore des salles entières, Alan Turing publie Computing Machinery and Intelligence. Il part d’une question devenue célèbre : « Les machines peuvent-elles penser ? » Mais le mot « penser » lui paraît trop difficile à définir. Il propose donc de remplacer la question philosophique par une expérience observable.
Un interrogateur échange par écrit avec deux interlocuteurs qu’il ne voit pas. L’un est humain, l’autre est une machine. Si leurs réponses rendent leur distinction suffisamment difficile, la machine manifeste au moins un comportement conversationnel comparable à celui d’un être humain. Cette expérience prendra plus tard le nom de test de Turing.
Turing n’invente pas le chatbot. Il montre cependant pourquoi le langage occupe une place particulière : une machine qui répond de manière convaincante peut donner l’impression d’être intelligente, même si son fonctionnement reste invisible à celui qui l’interroge.
1966 : ELIZA crée l’illusion d’être compris
Entre 1964 et 1966, Joseph Weizenbaum développe au MIT un programme nommé ELIZA, souvent présenté comme le premier chatbot de l’histoire.
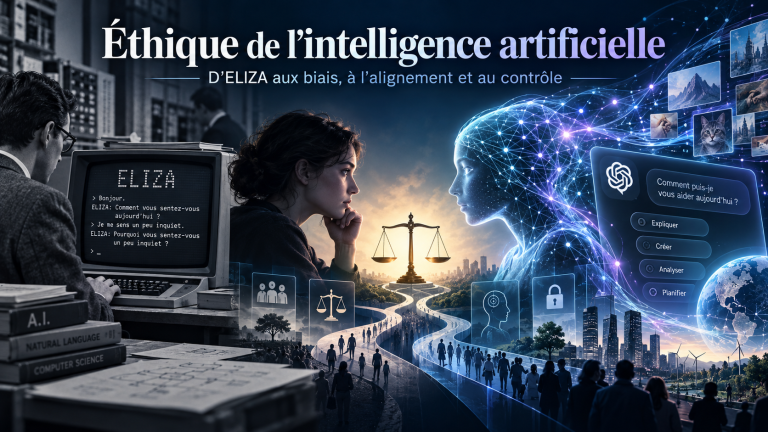
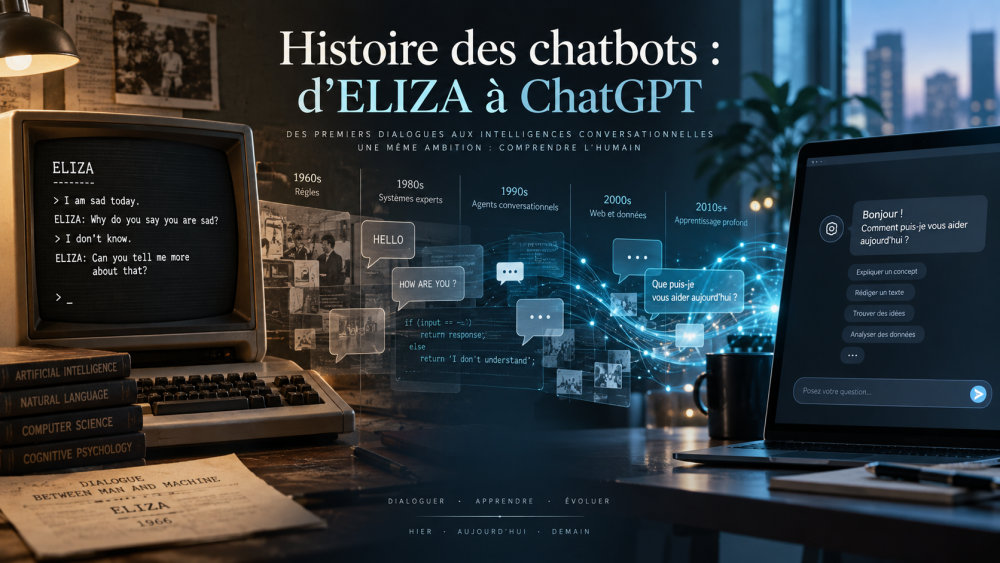
ELIZA ne possède ni connaissances générales ni représentation du monde. Le programme repère certains mots ou certaines structures, puis applique des règles pour transformer la phrase de l’utilisateur. Son script le plus célèbre, DOCTOR, imite un psychothérapeute d’inspiration rogérienne.
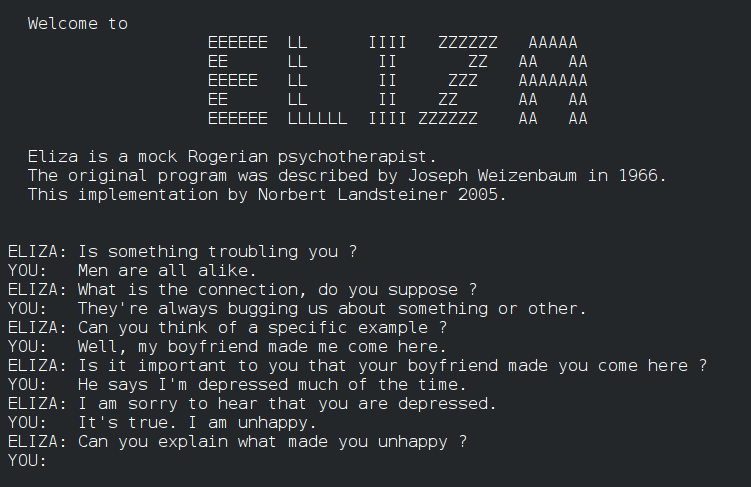
Si l’utilisateur écrit :
Je suis inquiet à propos de ma mère.
ELIZA peut détecter le mot « mère » et répondre :
Parlez-moi davantage de votre famille.
Le choix du thérapeute est particulièrement habile. Une reformulation ou une question ouverte paraît naturelle dans ce contexte. Lorsque l’utilisateur fournit lui-même l’essentiel du contenu, quelques règles bien choisies suffisent à donner l’impression que le programme écoute et suit la conversation.
Weizenbaum raconte que certaines personnes se confiaient à ELIZA de façon étonnamment intime. Selon une anecdote devenue célèbre, sa secrétaire, pourtant informée du fonctionnement du programme, lui aurait demandé de quitter la pièce afin de poursuivre la conversation en privé. Ce récit ne constitue pas à lui seul une expérience scientifique, mais il illustre un phénomène bien réel : nous attribuons facilement une intention et une compréhension à une machine qui emploie notre langage.
Ce mécanisme sera appelé effet ELIZA. Nous savons qu’un programme produit les réponses, mais notre cerveau cherche spontanément derrière les mots un esprit semblable au nôtre. Cette tendance permet de comprendre pourquoi une machine qui parle peut autant nous fasciner que nous inquiéter.
Weizenbaum lui-même se montre préoccupé par cette réaction. Dans Computer Power and Human Reason, publié en 1976, il insiste sur la différence entre produire correctement un résultat et comprendre humainement ce qu’il signifie. La question reste actuelle : une réponse convaincante ne prouve pas, à elle seule, que la machine éprouve ou comprend ce qu’elle exprime.
PARRY et SHRDLU : personnalité ou compréhension limitée
Au début des années 1970, deux programmes explorent des voies différentes.
Le psychiatre Kenneth Colby développe PARRY, qui simule certains comportements associés à la paranoïa. Là où ELIZA reformule principalement les propos de l’utilisateur, PARRY utilise des règles et des états internes représentant des croyances, des réactions et une manière cohérente d’interpréter la conversation. Des psychiatres examinent ensuite, par télétype, des dialogues produits par de véritables patients et par le programme. L’objectif n’est pas de montrer que PARRY pense, mais de tester jusqu’où un modèle informatique peut reproduire certains aspects observables d’un comportement.
À la même époque, Terry Winograd conçoit SHRDLU au laboratoire d’intelligence artificielle du MIT. L’utilisateur peut lui demander de déplacer des cubes, des pyramides et d’autres formes dans un petit univers virtuel. Le programme sait répondre à des questions sur ces objets et exécuter certaines instructions.
SHRDLU semble comprendre le langage de façon beaucoup plus profonde qu’ELIZA, mais seulement dans un monde extrêmement limité, dont tous les objets et toutes les règles ont été définis à l’avance. Cette réussite révèle une difficulté fondamentale : comprendre quelques phrases dans un univers fermé est possible ; traiter la richesse et les ambiguïtés du monde réel est d’une tout autre ampleur.
Des règles écrites à la main aux chatbots d’Internet
Pendant les décennies suivantes, la plupart des chatbots reposent encore sur des règles prévues par leurs concepteurs. Pour répondre intelligemment, le programme doit anticiper ce que l’utilisateur pourrait écrire.
À partir de 1995, A.L.I.C.E., développé par Richard Wallace, pousse cette méthode très loin. Son langage AIML permet de décrire des milliers de correspondances entre des formulations possibles et les réponses à produire. Avec suffisamment de règles, le résultat peut devenir convaincant, mais le problème de fond demeure : le nombre de phrases possibles dans une langue est pratiquement illimité.
Jabberwacky, imaginé par Rollo Carpenter et rendu accessible sur Internet dans les années 1990, suit une autre piste. Le programme conserve des conversations humaines et cherche à réutiliser des réponses dans des situations semblables. Une partie de son comportement dépend donc de ce que les utilisateurs lui ont appris, et plus seulement de réponses entièrement rédigées à l’avance.
Le prix Loebner et la tentation de « réussir » le test de Turing
Créé en 1991, le prix Loebner organise des compétitions inspirées du test de Turing. Des juges dialoguent avec des humains et avec des programmes, puis essaient de les distinguer. A.L.I.C.E. et Jabberwacky figurent parmi les systèmes récompensés au cours de l’histoire du concours.
Ces compétitions popularisent les chatbots, mais elles soulèvent aussi une limite. Un programme peut paraître humain en esquivant les questions, en plaisantant ou en exploitant la brièveté de l’échange, sans posséder pour autant une compréhension générale du langage. Tromper momentanément un juge et construire un système réellement utile ne sont pas exactement le même objectif.
2001 : SmarterChild entre dans les messageries
Avec Internet, le chatbot quitte progressivement les laboratoires. En 2001, les utilisateurs d’AOL Instant Messenger et de MSN Messenger peuvent ajouter à leurs contacts un correspondant particulier : SmarterChild.
On peut discuter avec lui, mais aussi lui demander la météo, un résultat sportif ou une définition. Pourtant, l’idée est alors novatrice. Au lieu d’ouvrir un site et de parcourir des menus, l’utilisateur formule sa demande dans la fenêtre où il échange déjà avec ses amis.
Des millions de personnes utilisent SmarterChild. Beaucoup ne se limitent pas à demander une information : elles plaisantent, provoquent le programme ou testent ses réactions. Une idée appelée à devenir centrale apparaît clairement : la conversation peut servir d’interface informatique.
Cette évolution peut sembler spectaculaire par rapport à ELIZA, mais SmarterChild ne comprend pas encore réellement les phrases qu’on lui adresse. Son efficacité vient surtout de la combinaison de plusieurs techniques devenues beaucoup plus faciles à exploiter avec Internet.
Le programme analyse la demande à la recherche de mots, de formulations et d’informations utiles. Dans « Quel temps fait-il à Paris ? », il peut par exemple reconnaître une demande concernant la météo et extraire « Paris » comme lieu. Si la demande est ambiguë, il peut poser une question pour la préciser.
Une fois l’intention identifiée, SmarterChild ne fabrique pas librement sa réponse. Il interroge le service ou la base de données correspondant au sujet demandé — météo, sport, cinéma, dictionnaire, cours de Bourse — puis insère le résultat dans une réponse préparée pour paraître naturelle.
ActiveBuddy développe pour cela son propre système de programmation, notamment un langage appelé BuddyScript, permettant d’ajouter progressivement des règles et des domaines de connaissances. SmarterChild devient ainsi moins un cerveau artificiel qu’un intermédiaire entre l’utilisateur et de nombreux services accessibles par Internet.
Le progrès par rapport à ELIZA vient donc surtout de l’échelle et de l’architecture : davantage de règles, une meilleure analyse des formulations, un suivi limité du contexte et surtout l’accès à des informations extérieures actualisées. La conversation ne sert plus seulement à donner l’illusion du dialogue : elle devient un moyen d’interroger des services informatiques.
Siri et Alexa : parler pour commander
Une autre branche de cette histoire se développe avec la reconnaissance vocale. Les technologies qui conduisent à Siri proviennent notamment des recherches du SRI International. Siri devient une entreprise indépendante en 2007, est rachetée par Apple en 2010 puis intégrée à l’iPhone 4S en 2011.
Amazon présente l’Echo et son assistant Alexa en 2014. Google Assistant et Cortana suivent une logique comparable.
Le progrès est important, car l’ordinateur doit désormais accomplir plusieurs opérations successives en quelques secondes. Lorsque l’utilisateur dit par exemple :
Quel temps fera-t-il demain à Carcassonne ?
l’assistant commence par transformer le son enregistré par le microphone en mots. C’est la reconnaissance automatique de la parole. Les progrès réalisés dans ce domaine permettent alors de reconnaître des phrases beaucoup plus librement qu’avec les anciens systèmes téléphoniques qui demandaient de prononcer seulement quelques mots prévus à l’avance.
Une fois la phrase convertie en texte, le système cherche ce que l’utilisateur veut faire. Il peut identifier ici une intention, demander la météo, puis extraire les informations nécessaires : demain pour la date et Carcassonne pour le lieu. Ces informations sont parfois appelées des paramètres ou des slots.
L’assistant peut alors appeler le service correspondant. Pour une météo, il interroge un service météorologique ; pour lancer une musique, il transmet une commande à l’application concernée ; pour programmer une alarme, il utilise la fonction prévue sur l’appareil.
La réponse suit ensuite le chemin inverse. Le service fournit une information sous forme de données, l’assistant construit une phrase puis un système de synthèse vocale la transforme en parole.
Le fonctionnement peut donc être résumé ainsi :
voix → reconnaissance des mots → identification de l’intention → appel d’un service → réponse → synthèse vocale.
Cette organisation explique à la fois l’efficacité spectaculaire de Siri ou d’Alexa et leurs limites. Ils ne disposent pas encore d’une capacité générale à discuter de n’importe quel sujet. Leur univers est constitué d’un ensemble de fonctions prévues : météo, musique, agenda, appels, domotique, recherches ou applications spécialisées. Pour Alexa, ces fonctions peuvent notamment être ajoutées sous forme de skills, chacune définissant les demandes qu’elle sait traiter.
Ainsi, deux phrases très différentes comme « Quel temps fera-t-il demain ? » et « Est-ce que je dois prendre un parapluie demain ? » peuvent être associées à la même intention si le système a appris ou prévu ces formulations. En revanche, une demande qui ne correspond à aucune fonction connue peut conduire à une réponse inadéquate ou à l’impossibilité d’agir.
Ces assistants ne cherchent donc pas encore principalement à entretenir une longue conversation. Leur véritable nouveauté est ailleurs : la parole devient une interface permettant de commander directement des services informatiques.
Le dialogue progresse, mais reste compartimenté. Tant que la demande correspond à une fonction connue, le système paraît particulièrement intelligent. Dès que l’utilisateur sort de ce cadre, ses limites apparaissent rapidement. La voix transforme profondément l’interface avec l’ordinateur, mais pas encore la nature fondamentale du programme.
Quand la machine apprend à converser
2015 : les réponses ne sont plus toutes écrites à l’avance
Le changement décisif vient des réseaux neuronaux capables d’apprendre à partir d’exemples. En 2015, Oriol Vinyals et Quoc Le, chez Google, présentent A Neural Conversational Model.
Au lieu de demander à un programmeur de prévoir chaque situation, ils entraînent un réseau sur des dialogues afin qu’il apprenne à prédire une réponse à partir des phrases précédentes. Le modèle découvre ainsi des régularités dans les exemples qui lui sont fournis.
Les résultats restent fragiles : les réponses sont parfois banales, incohérentes ou contradictoires. Mais une étape importante est franchie. La phrase produite n’a plus nécessairement été rédigée à l’avance par un humain.
2017 : le Transformer change d’échelle
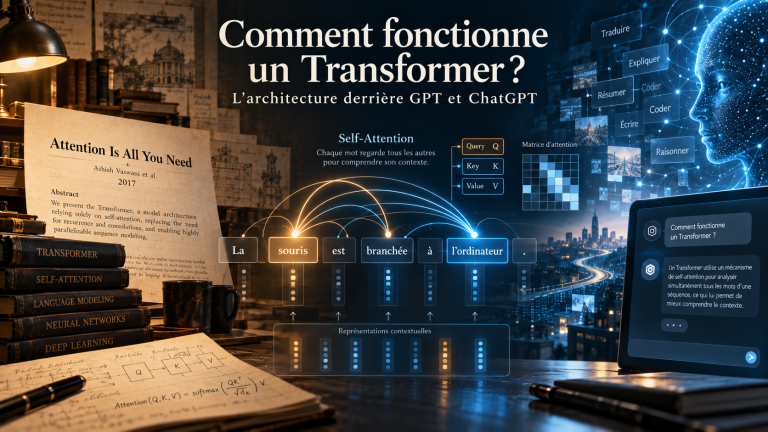
En 2017, huit chercheurs travaillant principalement chez Google publient Attention Is All You Need. Ils présentent une nouvelle architecture appelée Transformer.
Son mécanisme d’attention permet au modèle d’évaluer quelles parties d’un texte sont importantes pour traiter un élément donné. L’architecture facilite également de nombreux calculs en parallèle, ce qui rend possible l’entraînement de modèles beaucoup plus grands sur d’immenses corpus.
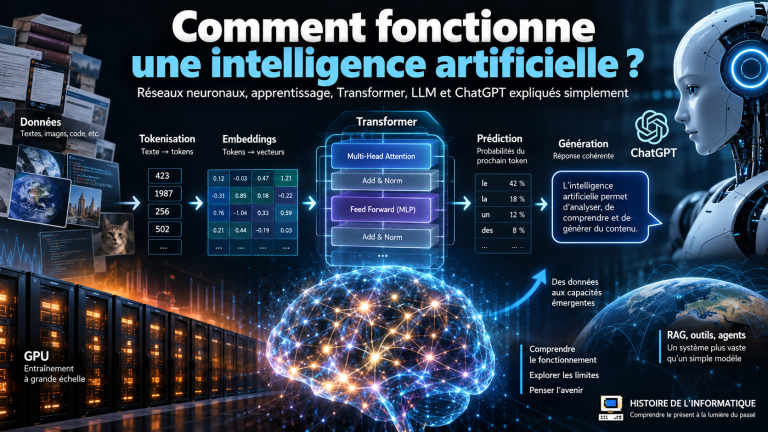
Conçu initialement pour la traduction, le Transformer va transformer presque tout le traitement automatique du langage. Pour comprendre plus précisément les tokens, les paramètres, l’entraînement et la génération d’une réponse, on peut consulter l’article consacré au fonctionnement d’une intelligence artificielle moderne.
Meena, BlenderBot et LaMDA préparent le dialogue à grande échelle
Entre 2020 et 2022, plusieurs projets montrent les progrès rapides des modèles spécialement entraînés pour dialoguer. Google présente Meena, Meta développe BlenderBot et Google poursuit ses recherches avec LaMDA.
Ces systèmes cherchent à maintenir des conversations plus longues, plus précises et moins génériques. Ils font aussi apparaître des problèmes qui restent essentiels aujourd’hui : contradictions, réponses inventées, propos dangereux, difficulté à s’appuyer sur des sources fiables et tendance de l’utilisateur à prêter une personnalité au programme.
De GPT à ChatGPT
Prédire la suite pour apprendre à produire du texte
En 2018, OpenAI combine l’architecture Transformer avec le pré-entraînement. Plutôt que de construire un programme différent pour chaque tâche, l’entreprise entraîne un modèle général sur une très grande quantité de textes.
Le principe consiste notamment à prédire le prochain élément d’une séquence. Il ne s’agit pas toujours d’un mot entier, mais souvent d’un fragment appelé token. En répétant cet exercice un très grand nombre de fois, le modèle apprend des régularités grammaticales, des associations entre concepts, des styles d’écriture et de nombreuses connaissances présentes dans les données.
GPT-2 montre en 2019 qu’un tel système peut produire des paragraphes relativement cohérents. En 2020, GPT-3 atteint 175 milliards de paramètres et réalise différentes tâches lorsqu’on lui fournit une instruction ou quelques exemples.
Autrement dit, le modèle ne consulte pas une encyclopédie interne pour recopier une réponse toute faite. À chaque étape, il calcule quel token peut vraisemblablement suivre ceux qui précèdent. La puissance du résultat vient de la taille du modèle, de la diversité de son entraînement et des régularités qu’il a pu y apprendre.
Apprendre à suivre les intentions humaines
Prédire la suite d’un texte ne suffit pas pour devenir un assistant. Un modèle entraîné de cette seule manière peut continuer une question au lieu d’y répondre, produire une affirmation fausse avec assurance ou adopter un comportement inattendu.
Avec InstructGPT, présenté en 2022, des personnes fournissent des exemples de réponses souhaitables et comparent plusieurs productions du modèle. Ces préférences servent ensuite à poursuivre son entraînement, notamment grâce au RLHF, l’apprentissage par renforcement à partir de retours humains.
Le système n’apprend donc plus seulement à produire une suite de texte plausible. Il est aussi orienté vers des réponses que des évaluateurs considèrent comme plus utiles et mieux adaptées à la demande.
30 novembre 2022 : ChatGPT rend le modèle conversationnel accessible à tous
Le 30 novembre 2022, OpenAI rend ChatGPT accessible au public. La première version est affinée à partir d’un modèle de la famille GPT-3.5 et utilise des méthodes proches de celles d’InstructGPT.
Les principales briques techniques existent donc déjà. La rupture vient de leur combinaison et de leur présentation. Une simple zone de texte permet de demander un résumé, une traduction, une explication ou du code. L’utilisateur peut ensuite préciser sa demande, corriger un malentendu et poursuivre l’échange sans recommencer depuis le début.
Le grand modèle de langage devient ainsi accessible à un immense public par l’intermédiaire d’une interface ancienne et naturelle : le dialogue.
ELIZA et ChatGPT : même impression, machines très différentes
Présenter ChatGPT comme une version agrandie d’ELIZA serait trompeur. Les deux systèmes peuvent donner l’impression de comprendre, mais leur fonctionnement diffère profondément.
| ELIZA | ChatGPT et les LLM modernes | |
|---|---|---|
| Principe | Règles et transformations écrites à l’avance | Modèle neuronal entraîné sur de très grandes quantités de données |
| Production de la réponse | Sélection et transformation à partir d’un script | Génération progressive de tokens selon des probabilités |
| Contexte | Très limité | Peut exploiter une conversation beaucoup plus longue |
| Connaissances | Présentes dans les règles et les mots-clés | Partiellement apprises pendant l’entraînement et parfois complétées par des outils |
| Capacités | Conversation dans un cadre étroit | Explication, rédaction, traduction, programmation, analyse et autres tâches |
Une continuité relie pourtant ces machines. ELIZA avait montré qu’un système simple pouvait susciter une impression de compréhension. Les modèles actuels rendent cette impression beaucoup plus forte parce que leurs réponses sont plus variées, plus cohérentes et mieux adaptées au contexte.
Le problème soulevé par Weizenbaum n’a donc pas disparu. Il est devenu plus difficile à percevoir.
Le chatbot devient une interface générale
Depuis ChatGPT, les assistants conversationnels ne se limitent plus au texte. Certains peuvent analyser des images, traiter du son, consulter des documents, effectuer une recherche ou utiliser des logiciels. Des agents commencent également à enchaîner plusieurs actions afin d’accomplir une tâche.
Le mot chatbot devient presque trop étroit. ELIZA était essentiellement un programme de conversation. Dans un système contemporain, la conversation peut n’être que la porte d’entrée vers un ensemble de capacités beaucoup plus vaste.
La fonction principale n’est donc plus toujours de discuter. Le dialogue devient l’interface par laquelle l’utilisateur décrit directement son objectif.
Une histoire de machines, mais aussi de comportements humains
L’histoire des chatbots n’est pas une progression régulière dans laquelle chaque invention remplace la précédente. Les règles écrites à la main, les systèmes spécialisés, les assistants vocaux et les modèles neuronaux ont longtemps coexisté. Certains continuent d’ailleurs à être utilisés lorsque leur fonctionnement prévisible constitue un avantage.
Un même fil traverse néanmoins cette histoire : réduire la distance entre la manière dont l’être humain communique et celle dont l’ordinateur doit être commandé. Les premières machines exigeaient des cartes perforées et des langages spécialisés. Les assistants ont appris à reconnaître quelques formulations ordinaires. Les grands modèles de langage permettent désormais de décrire un problème, d’apporter des précisions et de corriger la réponse au cours d’un échange.
Mais l’observation la plus durable remonte peut-être à ELIZA. La machine a énormément changé ; notre tendance à lui attribuer des intentions beaucoup moins. Dès qu’un écran nous répond avec suffisamment de cohérence, nous cherchons derrière ses mots une personnalité, une pensée, parfois même une conscience.
C’est pourquoi deux questions doivent rester distinctes : que peut réellement faire la machine, et qu’imaginons-nous qu’elle comprend lorsqu’elle le fait ?
Repères chronologiques
- 1950 : Alan Turing propose le jeu de l’imitation.
- 1966 : Joseph Weizenbaum publie ELIZA.
- 1968-1970 : Terry Winograd développe SHRDLU.
- 1971-1972 : Kenneth Colby et ses collègues présentent PARRY et l’évaluent lors de tests d’indistinguabilité.
- Années 1990 : A.L.I.C.E. et Jabberwacky popularisent de nouvelles formes de dialogue automatisé.
- 1991 : première édition du prix Loebner.
- 2001 : SmarterChild entre dans les messageries instantanées.
- 2011 : Siri est intégré à l’iPhone 4S.
- 2014 : Amazon présente Echo et Alexa.
- 2015 : Google expérimente un modèle conversationnel neuronal de type sequence-to-sequence.
- 2017 : publication de l’architecture Transformer.
- 2018 : OpenAI présente son premier modèle GPT.
- 2020-2022 : Meena, BlenderBot et LaMDA explorent le dialogue neuronal à grande échelle.
- 2022 : publication d’InstructGPT, puis ouverture de ChatGPT le 30 novembre.
À lire aussi
- Histoire de l’intelligence artificielle : de Turing à ChatGPT
- Comment fonctionne une intelligence artificielle ?
- Pourquoi l’intelligence artificielle nous fait-elle peur ?
- Le perceptron : fonctionnement, apprentissage et histoire
- Histoire de l’informatique : des premières machines à l’intelligence artificielle
Sources principales
- Joseph Weizenbaum, ELIZA — A Computer Program for the Study of Natural Language Communication Between Man and Machine, Communications of the ACM, 1966.
- Kenneth M. Colby, Sylvia Weber et Franklin D. Hilf, Artificial Paranoia, 1971, et Kenneth M. Colby et al., Turing-like Indistinguishability Tests, 1972.
- Terry Winograd, Procedures as a Representation for Data in a Computer Program for Understanding Natural Language, MIT, 1971.
- Stuart M. Shieber, Lessons from a Restricted Turing Test, à propos du prix Loebner.
- SRI International, histoire du développement de Siri.
- Oriol Vinyals et Quoc V. Le, A Neural Conversational Model, Google, 2015.
- Ashish Vaswani et al., Attention Is All You Need, 2017.
- Google Research, travaux sur Meena et LaMDA ; Meta AI, présentation de BlenderBot.
- Tom B. Brown et al., Language Models Are Few-Shot Learners, 2020.
- Long Ouyang et al., Training Language Models to Follow Instructions with Human Feedback, 2022.
- OpenAI, présentation de ChatGPT, 30 novembre 2022.