TCP/IP : comment des réseaux différents ont appris à communiquer
Au début des années 1970, les chercheurs savent déjà relier des ordinateurs à distance. ARPANET en est la démonstration. Mais un nouveau problème apparaît : comment faire communiquer deux machines lorsqu’elles ne sont même pas reliées au même type de réseau ?
Une liaison radio, un réseau universitaire et une communication par satellite n’utilisent pas nécessairement les mêmes équipements, ni les mêmes règles de transmission. Il serait peu réaliste d’exiger que tous adoptent une technologie unique. C’est précisément à ce problème que vont s’attaquer les chercheurs à l’origine de TCP/IP.
Pourquoi fallait-il un protocole commun ?
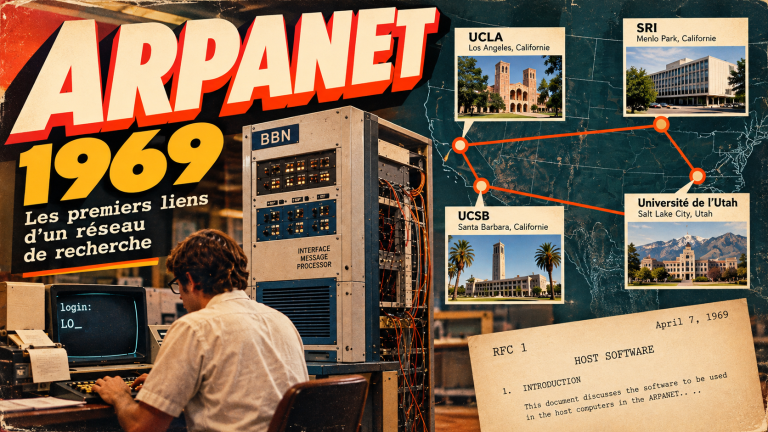
En 1969, ARPANET relie ses premiers laboratoires américains. Au fil des années, ses utilisateurs peuvent ouvrir des sessions à distance, transférer des fichiers et échanger des messages. Pour permettre ces communications, les ordinateurs utilisent notamment des mécanismes regroupés sous le nom de NCP.
Ce système répond aux besoins d’ARPANET, mais il n’a pas été conçu pour relier facilement des réseaux indépendants. Or, au début des années 1970, les projets se multiplient : réseaux locaux, expériences de transmission par radio, communications par satellite. Chacun possède ses propres contraintes.
Imaginons qu’un chercheur utilise un ordinateur connecté à un réseau terrestre et qu’il souhaite joindre un collègue accessible par un réseau radio. Les deux infrastructures savent transporter des données, mais pas nécessairement les interpréter de la même façon. Faut-il reconstruire l’une d’elles pour la rendre compatible avec l’autre ?
Les ingénieurs vont explorer une solution plus souple : conserver les réseaux existants et ajouter une manière commune de faire circuler les données entre eux. Il ne s’agit plus seulement de construire un réseau, mais d’interconnecter plusieurs réseaux.
Le datagramme
Pour comprendre cette idée, prenons une lettre. Peu importe qu’elle voyage d’abord par camion, puis par avion : son adresse permet de la conduire vers sa destination. Les moyens de transport changent, mais la destination reste la même.
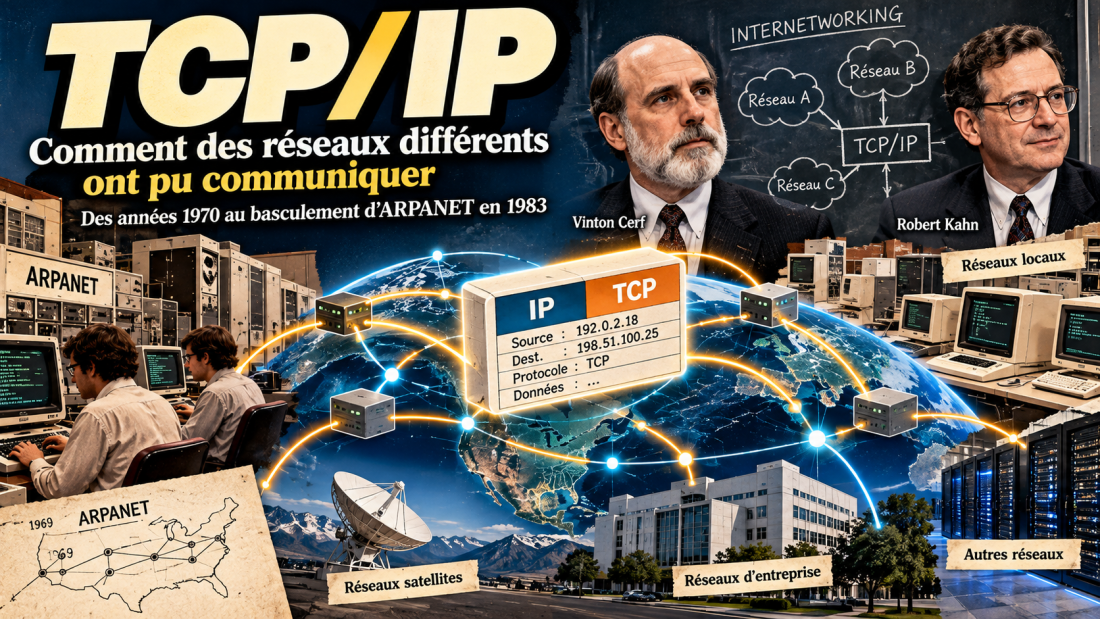
Un datagramme IP suit un principe comparable. C’est une unité de données qui comporte notamment une adresse de départ et une adresse de destination. Lorsqu’il rencontre un équipement reliant deux réseaux, celui-ci lit l’adresse nécessaire à l’acheminement et transmet le datagramme vers l’étape suivante.
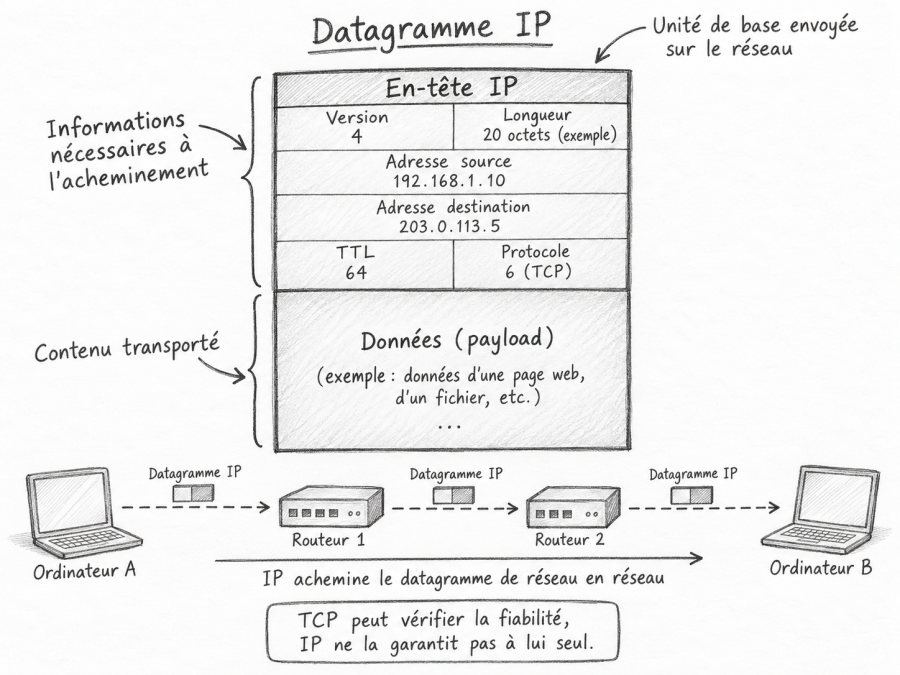
Ces équipements, d’abord appelés passerelles (gateways), préfigurent les routeurs actuels. Chaque réseau transporte les données avec sa propre technologie, sans que les ordinateurs aux extrémités aient besoin d’en connaître tous les détails.
Prenons un exemple concret. Un datagramme IP quitte un ordinateur connecté à un réseau local Ethernet. Lorsqu’il atteint un routeur, celui-ci peut le transmettre sur une liaison utilisant une autre technologie, par exemple une liaison satellite. Le routeur adapte la manière dont le datagramme est transporté sur cette nouvelle liaison, mais son adresse IP de destination reste la même. C’est cette indépendance entre IP et les technologies de transmission qui permet d’interconnecter des réseaux différents.
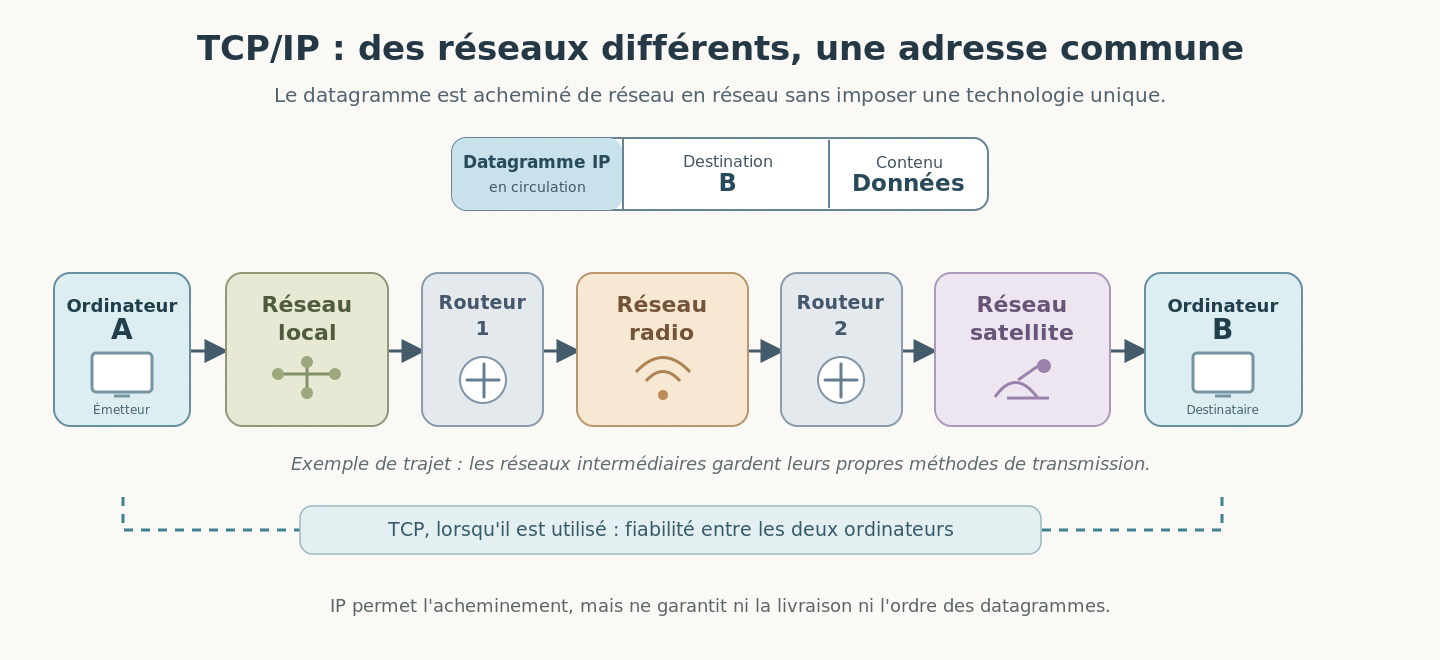
Cette liberté a une contrepartie importante. IP ne promet pas que chaque datagramme arrivera, ni qu’ils seront reçus dans l’ordre. Une liaison peut tomber en panne, un équipement peut être saturé et un paquet peut être abandonné. Deux datagrammes destinés au même ordinateur peuvent aussi suivre des chemins différents, selon l’état du réseau et les choix d’acheminement.
Autrement dit, le réseau fait de son mieux pour transporter les données. Mais s’il faut absolument tout recevoir, qui va vérifier le résultat ? C’est l’une des questions qui conduiront à distinguer TCP et IP.
1974 : Cerf, Kahn et l’idée d’un réseau de réseaux
Au sein de l’agence américaine ARPA, Robert Kahn travaille sur la communication entre réseaux de nature différente. Il s’associe à Vinton Cerf, qui a déjà participé au développement des protocoles d’ARPANET.
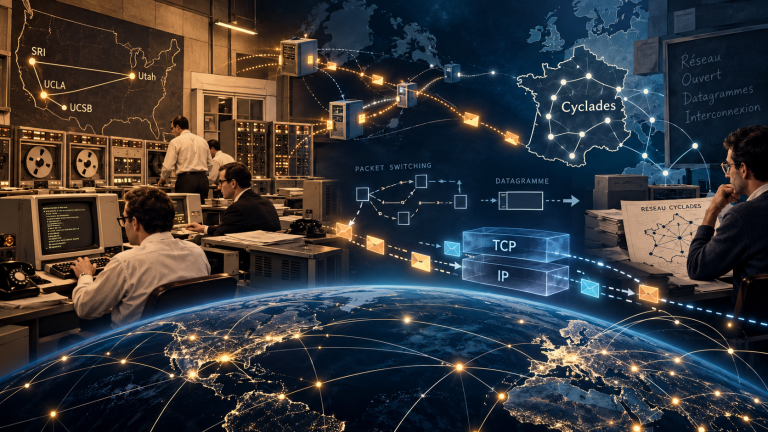
Leur réflexion prend forme au cours de 1973. En mai 1974, ils publient dans la revue IEEE Transactions on Communications un article intitulé A Protocol for Packet Network Intercommunication. Ils y proposent une architecture destinée à faire communiquer des réseaux de commutation de paquets sans imposer à chacun une organisation identique.
Il faut cependant éviter une confusion : le protocole présenté en 1974 n’est pas encore exactement le couple TCP/IP que nous utilisons aujourd’hui. Le projet initial réunit dans un même ensemble plusieurs fonctions de transport et d’interconnexion. Les expérimentations vont progressivement conduire à mieux les séparer.
Ces recherches ne se déroulent pas isolément. En France, Louis Pouzin et l’équipe du réseau Cyclades explorent une architecture fondée sur les datagrammes, dans laquelle les ordinateurs situés aux extrémités prennent en charge une partie importante du contrôle des échanges. Les travaux circulent entre équipes internationales.
Cette filiation est documentée : la RFC 675, publiée en décembre 1974 par Vinton Cerf, Yogen Dalal et Carl Sunshine, cite plusieurs publications de Pouzin et de ses collaborateurs. Il serait donc inexact d’attribuer l’ensemble de ces idées à une seule personne ou à un seul pays.
À la fin des années 1970, l’architecture évolue vers une répartition plus nette des responsabilités : IP pour l’acheminement entre réseaux et TCP pour un transport fiable lorsque les applications en ont besoin.
TCP et IP : deux rôles différents, mais complémentaires
Leurs noms sont souvent accolés, au point qu’on pourrait croire qu’il s’agit d’un unique protocole. En réalité, ils ne résolvent pas le même problème.
IP : acheminer les datagrammes sans garantir leur livraison
IP (Internet Protocol) fournit des adresses et les règles permettant d’acheminer des datagrammes d’un réseau à l’autre. Les routeurs examinent les informations nécessaires et choisissent une prochaine étape.
Ce service est dit non garanti ou best effort : un datagramme peut être perdu, retardé ou arriver après un autre. IP ne se charge pas, à lui seul, de récupérer les données manquantes.
TCP : reconstituer un échange fiable
TCP (Transmission Control Protocol) intervient entre les ordinateurs qui communiquent. Lorsqu’une application utilise TCP, celui-ci numérote les données, détecte les portions manquantes, organise leur retransmission et les remet dans le bon ordre pour l’application.
Supposons qu’un chercheur transmette un fichier. Si un datagramme contenant une partie du transfert se perd, IP ne le récupère pas. TCP peut détecter qu’une partie des données manque et déclencher sa retransmission. Il remet ensuite les données reçues dans le bon ordre avant de les transmettre à l’application.
TCP ne rend donc pas les réseaux infaillibles : il fournit un mécanisme de fiabilité entre les deux extrémités de la communication.

Et le protocole de l’application ?
Reste à déterminer ce qu’on veut faire avec cette connexion. Pour transférer un fichier, les utilisateurs peuvent employer FTP ; pour ouvrir une session sur un ordinateur distant, Telnet était couramment utilisé. Plus tard, le Web fera largement appel à HTTP.
Ces protocoles applicatifs définissent les échanges nécessaires à un service. Ils s’appuient sur IP pour l’acheminement des données et sur un protocole de transport comme TCP ou UDP (User Datagram Protocol). Contrairement à TCP, UDP ne garantit ni la réception des données ni leur ordre d’arrivée. Il n’organise pas leur retransmission en cas de perte. Plus simple, il nécessite moins de mécanismes de contrôle. Il convient notamment à certaines applications en temps réel, comme la téléphonie sur Internet ou les jeux en ligne, où recevoir rapidement les nouvelles données peut être préférable à attendre la retransmission des anciennes.
TCP privilégie donc la fiabilité, tandis qu’UDP privilégie la simplicité et laisse à l’application le soin de gérer les éventuelles pertes.
Voilà l’un des atouts essentiels de cette architecture : chaque niveau répond à un problème distinct. On peut changer de réseau physique sans réinventer la messagerie ou le transfert de fichiers.
1981-1983 : quand TCP/IP devient la règle commune
Une bonne idée technique ne suffit pas à transformer des réseaux entiers. Pour que des systèmes développés par des équipes différentes puissent coopérer, il faut des spécifications précises, des logiciels compatibles et une transition soigneusement organisée.
En septembre 1981, deux documents jouent un rôle majeur : la RFC 791 définit Internet Protocol dans sa version IPv4, tandis que la RFC 793 décrit TCP. Ces publications ne marquent pas l’invention soudaine des protocoles ; elles formalisent le résultat de plusieurs années de travaux et d’essais.
Le défi suivant est très concret : remplacer NCP sur les ordinateurs d’ARPANET. La RFC 801, publiée en novembre 1981, fixe l’objectif d’une transition complète au 1er janvier 1983.
Le changement est parfois surnommé le flag day d’ARPANET. Les établissements ont dû adapter leurs logiciels et coordonner leurs installations. À partir de ce basculement, ARPANET utilise TCP/IP pour les communications entre ses hôtes. Ce n’est pas la création instantanée d’Internet, mais une étape décisive vers l’interconnexion de réseaux indépendants.
La diffusion des protocoles est aussi facilitée par les systèmes d’exploitation. En 1983, la distribution 4.2BSD issue d’UNIX intègre notamment une implémentation de TCP/IP, ce qui contribuera à son adoption dans les universités et sur de nombreuses machines.
Ce que TCP/IP a réellement changé
L’innovation n’est pas d’avoir permis, pour la première fois, à deux ordinateurs d’échanger un message : d’autres réseaux savaient déjà le faire. Elle est d’avoir rendu possible une communication commune à travers des réseaux de technologies différentes, sans exiger leur uniformité.
C’est pourquoi TCP/IP a pu accompagner des infrastructures qui n’existaient pas encore dans les années 1970. Les supports changent, les débits augmentent, les applications se multiplient, mais le principe demeure : des réseaux autonomes peuvent coopérer grâce à des règles partagées.
Pour replacer cette évolution dans un récit plus large, consultez notre article sur l’histoire d’Internet, d’ARPANET au Web. Le véritable apport de TCP/IP apparaît alors clairement : plutôt que de fabriquer un immense réseau unique, ses concepteurs ont rendu possible un réseau de réseaux.
Sources historiques
- Vinton Cerf et Robert Kahn, A Protocol for Packet Network Intercommunication, IEEE Transactions on Communications, mai 1974.
- RFC 675, décembre 1974 : première spécification du programme de contrôle de transmission, avec références aux travaux sur Cyclades.
- RFC 791 — Internet Protocol, septembre 1981, document historique sur IPv4.
- RFC 793 — Transmission Control Protocol, septembre 1981, spécification historique de TCP.
- RFC 801 — NCP/TCP Transition Plan, novembre 1981 : organisation du basculement de 1983.
- Internet Society, A Brief History of the Internet, synthèse rédigée avec la participation d’acteurs historiques du réseau.