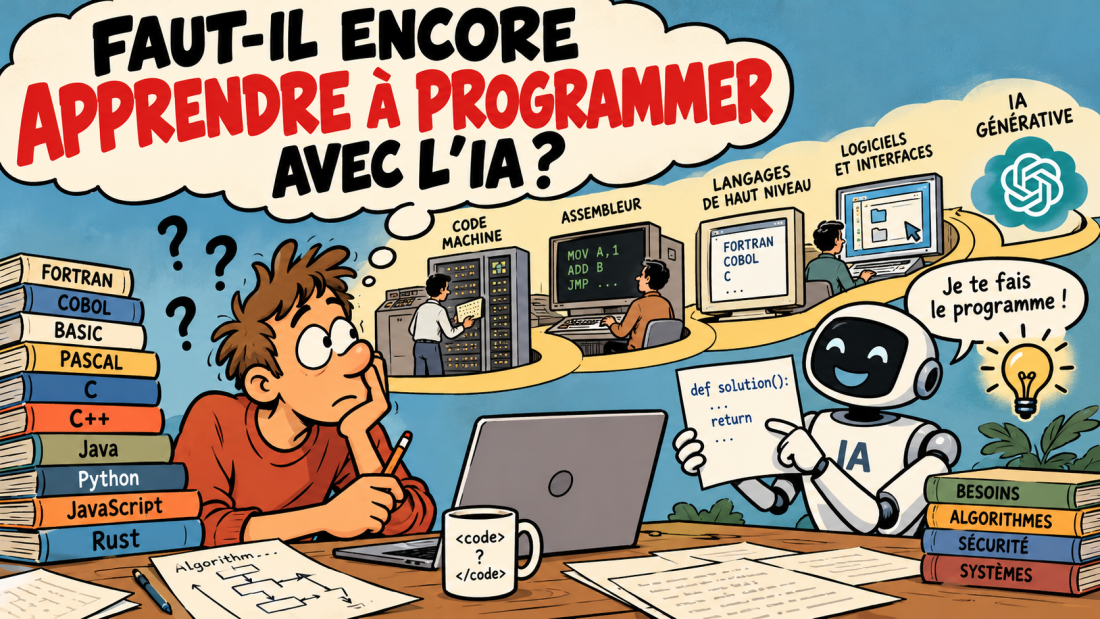
Faut-il encore apprendre à programmer quand l’IA écrit le code ?
Quand la machine a commencé à programmer
Dans les années 1940, programmer peut signifier régler des commutateurs, connecter des câbles ou préparer des instructions numériques. Les ordinateurs à programme enregistré permettent ensuite de conserver ces instructions en mémoire, mais leur écriture reste intimement liée au matériel.
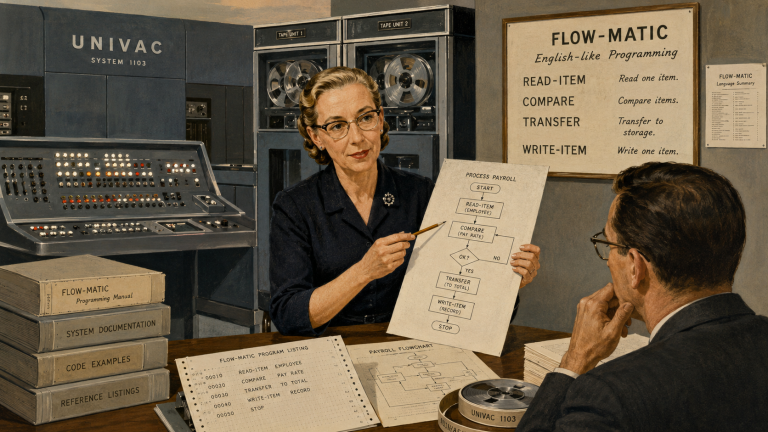
L’assembleur constitue un premier progrès : le programmeur emploie des symboles plutôt que des codes numériques. Un logiciel effectue la traduction. En 1952, Grace Hopper et son équipe vont plus loin avec A-0, un système qui automatise l’utilisation de sous-programmes existants. Il ressemble, par certains aspects, aux chargeurs et éditeurs de liens modernes.
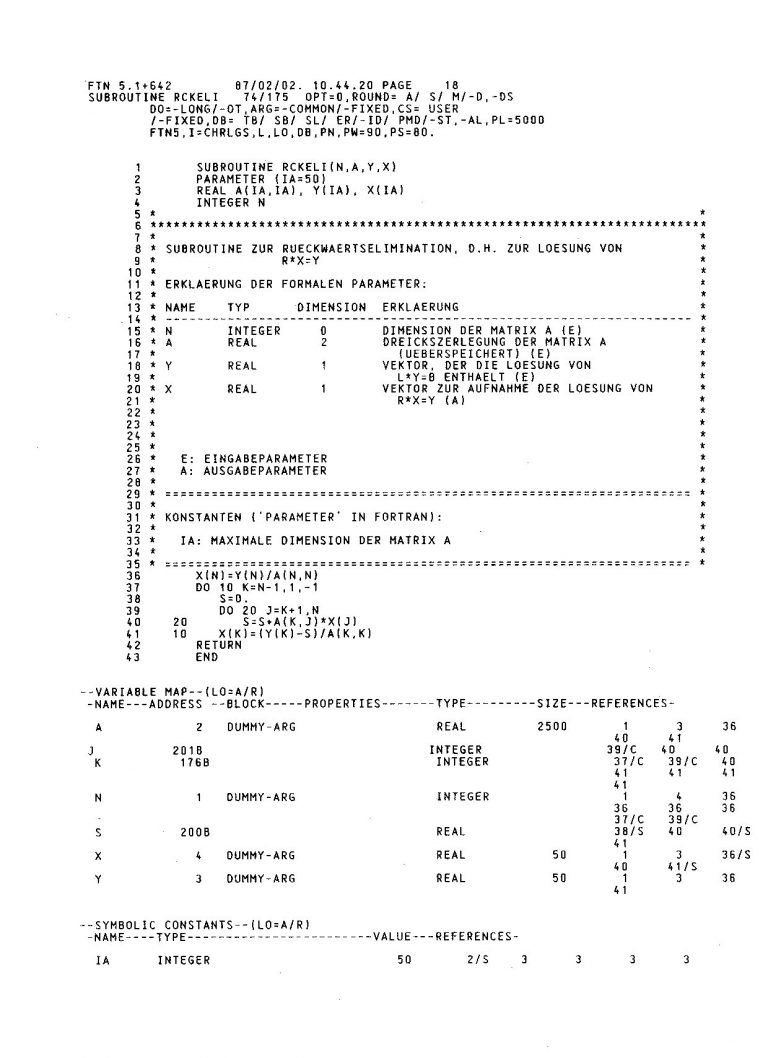
En 1957, FORTRAN marque une étape majeure dans l’histoire de la programmation. Sur l’IBM 704, les scientifiques peuvent désormais écrire leurs calculs dans une notation proche des mathématiques, sans détailler chaque instruction du processeur.
Cette avancée repose sur une innovation essentielle : le compilateur. Ce programme lit les instructions écrites en FORTRAN, les analyse et les traduit automatiquement en code machine exécutable. C’est un véritable saut technologique : une partie du travail intellectuel auparavant effectué par le programmeur est désormais confiée à l’ordinateur. Le scientifique choisit toujours ses calculs et ses méthodes, mais n’a plus à maîtriser leur traduction en instructions élémentaires.
La nouveauté suscite pourtant des doutes : une traduction automatique peut-elle rivaliser avec le travail d’un spécialiste de l’assembleur ? Les performances du compilateur FORTRAN contribuent à convaincre les sceptiques.
Progressivement, programmer directement en langage machine, puis en assembleur, cesse d’être indispensable pour la majorité des développeurs. Ces savoir-faire ne disparaissent pas, mais deviennent plus spécialisés. L’histoire nous offre ainsi un précédent frappant : l’IA pourrait, à son tour, rendre moins nécessaire la maîtrise de compétences autrefois essentielles à la programmation.
Des langages pour des besoins différents
Les langages ne sont pas de simples versions successives d’un même outil. FLOW-MATIC et COBOL facilitent la gestion. BASIC, créé en 1964, ouvre davantage la programmation aux étudiants. Pascal encourage une construction plus méthodique des programmes.
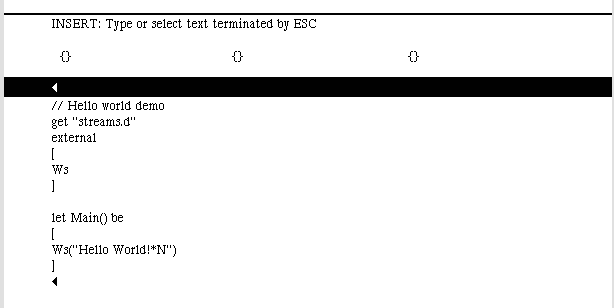
Le C permet de développer des logiciels comme UNIX en restant proche du matériel. Python privilégie une écriture expressive ; JavaScript rend le Web interactif ; SQL sert à interroger les bases de données. Rust cherche notamment à prévenir certaines erreurs de mémoire avant l’exécution. Chacun répond à des contraintes différentes de performance, de sécurité ou de développement.
Les interfaces graphiques suivent une autre voie. À partir des années 1980, elles permettent de travailler sans programmer. Puis Scratch, lancé en 2007, propose aux élèves d’assembler des blocs pour créer des jeux. Des outils comme mBlock appliquent également ce principe à certaines cartes Arduino. La syntaxe s’efface, mais il faut encore penser les conditions, les boucles et les actions.
À chaque étape, l’interface demande moins de détails à l’humain. L’IA franchit un seuil supplémentaire : elle peut proposer elle-même ces détails et parfois organiser l’ensemble du programme.
Quand l’IA devient développeur
Un compilateur traduit un programme rédigé selon des règles précises. Une IA générative tente d’interpréter une demande ordinaire : « Crée un jeu de plates-formes. » Elle peut alors écrire le code, construire une interface et proposer des tests.
Avec un agent comme Codex, l’automatisation dépasse la production de quelques lignes. L’outil peut parcourir les dossiers d’un projet, lire des fichiers, les modifier et exécuter des commandes. Selon les autorisations, il peut aussi créer un commit Git pour enregistrer les modifications, puis effectuer un push vers un dépôt distant. Une tâche entière de développement peut ainsi être déléguée.
Dans l’enquête Stack Overflow 2026, 65,9 % des répondants déclarent utiliser des assistants ou agents de codage au travail ; 26,2 % utilisent des agents ou flux automatisés. Ces chiffres proviennent d’une enquête volontaire, non d’un recensement de la profession.
Plus de code, mais pas nécessairement plus vite
Une étude de METR a mesuré en 2025 un ralentissement moyen de 19 % sur certaines tâches réalisées par des développeurs expérimentés avec les outils évalués. En février 2026, METR jugeait des gains plausibles avec des outils plus récents, sans pouvoir les mesurer solidement. Produire plus vite du code ne garantit pas de terminer plus vite un logiciel fiable.
Imaginons un agent chargé d’ajouter une recherche à un site. Il doit comprendre les règles de gestion et une base de données qui peut elle-même contenir des erreurs. Le code généré risque d’être correct, mais de reposer sur une analyse fausse. L’agent peut aussi modifier des fichiers ou lancer des commandes aux conséquences imprévues.
Autre difficulté : il peut produire des milliers de lignes plus vite que le développeur ne peut les comprendre. Quand survient une panne, celui-ci risque de ne plus maîtriser les choix techniques de son propre projet. La dette technique peut alors augmenter : un programme fonctionne aujourd’hui, mais chaque correction devient plus difficile. L’IA peut aider à l’analyser ; encore faut-il pouvoir juger ses propositions.
Le risque d’oublier ce que l’on délègue
La calculatrice a rendu moins nécessaire la pratique quotidienne du calcul mental ; les compilateurs ont réduit celle de l’assembleur. Avec l’IA, la même question se pose pour l’algorithmique et la programmation. Une compétence peu exercée peut devenir plus difficile à mobiliser.
Des travaux de psychologie publiés en 2010 montrent que nous privilégions souvent les tâches demandant moins d’effort cognitif. Ils ne prouvent pas que l’usage de l’IA fait perdre des compétences, mais éclairent notre tendance à déléguer. Le risque serait de dépendre toujours davantage d’un outil que l’on sait de moins en moins remplacer.
Faut-il encore du code source ?
Si une IA peut écrire du Python ou du Rust, pourquoi ne produirait-elle pas directement un exécutable ? Après tout, le processeur exécute des instructions propres à son architecture, non les textes de ces langages. En principe, rien n’impose de conserver un code source traditionnel.
En 2023, AlphaDev, développé par Google DeepMind, découvre des routines de tri performantes en explorant des séquences d’instructions assembleur. Ces résultats sont ensuite retranscrits en C++ pour intégrer la bibliothèque libc++ de LLVM. La recherche automatisée peut donc trouver des solutions efficaces à très bas niveau. Cela ne démontre pas qu’une IA sait fabriquer seule n’importe quel logiciel.
Produire un exécutable reste soumis aux règles du système d’exploitation et du processeur : le code x86-64 n’est pas directement exécutable sur ARM64. Surtout, comment corriger ou adapter facilement des milliers d’instructions opaques ?
Les compilateurs utilisent pour cela des représentations intermédiaires, formes structurées plus simples à analyser et transformer. MLIR illustre cette approche à plusieurs niveaux d’abstraction.
On pourrait aller plus loin et imaginer des langages conçus d’abord pour les IA : ils privilégieraient la génération, l’optimisation ou la vérification automatique plutôt que la lecture humaine. MLIR n’a pas été conçu spécialement pour cet usage, et les bénéfices d’un tel langage restent à démontrer.
Après avoir créé des langages pour aider les humains à programmer les machines, nous pourrions donc en inventer pour aider les IA à les programmer. Les langages ne disparaîtraient pas nécessairement : ils pourraient devenir invisibles voir illisibles pour les humains.
Le véritable défi : définir le besoin
Imaginons cette consigne : « Supprime les fichiers inutiles de mon ordinateur. » Une IA peut écrire le programme immédiatement. Mais qu’est-ce qu’un fichier inutile ? Une photo non ouverte depuis six ans ? Deux documents ayant le même nom ? Une ancienne sauvegarde ?
Il faut d’abord préciser les règles : quels dossiers examiner, quels fichiers préserver, quand demander confirmation et comment annuler une suppression. Cette description des résultats attendus et des contraintes constitue une spécification. L’IA peut aider à la rédiger, mais ne peut pas déduire la valeur affective d’un document d’une consigne aussi vague.
Cette difficulté se retrouve dans la santé, la banque ou les services publics. Un logiciel peut appliquer sans erreur une règle pourtant inadaptée. Il peut aussi réussir tous les tests prévus, mais échouer dans un cas oublié. Un test vérifie en effet une situation choisie ; il n’épuise pas tous les cas possibles. Même une preuve formelle repose sur des propriétés et des hypothèses définies au départ. Les langages formels facilitent l’examen de la solution ; ils ne déterminent pas, à eux seuls, si l’objectif est souhaitable.
Un programme peut être techniquement correct tout en répondant à la mauvaise question. L’IA déplace ainsi une partie de la difficulté : écrire les instructions devient plus facile que décider précisément ce qu’elles doivent accomplir.
Que faut-il encore apprendre ?
Tout dépend du but recherché. Pour un petit outil personnel, savoir décrire le besoin, contrôler les résultats et protéger ses données peut suffire. Pour construire une application professionnelle, comprendre les bases de données, les algorithmes, la sécurité et la maintenance reste précieux. Les spécialistes du matériel ont, eux, besoin de connaissances sur la mémoire, les processus et la compilation.
Dans l’enseignement, écrire soi-même un programme simple conserve une valeur particulière. Suivre une variable, comprendre une boucle et corriger une condition permettent d’acquérir des repères. Sans eux, comment évaluer une réponse de l’IA ? En revanche, mémoriser des pages de syntaxe n’a plus le même intérêt qu’autrefois.
Une formation peut donc combiner deux démarches : programmer pour comprendre, puis travailler avec l’IA pour concevoir et vérifier. Un exercice consiste à faire générer deux solutions au même problème, puis à rechercher leurs erreurs, comparer leurs performances et inventer des cas limites. L’élève découvre aussi qu’un résultat plausible n’est pas toujours juste. L’objectif n’est plus seulement de produire du code, mais de savoir expliquer ce qu’il fait et de conserver la capacité d’agir sans assistance.
Quel avenir pour les développeurs ?
Et si l’intelligence artificielle rendait l’expérience plus précieuse, plutôt que de la dévaloriser ? Une étude publiée dans Science en janvier 2026, portant sur plus de 160 000 développeurs, observe que les gains de productivité associés à l’IA bénéficient surtout aux programmeurs expérimentés. Chez les débutants, les chercheurs ne détectent pas de gain significatif. Ces résultats concernent l’activité sur GitHub et ne permettent pas de généraliser à tous les travaux de développement.
Cette tendance se retrouve dans le recrutement. Selon Indeed Hiring Lab, près de 69 % des offres américaines de développement logiciel visaient des profils seniors au premier trimestre 2026. Cela ne signifie pas que les entreprises recherchent spécifiquement des quinquagénaires, ni que l’IA explique seule cette évolution. Mais l’expérience semble conserver une valeur importante à l’heure où écrire du code devient plus facile.
Un paradoxe apparaît alors : comment former les experts de demain si l’on recrute moins de débutants et si l’IA accomplit les tâches qui leur permettaient d’apprendre ?
Une expérience publiée par Anthropic en 2026 apporte un éclairage. Parmi 52 développeurs apprenant une nouvelle bibliothèque Python, ceux utilisant l’IA ont obtenu en moyenne 50 % à un test de compréhension, contre 67 % sans assistance. Cette étude limitée rappelle que produire une solution ne signifie pas nécessairement acquérir les connaissances pour la comprendre ou la corriger.
L’IA pourrait ainsi renforcer la valeur de l’expérience tout en compliquant son acquisition. Les développeurs capables d’analyser une architecture, de repérer des erreurs et de prendre du recul sur les propositions de l’IA conserveraient un avantage. Mais cette situation pourrait évoluer avec les progrès des agents autonomes.
À cela s’ajoutent les incertitudes sur l’emploi, la sécurité, la confidentialité et les coûts de maintenance. Certains postes pourraient disparaître tandis que de nouvelles activités apparaîtraient, sans compensation garantie.
Et si demain une IA pouvait tout concevoir, programmer et maintenir ? Une grande partie de ces compétences pourrait à son tour devenir moins nécessaire. Mais qui déciderait alors des objectifs, des risques acceptables et des conséquences ? L’autonomie technique d’une machine ne ferait pas disparaître la responsabilité de ceux qui choisissent de l’utiliser.
Ce que l’histoire nous apprend
Depuis les premiers assembleurs, les informaticiens ont continuellement confié aux ordinateurs des opérations auparavant réalisées par les programmeurs. Les compilateurs ont réduit le besoin de connaître le langage machine. Les langages de haut niveau ont éloigné les développeurs du matériel. Les interfaces graphiques ont permis d’utiliser les logiciels sans apprendre à coder.
L’IA poursuit cette histoire, mais franchit une frontière : elle ne se contente plus de traduire nos instructions, elle participe à leur conception.
En 1984, devant son Thomson ou son Amstrad, notre adolescent découvrait aussi le plaisir de programmer. Il expérimentait, commettait des erreurs, cherchait à les comprendre, puis éprouvait la satisfaction de voir fonctionner ce qu’il avait construit. En 2026, il peut décrire son idée à une IA et lui laisser parcourir une grande partie du chemin. Il gagne du temps et de nouvelles possibilités, mais risque aussi, en déléguant systématiquement, de perdre des savoir-faire et une partie de ce plaisir de la découverte.
Car programmer ne se résume pas à obtenir un résultat. Comprendre pourquoi un algorithme fonctionne, résoudre une difficulté ou construire progressivement son propre logiciel peut procurer autant de satisfaction que le programme achevé. L’IA peut enrichir cette expérience, à condition de ne pas nous priver du plaisir d’apprendre et d’inventer.
Faut-il encore apprendre à programmer ? Pour certains usages, de moins en moins. Pour comprendre les machines, conserver son autonomie, mais aussi pour le simple plaisir de créer, cet apprentissage garde toute sa valeur. Après tout, nous ne faisons pas toujours les choses parce qu’elles sont nécessaires, mais aussi parce que nous aimons les faire.
Après avoir appris aux machines à exécuter nos instructions, nous leur apprenons à les concevoir. La question décisive devient alors : que choisirons-nous encore de comprendre et de maîtriser nous-mêmes ?
Sources historiques et techniques
- IBM et Dartmouth : FORTRAN et BASIC.
- Mankowitz et al., Nature (2023) : AlphaDev.
- Projet LLVM : représentations intermédiaires MLIR.
- Stack Overflow (2026) : usages déclarés de l’IA.
- METR (2025) et sa mise à jour (2026) : productivité.
- Kool et al. (2010) : effort cognitif et choix.
Pour approfondir : l’histoire des langages de programmation et l’histoire des compilateurs et des interpréteurs.