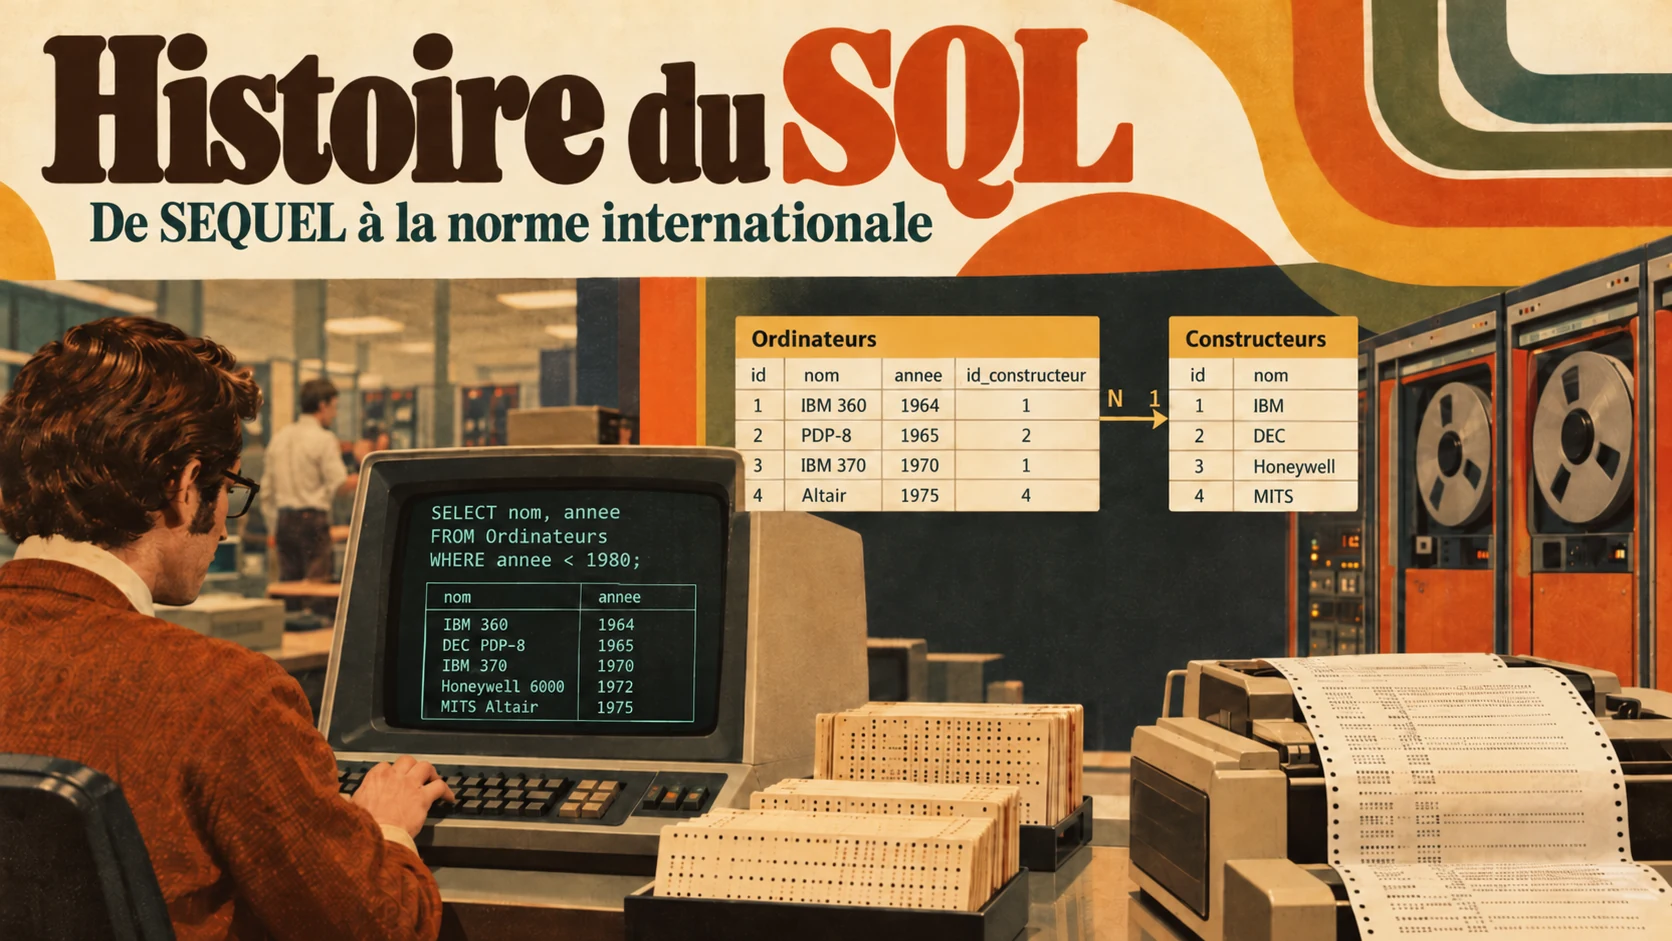
Histoire du SQL : de SEQUEL à la norme internationale
Au début des années 1970, les ordinateurs savent déjà conserver d’immenses quantités d’informations. Pourtant, retrouver les données correspondant à une question nouvelle reste souvent une affaire de spécialistes. Un responsable veut connaître les commandes d’un client ? Il peut falloir développer un programme qui sait où chercher et quels chemins suivre dans les fichiers.
Et si l’on pouvait simplement décrire le résultat souhaité, en laissant l’ordinateur trouver comment l’obtenir ? Cette idée, portée par le modèle relationnel d’Edgar Codd, conduit deux chercheurs d’IBM, Donald Chamberlin et Raymond Boyce, à présenter SEQUEL en mai 1974. Le futur SQL n’est pourtant ni une invention isolée ni un succès immédiat. Son histoire mêle recherches mathématiques, essais infructueux, débats entre scientifiques, concurrence industrielle et normalisation internationale.
Avant SQL : pourquoi interroger une base pouvait demander un programme
Dans les années 1960, les ordinateurs commencent à gérer les comptes bancaires, les stocks des magasins ou les dossiers administratifs. Pour conserver toutes ces informations, les entreprises utilisent des fichiers et des bases de données organisées selon des structures précises.
Ces systèmes remplissent efficacement les tâches auxquelles ils sont destinés. En revanche, retrouver une information demande souvent de connaître la manière dont les données sont organisées.
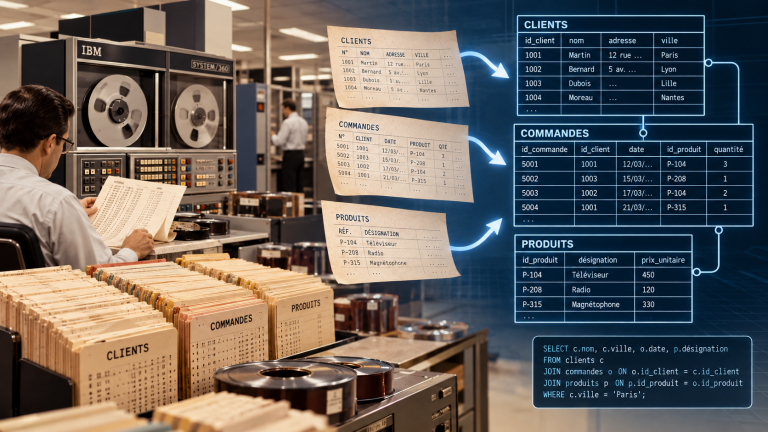
Imaginons un magasin qui conserve la liste de ses clients, de leurs commandes et des produits achetés. Pour savoir quels produits un client a commandés, le programme doit retrouver ce client, accéder à ses commandes, puis parcourir les produits associés.
Cette façon de travailler est appelée approche navigationnelle : le programme doit suivre un chemin précis à travers les données.
Le problème apparaît lorsqu’on souhaite poser une autre question, par exemple : « Quels clients ont acheté ce produit ? » Le parcours n’est plus le même. Il faut parfois écrire un nouveau programme ou modifier celui qui existe.
L’enjeu devient alors essentiel : pourrait-on demander directement à l’ordinateur quelle information on recherche, sans devoir lui expliquer chaque étape pour la retrouver ?
L’amélioration du stockage, illustrée notamment par l’IBM RAMAC 305, ou la puissance des grands systèmes comme l’IBM System/360, ne suffisent pas à résoudre cette difficulté. Le problème n’est pas uniquement de conserver l’information, mais de pouvoir l’interroger autrement. [1]
C’est sur ce point qu’un chercheur d’IBM propose, en 1970, une transformation profonde. Le contexte général est développé dans notre histoire des bases de données.
1970 : Edgar Codd sépare les questions du rangement des données
En juin 1970, Edgar F. Codd publie dans Communications of the ACM « A Relational Model of Data for Large Shared Data Banks ». Son ambition est de donner aux données une représentation logique indépendante, autant que possible, de leur organisation physique. L’utilisateur ne devrait pas avoir à préciser sur quel disque se trouve une information ni quels pointeurs doivent être suivis pour la retrouver. [1]
Le modèle relationnel repose sur une notion mathématique : la relation. Pour commencer à le comprendre, on peut imaginer des tableaux constitués de lignes et de colonnes. Les lignes décrivent des objets ; les colonnes correspondent à leurs propriétés. C’est une image utile, même si une relation mathématique n’est pas exactement la même chose qu’une table SQL moderne.
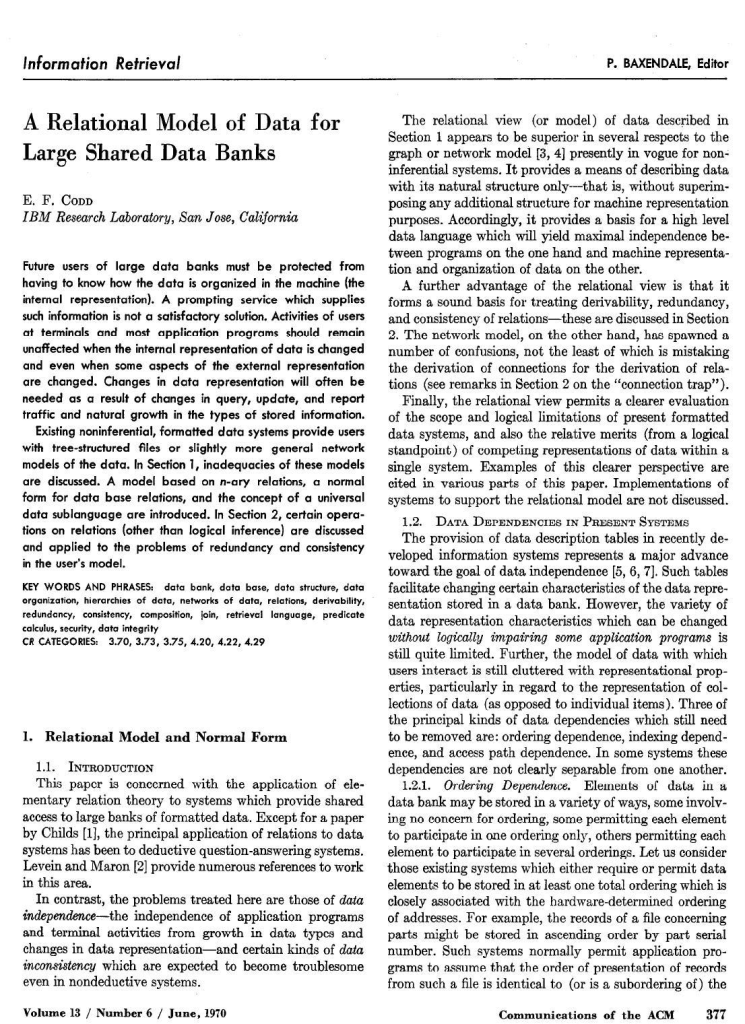
© 1970 ACM (Association for Computing Machinery). (https://doi.org/10.1145/362384.362685).
Un exemple concret : les ordinateurs d’un musée
Prenons un musée de l’informatique qui souhaite répertorier ses machines et leurs fabricants. Dans une première table, appelée Constructeurs, chaque fabricant possède un numéro unique : par exemple, 1 pour IBM et 2 pour DEC.
Dans une seconde table, Ordinateurs, le musée enregistre les caractéristiques de chaque machine : son nom, son année de fabrication et le numéro de son constructeur.
Ainsi, pour un IBM System/360, il suffit d’inscrire 1 dans la colonne id_constructeur. Ce numéro permet de retrouver IBM dans la table Constructeurs, sans avoir à recopier son nom. C’est précisément le rôle d’une clé étrangère : une colonne qui fait référence à une clé d’une autre table. Elle permet de relier des informations conservées séparément. Plusieurs ordinateurs peuvent avoir la valeur 1, puisque IBM a fabriqué plusieurs modèles. En revanche, dans notre exemple, chaque ordinateur ne possède qu’un seul constructeur.
On obtient ainsi une relation dite un-à-plusieurs : un constructeur peut être associé à plusieurs ordinateurs. Le lien est assuré directement par la clé étrangère, sans avoir besoin d’une troisième table.
Dès lors, il devient possible de rechercher, combiner et sélectionner les données à partir de leurs valeurs, sans programmer chaque déplacement parmi les enregistrements. Mais Codd n’invente pas SQL : il établit un modèle théorique. Il faut encore imaginer une manière pratique de poser les questions et rendre leur exécution suffisamment rapide.
1973 : SQUARE, une première tentative difficile à utiliser
Chez IBM, Donald Chamberlin et Raymond Boyce cherchent précisément un langage pour exploiter ces idées. Leur première tentative porte le nom de SQUARE, pour Specifying Queries As Relational Expressions. Le projet fait l’objet d’une communication scientifique en 1973. [2]
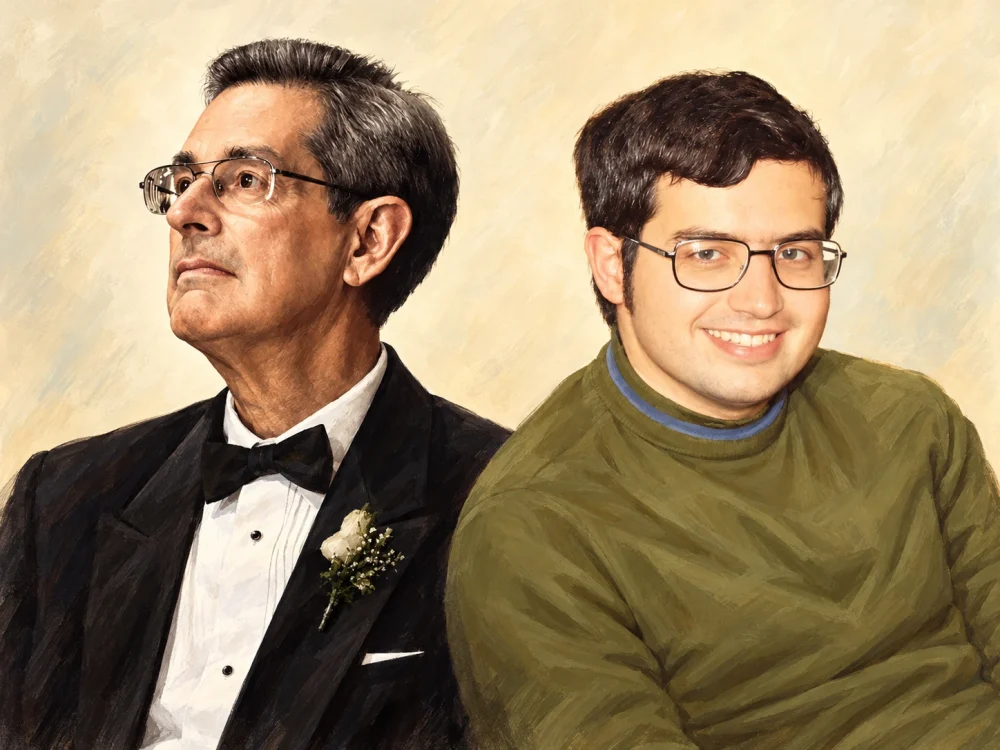
Illustration numérique réalisée à partir de deux photographies : Donald Chamberlin, 2009, © Dicklyon ; Raymond Boyce, portrait vers 25 ans, © Aflorzak. Sources : Wikimedia Commons, licence CC BY-SA 4.0.
Le problème paraît minuscule, mais il est révélateur : certaines notations de SQUARE utilisent des indices attachés aux noms de tables. Or les claviers ordinaires ne permettent pas de saisir facilement ces indices. Dans un entretien enregistré en 2009, Chamberlin reconnaît également qu’en regardant les expressions du langage, on ne comprenait pas immédiatement ce que la requête devait produire. [4]
Les deux chercheurs ne renoncent pas au modèle relationnel. Ils changent la manière de l’exprimer. Ils choisissent des mots anglais comme SELECT, FROM et WHERE, associés dans une syntaxe structurée. L’idée n’est pas de faire parler librement l’ordinateur : le langage reste formel. Mais ses instructions deviennent plus faciles à lire et à écrire.
Cette seconde tentative reçoit un nom approprié : SEQUEL, acronyme de Structured English Query Language.
Mai 1974 : SEQUEL entre dans un débat scientifique
Les 1er-3 mai 1974, la conférence ACM SIGFIDET se tient à Ann Arbor, dans le Michigan. Chamberlin et Boyce y présentent leur article « SEQUEL: A Structured English Query Language », daté du 1er mai 1974 dans les archives de l’ACM. Il décrit un langage permettant d’interroger une base relationnelle à l’aide de formulations structurées. [3]
La conférence est également le théâtre d’un affrontement d’idées. Charles Bachman défend les systèmes dans lesquels le programmeur navigue explicitement entre les données ; Edgar Codd défend l’indépendance apportée par le modèle relationnel. Selon le souvenir de Chamberlin, les deux conceptions y font l’objet d’un débat particulièrement suivi. [4]
Un détail éclaire les circonstances de cette présentation : faute de budget pour deux voyages, un seul des deux auteurs de SEQUEL peut assister à la conférence. C’est Boyce qui part à Ann Arbor. Chamberlin racontera plus tard avoir regretté de ne pas avoir vu ce débat. Quelques semaines après, en juin 1974, Boyce meurt prématurément. Le développement du langage continue, mais son rôle de co-inventeur reste essentiel. [4]
Par la suite, le mot SEQUEL sera abandonné pour une raison inattendue : il est déjà utilisé comme marque. Chamberlin explique avoir retiré les voyelles, donnant SQL, pour Structured Query Language. Le nom change ; le principe demeure. [4]
Avec SEQUEL, Chamberlin et Boyce ne proposent pas seulement une nouvelle façon d’écrire des commandes. Ils changent surtout la manière dont les utilisateurs peuvent interroger les données, en leur permettant d’indiquer ce qu’ils recherchent sans décrire les opérations nécessaires pour le retrouver.
Ce que SQL change : demander un résultat plutôt que décrire un parcours
Revenons aux ordinateurs du musée. Pour connaître les machines antérieures à 1980, une requête SQL actuelle peut s’écrire :
SELECT nom, annee
FROM Ordinateurs
WHERE annee < 1980;
La première ligne désigne les informations attendues, la deuxième indique la table, la troisième impose une condition. Le programmeur ne précise ni la position des enregistrements sur le disque, ni l’ordre dans lequel les lire, ni l’index à employer.
C’est la dimension déclarative de SQL : exprimer ce que l’on cherche, tandis que le système de gestion de base de données (SGBD) choisit comment exécuter la demande. Cette liberté n’est pas absolue, mais elle constitue une rupture avec la nécessité de programmer les chemins de navigation. [3]
Relier deux tables : la jointure d’hier à aujourd’hui
On peut également demander le fabricant de chaque ordinateur. La table Ordinateurs contient id_constructeur, qui renvoie à Constructeurs.id :
SELECT o.nom, c.nom AS constructeur
FROM Ordinateurs AS o
JOIN Constructeurs AS c
  ON o.id_constructeur = c.id;
Cette opération s’appelle une jointure. Elle permet de rapprocher les informations de deux tables grâce à une valeur commune. Ici, le numéro du constructeur permet d’associer chaque ordinateur à son fabricant.
Mais comment écrivait-on une jointure en 1974 ? Dans leur publication originale sur SEQUEL, Chamberlin et Boyce présentent cet exemple, qui rapproche deux tables lorsque leurs numéros d’article correspondent :
SALES, SUPPLY
WHERE SALES.ITEM = SUPPLY.ITEM
La syntaxe est différente : les deux tables sont simplement séparées par une virgule, et la condition de rapprochement figure dans WHERE. À l’époque, la clause SELECT n’était pas obligatoire : lorsqu’elle était absente, comme dans cet exemple, toutes les colonnes des deux tables étaient conservées.
Le principe demeure pourtant le même : associer les lignes dont certaines valeurs sont égales. L’opérateur = est d’ailleurs toujours utilisé aujourd’hui.
Au fil de son évolution, SQL s’est enrichi. La norme SQL-92 a notamment introduit la syntaxe explicite JOIN ... ON, qui permet de distinguer plus clairement les conditions de jointure des autres conditions de recherche. En SQL moderne, SELECT est devenu obligatoire pour une requête de consultation.
SQL permet aussi de modifier et de définir des données. Il ne correspond d’ailleurs pas parfaitement au modèle mathématique de Codd : les doublons et la valeur NULL, notamment, compliquent parfois le raisonnement. Mais un problème plus immédiat attend les chercheurs : une requête simple à écrire peut-elle être exécutée rapidement ?
System R : transformer une belle idée en système utilisable
Pour répondre, IBM développe System R, un système expérimental qui doit prouver qu’une base relationnelle peut fonctionner dans des applications exigeantes. C’est une étape indispensable : un langage élégant ne servirait pas longtemps si chaque interrogation immobilisait l’ordinateur. [5]
Une même demande peut emprunter plusieurs stratégies d’exécution. Pour retrouver des données, faut-il parcourir toute une table ou utiliser un index ? Pour rapprocher deux tables, laquelle examiner d’abord ? Ces choix peuvent faire varier considérablement le temps nécessaire.
Patricia Griffiths Selinger et ses collègues travaillent sur une solution : l’optimisation fondée sur les coûts. Le système compare plusieurs plans d’exécution selon des estimations de ressources, puis en choisit un. Leur publication de 1979 explique cette approche, devenue fondamentale dans les SGBD relationnels. [5]
System R montre ainsi que deux inventions se complètent : SQL permet d’énoncer une demande sans décrire les étapes, et l’optimiseur cherche une manière efficace de les réaliser. Il ne garantit pas le meilleur plan dans tous les cas, mais rend le modèle relationnel beaucoup plus pratique.
Le succès n’est pourtant pas écrit d’avance. Au même moment, une autre équipe américaine explore une voie concurrente.
Ingres et QUEL : une autre histoire était possible
À l’université de Californie à Berkeley, Michael Stonebraker, Eugene Wong, Gerald Held et leurs collaborateurs développent Ingres dans les années 1970. Leur projet met lui aussi en œuvre le modèle relationnel, mais utilise initialement un autre langage : QUEL. Un rapport universitaire de 1974 documente cette recherche. [6]
Aujourd’hui, il paraît naturel d’associer « base relationnelle » et « SQL ». À l’époque, ce rapprochement n’est pas inévitable. Le modèle de Codd fournit un cadre ; plusieurs équipes proposent des langages et des architectures pour l’exploiter. Ingres et System R ne constituent donc pas deux variantes d’un produit unique, mais des programmes de recherche concurrents.
Cette pluralité a donc une conséquence importante : la victoire commerciale de SQL ne prouve pas qu’il était la seule solution intellectuellement possible. Le choix d’un standard dépend aussi de la diffusion des logiciels, des décisions industrielles et de la compatibilité entre produits.
Stonebraker poursuivra ses recherches avec POSTGRES, lancé à Berkeley dans les années 1980 et à l’origine de PostgreSQL. Cette filiation rappelle que l’histoire des bases relationnelles ne se limite pas à IBM. [6]
1979-1987 : du laboratoire à la norme internationale
En 1977, Larry Ellison, Bob Miner et Ed Oates fondent Software Development Laboratories, bientôt devenue Relational Software. En 1979, la société commercialise Oracle Version 2, présentée par l’éditeur comme le premier système de gestion relationnel commercial fondé sur SQL. Le « 2 » du nom ne correspond pas à une version 1 déjà vendue. [7]
Il faut distinguer ici trois étapes : inventer un principe, construire un prototype et commercialiser un produit. Oracle joue un rôle majeur dans la troisième ; cela ne signifie pas qu’il a inventé le langage.
IBM transforme aussi ses recherches en produits : SQL/DS est annoncé en 1981, puis DB2, annoncé en 1983 et commercialisé sur MVS en 1985. Ces sorties contribuent à ancrer SQL dans l’informatique des entreprises. [8]
Reste à éviter que chaque fournisseur adopte une variante entièrement incompatible. En 1986, SQL fait l’objet d’une première norme américaine, ANSI X3.135-1986 ; une norme internationale suit en 1987, ISO 9075:1987. La normalisation définit un socle partagé sans effacer toutes les différences entre logiciels. [9]
À partir de là, le langage cesse d’être seulement l’outil d’un laboratoire ou d’un constructeur. Il devient une référence commune pour écrire des applications qui doivent accéder à des données dans des environnements variés.
Des années 1990 à aujourd’hui : pourquoi SQL a duré
Les normes évoluent, notamment avec SQL-92, SQL:1999 et la série ISO/IEC 9075:2023. Les SGBD comme PostgreSQL, MySQL, SQLite ou Oracle Database adoptent SQL tout en conservant des particularités de syntaxe et de comportement. Les approches dites NoSQL répondent, de leur côté, à d’autres besoins sans rendre inutiles les bases relationnelles. [9] [10]
Pour autant, ce succès ne signifie pas que SQL soit toujours facile. Les jointures complexes, les données manquantes, les performances et les dialectes exigent des connaissances. Dans son témoignage, Chamberlin lui-même constate que son espoir initial — voir des non-informaticiens rédiger directement de nombreuses requêtes — ne s’est réalisé qu’en partie. Beaucoup d’utilisateurs passent plutôt par des logiciels qui produisent du SQL pour eux. [4]
L’apport historique demeure : une personne peut formuler ce qu’elle veut savoir sans déterminer elle-même chaque étape de la recherche. Codd a fourni le modèle, Chamberlin et Boyce un langage, les équipes de System R des méthodes d’exécution, d’autres laboratoires des alternatives, et les éditeurs comme les organismes de normalisation ont contribué à sa diffusion.
SQL a ainsi traversé plus d’un demi-siècle non parce qu’il aurait supprimé la complexité des bases de données, mais parce qu’il a permis d’en confier une grande partie au logiciel.
Sources historiques : documents et témoignages
Les références ci-dessous ne sont pas de simples lectures complémentaires. Elles permettent de retrouver les publications originales, puis de distinguer les souvenirs rétrospectifs des auteurs, les archives techniques et les informations fournies par les éditeurs.
Articles fondateurs, recherches et témoignages
- Edgar F. Codd, « A Relational Model of Data for Large Shared Data Banks » (1970), Communications of the ACM. Texte fondateur du modèle relationnel. Source primaire pour l’indépendance des données et la représentation par relations.
- Raymond F. Boyce, Donald D. Chamberlin et collaborateurs, « Specifying Queries as Relational Expressions » (1973), IBM Research. Présentation de SQUARE. Document d’époque sur le langage antérieur à SEQUEL.
- Donald D. Chamberlin et Raymond F. Boyce, « SEQUEL: A Structured English Query Language » (1974), ACM SIGFIDET, p. 249-264. Publication originale chez IBM Research. Source primaire pour l’origine du langage ; publication datée du 1er mai 1974.
- Donald Chamberlin, entretien avec Paul McJones, Oral History of Donald Chamberlin (2009), Computer History Museum. Lire le témoignage intégral (PDF). Témoignage rétrospectif sur SQUARE, le débat de 1974, Boyce, le changement de nom et les intentions initiales.
- Patricia G. Selinger et collaborateurs, « Access Path Selection in a Relational Database Management System » (1979), ACM SIGMOD. Étude sur l’optimisation de System R. Publication technique originale expliquant le choix de plans d’exécution.
- G. Held, M. Stonebraker et E. Wong, « INGRES—A Relational Data Base System » (1974), University of California, Berkeley. Rapport universitaire archivé. Document historique permettant de replacer SQL dans un champ de recherches concurrentes.
Commercialisation et normes
- Oracle, Introduction to Oracle Database, rubrique historique. Historique institutionnel. Source de l’éditeur concernant la commercialisation d’Oracle V2 en 1979.
- IBM, « Patricia Selinger » et « Celebrating 40 years of Db2 ». Portrait historique d’IBM et chronologie officielle de DB2. Sources institutionnelles sur System R, SQL/DS et les dates d’annonce et de diffusion de DB2.
- ANSI, « The SQL Standard ». Chronologie de la normalisation. Repères concernant les normes de 1986, 1987 et 1992.
- ISO, ISO/IEC 9075-1:2023. Fiche officielle de la norme. Référence normative sur le cadre actuel de SQL.