Histoire des bases de données : des fichiers à SQL
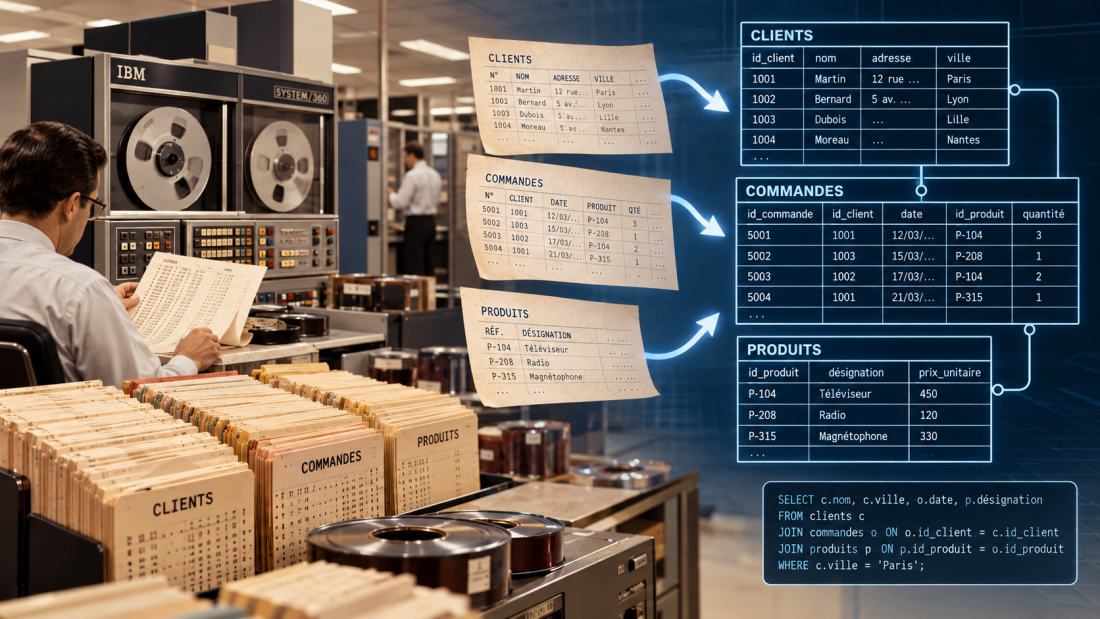
Imaginez une grande entreprise au milieu des années 1960. Son service commercial possède un fichier de clients, sa comptabilité conserve ses propres enregistrements et son service de livraison utilise encore un autre fichier. Tous contiennent des informations sur les mêmes personnes, mais aucun ne fonctionne exactement de la même manière.
Lorsqu’un client change d’adresse, il faut parfois corriger plusieurs fichiers. Une modification oubliée et les documents ne correspondent plus. Le problème n’est pas la puissance des ordinateurs : ils savent déjà traiter des milliers d’enregistrements. Le problème est la manière dont les informations sont organisées.
L’histoire des bases de données commence véritablement avec cette difficulté : comment conserver des informations cohérentes, les partager entre plusieurs programmes et les retrouver sans dépendre constamment de leur organisation physique ?
Des fichiers sur bandes magnétiques aux bases relationnelles, puis aux systèmes distribués, cette histoire raconte une transformation fondamentale. Les ordinateurs ne se contentent plus de stocker des enregistrements. Ils deviennent capables de gérer des ensembles d’informations complexes, partagés par des milliers, puis des millions d’utilisateurs.
Avant les SGBD : des fichiers et des redondances
Dans les années 1950, une grande partie de l’informatique de gestion repose sur des fichiers. Les informations sont enregistrées sur des cartes perforées, bande perforées, des bandes magnétiques et, progressivement, des disques.
Un fichier de clients contient par exemple une succession d’enregistrements. Chaque enregistrement possède des champs définis à l’avance : numéro de client, nom, adresse et éventuellement solde du compte.
Un programme écrit en COBOL peut parcourir ces informations pour produire une facture ou calculer un total. Mais il doit connaître précisément la structure des enregistrements qu’il manipule.
Le problème des fichiers séquentiels
Sur une bande magnétique, les données sont généralement lues dans un ordre séquentiel. Pour retrouver une information, le programme peut devoir parcourir les enregistrements les uns après les autres.
Cette organisation convient bien au traitement par lots. Par exemple, chaque nuit, un ordinateur peut lire l’ensemble des opérations bancaires de la journée pour mettre à jour les comptes.
Elle devient en revanche contraignante lorsqu’il faut retrouver immédiatement un client particulier ou modifier fréquemment une information.
L’arrivée des disques magnétiques et des méthodes d’accès indexé améliore considérablement la situation. Il devient possible de rechercher certains enregistrements sans parcourir systématiquement tout un fichier.

Mais un problème plus profond demeure : les programmes restent souvent étroitement liés à la structure physique des données.
Quand les programmes dépendent des fichiers
Supposons qu’une entreprise possède trois applications : la facturation, la gestion des stocks et le suivi des clients.
Chacune utilise ses propres fichiers. Le nom et l’adresse d’un client peuvent être enregistrés à plusieurs endroits. On parle alors de redondance des données.
Cette répétition présente plusieurs inconvénients :
- une même information doit être modifiée dans plusieurs fichiers ;
- des versions contradictoires peuvent apparaître ;
- les programmes doivent connaître les formats exacts des enregistrements ;
- une modification de structure peut obliger à adapter plusieurs applications.
Un simple changement, comme l’ajout d’un champ dans un enregistrement, peut donc entraîner des modifications dans plusieurs programmes.
La difficulté n’est plus seulement de stocker les données efficacement. Il faut pouvoir les gérer indépendamment des applications qui les utilisent.
C’est précisément ce besoin qui va favoriser l’apparition des systèmes de gestion de bases de données, ou SGBD.
Les premières bases de données
Au cours des années 1960, les entreprises et les administrations manipulent des volumes d’informations de plus en plus importants.
La diffusion des grands ordinateurs, notamment de l’IBM System/360, encourage le développement de logiciels capables de gérer des données partagées.
Les premiers SGBD ne fonctionnent pourtant pas comme les bases SQL actuelles. Ils reposent souvent sur deux grandes approches : les modèles hiérarchiques et les modèles en réseau.
IBM IMS : une base de données née du programme Apollo
En 1965, IBM et North American Aviation, futur Rockwell International, engagent une collaboration pour répondre aux besoins du programme spatial Apollo.
La construction des véhicules spatiaux nécessite le suivi d’immenses nomenclatures : composants, sous-ensembles, pièces de rechange et modifications techniques.
Il faut pouvoir retrouver rapidement les éléments nécessaires à la fabrication et vérifier leurs relations.
Les équipes développent un système initialement appelé ICS/DL/I. Une première version est livrée en 1967, puis le système est mis en service en 1968. Cette technologie devient ensuite IMS, pour Information Management System, diffusé par IBM sur ses grands ordinateurs.
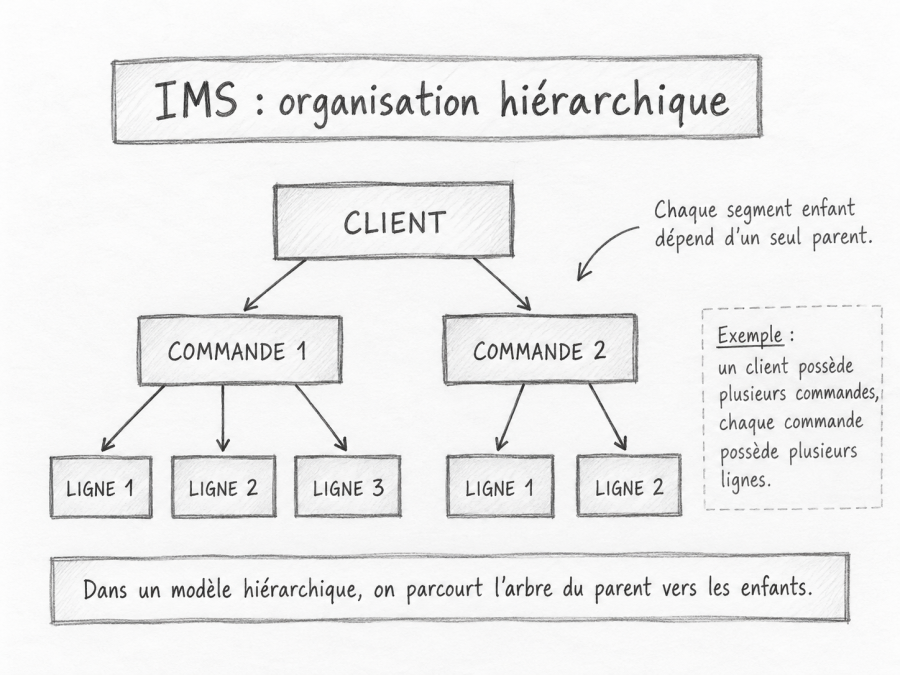
IMS utilise notamment un modèle hiérarchique. Les informations sont organisées selon une structure en arbre, comparable à une arborescence de dossiers.
Un enregistrement parent peut posséder plusieurs enfants. Par exemple, une commande contient plusieurs lignes de commande, chacune décrivant un produit et une quantité.
Cette organisation est efficace lorsque les relations suivent naturellement une hiérarchie. Mais elle impose des parcours déterminés par la structure des données.
Si l’on souhaite retrouver toutes les commandes contenant un produit particulier, la recherche peut être plus compliquée que lorsqu’on connaît déjà le client et sa commande.
IMS connaît néanmoins un immense succès dans les grandes organisations. Il associe gestion de données et traitement transactionnel, notamment dans les secteurs bancaire, industriel et administratif.
Il continue d’ailleurs d’évoluer bien après l’apparition des bases relationnelles.
Charles Bachman et les bases de données en réseau
Une autre approche apparaît chez General Electric au début des années 1960.
L’ingénieur Charles Bachman développe IDS, Integrated Data Store, l’un des premiers SGBD en réseau. Son objectif est de représenter des relations plus complexes qu’une simple structure en arbre.
Dans un modèle hiérarchique, chaque enregistrement enfant possède un seul parent dans la hiérarchie considérée. Un modèle en réseau autorise des structures plus souples, avec plusieurs relations entre les enregistrements.
Mais les programmes doivent généralement suivre explicitement les chemins d’accès définis dans la base. Cette façon de retrouver l’information est appelée navigationnelle.
Le programmeur ne demande pas simplement quelles données il souhaite obtenir. Il doit également indiquer comment parcourir les liens pour les atteindre.
Les travaux de Bachman influencent le Data Base Task Group de CODASYL, une organisation également impliquée dans la standardisation de COBOL.
Les rapports de 1969 et 1971 définissent une approche commune pour décrire et manipuler des bases en réseau.
Ces systèmes constituent une avancée considérable par rapport aux fichiers indépendants. Pourtant, leur complexité demeure importante. Les programmes restent encore trop dépendants des chemins d’accès aux informations.
C’est précisément cette dépendance qu’un chercheur d’IBM va remettre en question.
1970 : Edgar F. Codd révolutionne les bases de données
En juin 1970, dans la revue scientifique Communications of the ACM, le mathématicien et informaticien britannique Edgar Frank Codd, chercheur chez IBM à San Jose, publie un article dont l’influence sera considérable.
Son titre : A Relational Model of Data for Large Shared Data Banks.
Le texte ne présente pas un nouveau logiciel commercial. Il propose quelque chose de plus fondamental : une autre manière de représenter et de manipuler les données.
Une idée simple en apparence : organiser les données en relations
Codd s’appuie sur une notion mathématique, la relation, et propose de décrire les données indépendamment de leur organisation physique.
Une relation peut être représentée sous forme de tableau. Les colonnes correspondent aux attributs et les lignes aux tuples, c’est-à-dire aux enregistrements logiques.
Prenons l’exemple d’une entreprise. Une relation CLIENTS contient les identifiants et les noms des clients. Une seconde relation COMMANDES contient les identifiants des commandes et ceux des clients qui les ont passées.
Les deux ensembles d’informations sont associés grâce à leurs identifiants. Il n’est pas nécessaire de recopier le nom et l’adresse du client dans chaque commande.
Dans une base relationnelle classique, cette association sera notamment représentée par une clé étrangère, qui référence une clé d’une autre table.
Cette organisation permet de réduire certaines répétitions et de mettre en place des contraintes assurant la cohérence des informations.

Mais la nouveauté de Codd ne se limite pas à une présentation sous forme de tableaux.
Décrire le résultat plutôt que le chemin
Avec les bases navigationnelles, retrouver une information exige souvent de connaître la succession d’enregistrements à parcourir.
Avec le modèle relationnel, l’utilisateur peut exprimer la recherche à effectuer à partir des relations et de leurs attributs, sans imposer un parcours physique particulier.
Il devient possible de demander, par exemple : « Quels clients ont passé une commande au mois de mars ? »
Le système doit déterminer comment accéder aux données pour produire le résultat.
Cette séparation entre la description logique et l’organisation physique est essentielle. Les données peuvent être réorganisées, indexées ou déplacées sans nécessairement modifier les programmes qui les interrogent.
On parle d’indépendance des données.
Le modèle relationnel repose également sur des opérations mathématiques, notamment la sélection, la projection et la jointure, qui permettent de combiner des relations.
La normalisation, développée à partir des travaux de Codd, fournit ensuite des règles pour concevoir des structures limitant certaines redondances et anomalies de mise à jour.
Cette approche offre une base théorique beaucoup plus générale que les modèles reposant sur des parcours prédéfinis.
Codd n’a pas inventé SQL
Cette distinction est importante. En 1970, Codd propose un modèle théorique. Il ne crée ni Oracle, ni IBM DB2, ni le langage SQL.
Ses recherches indiquent comment représenter et manipuler logiquement les données. Il reste à démontrer qu’un ordinateur peut appliquer ces principes avec des performances suffisantes pour les entreprises.
C’est le défi que plusieurs équipes vont relever au cours des années 1970.
System R, Ingres et SQL : quand la théorie devient un logiciel
Une bonne idée mathématique ne suffit pas à convaincre l’industrie. Les bases hiérarchiques et en réseau sont déjà utilisées dans de grandes entreprises. Elles possèdent des logiciels, des équipes formées et des performances éprouvées.
Les chercheurs doivent donc démontrer que le modèle relationnel peut être utilisé dans de véritables applications.
Deux projets vont jouer un rôle particulièrement important : System R chez IBM et Ingres à l’université de Californie à Berkeley.
IBM System R : rendre le relationnel utilisable
Au milieu des années 1970, une équipe d’IBM développe System R, un système expérimental destiné à mettre en pratique les idées de Codd.
Le projet réunit notamment Donald Chamberlin, Raymond Boyce, Patricia Selinger et Raymond Lorie.
Un problème majeur apparaît : si l’utilisateur décrit simplement les données qu’il souhaite obtenir, comment le système choisit-il la meilleure manière de les retrouver ?
Une même recherche peut nécessiter différentes opérations, dans plusieurs ordres possibles. Certains parcours sont rapides, d’autres beaucoup plus coûteux.
Patricia Selinger et ses collègues contribuent à développer un optimiseur de requêtes fondé sur l’estimation des coûts.
Le système évalue différents plans d’exécution, notamment à partir des accès disque et des traitements nécessaires. Il peut ainsi choisir une stratégie adaptée sans exiger du programmeur qu’il détermine lui-même tous les parcours.
C’est une avancée décisive : les requêtes relationnelles deviennent suffisamment efficaces pour envisager des applications professionnelles.
De SEQUEL au langage SQL
Dans le cadre de ces recherches, Donald Chamberlin et Raymond Boyce développent un langage permettant d’interroger les données relationnelles.
Ils présentent en 1974 SEQUEL, pour Structured English Query Language. Son nom deviendra ensuite SQL, pour Structured Query Language.
L’objectif est de permettre aux utilisateurs d’exprimer leurs recherches avec des instructions relativement lisibles, sans devoir écrire des procédures de navigation entre les enregistrements.
Une requête comme celle-ci permet, par exemple, de retrouver les clients d’une ville :
SELECT nom
FROM Clients
WHERE ville = 'Carcassonne';
L’utilisateur précise le résultat attendu. Le SGBD se charge de déterminer comment accéder aux enregistrements nécessaires.
SQL permet également de rapprocher des tables par des jointures, de calculer des totaux, de regrouper des informations et de modifier les données.
Le langage contribue fortement à la diffusion des bases relationnelles, même si SQL et le modèle mathématique de Codd ne sont pas strictement identiques.
En particulier, SQL autorise certains comportements, comme les doublons dans les résultats et les valeurs NULL, qui demandent de distinguer le langage pratique du modèle relationnel théorique.
Ingres : une autre voie vers le relationnel
À Berkeley, Michael Stonebraker et Eugene Wong engagent, dès 1973, des recherches qui conduisent au système Ingres.
Avec leurs collaborateurs, ils développent un SGBD relationnel expérimental qui démontre qu’une autre approche que celle d’IBM est possible. Ingres n’utilise pas initialement SQL. Son principal langage d’interrogation est QUEL, également fondé sur les concepts relationnels.
Cette distinction est importante : dans les années 1970, rien ne garantit encore que SQL deviendra le langage dominant.
Les travaux de Berkeley contribuent à diffuser les principes relationnels dans le milieu universitaire et au-delà. Ils donneront naissance à des systèmes commerciaux et influenceront d’autres projets de recherche.
À partir de 1986, Michael Stonebraker dirige notamment le projet POSTGRES, dont descendra plus tard PostgreSQL.
1976 : Peter Chen facilite la conception des bases
Une autre contribution importante apparaît en 1976, lorsque Peter Chen publie ses travaux sur le modèle entité-association, connu en anglais sous le nom d’Entity-Relationship Model.
Son objectif est de représenter clairement les objets du monde réel, leurs propriétés et les relations qui les unissent, avant de choisir leur organisation dans une base.
Cette approche jouera un rôle majeur dans les méthodes de conception. Elle est notamment à l’origine de techniques de modélisation encore enseignées aujourd’hui. On distingue ainsi progressivement la conception conceptuelle des données, le modèle relationnel utilisé pour les représenter et le SGBD chargé de les stocker et de les exploiter.
Oracle, DB2 et l’essor des bases de données commerciales
À la fin des années 1970, les bases relationnelles ne sont plus seulement des prototypes de laboratoire. Les entreprises commencent à y voir une solution pour gérer leurs clients, leurs commandes, leurs stocks et leurs transactions.
Une nouvelle industrie logicielle apparaît.
1979 : Oracle commercialise SQL
En 1977, Larry Ellison, Bob Miner et Ed Oates fondent Software Development Laboratories, une entreprise qui prendra ensuite le nom de Relational Software, puis d’Oracle.
Les fondateurs s’intéressent aux recherches relationnelles d’IBM et comprennent leur potentiel commercial.
En 1979, leur société commercialise Oracle Version 2, considéré comme le premier SGBD relationnel commercial intégrant SQL.
La première version avait été développée auparavant, mais n’avait pas été officiellement commercialisée. Le choix du numéro 2 accompagne donc le lancement effectif du produit.
Oracle montre qu’une technologie encore expérimentale quelques années plus tôt peut devenir un logiciel destiné aux entreprises.
IBM DB2 et la diffusion du modèle relationnel
IBM poursuit également ses travaux. Après System R, le constructeur propose SQL/DS au début des années 1980, puis lance DB2 en 1983 pour ses grands systèmes.
DB2 reprend les principes relationnels et s’appuie sur l’expérience acquise avec System R. Le développement de ces produits favorise la diffusion de SQL, qui devient progressivement un langage commun à de nombreux systèmes de bases de données.
Une première norme américaine est publiée en 1986, puis une norme internationale ISO en 1987.
La standardisation facilite l’apprentissage et la portabilité des applications. Toutefois, les différents constructeurs conservent des extensions et des particularités propres à leurs produits.
Il est donc important de distinguer quatre éléments : le modèle relationnel proposé par Codd, les SGBD comme Oracle ou DB2, le langage SQL et les normes qui en définissent les caractéristiques.
Les transactions : une exigence devenue fondamentale
Le succès des SGBD ne repose pas uniquement sur la facilité des recherches. Les organisations doivent aussi garantir la fiabilité des opérations.
Imaginons un virement bancaire de 100 euros entre deux comptes. Deux modifications sont nécessaires : retirer 100 euros du premier compte et ajouter 100 euros au second.
Que se passe-t-il si l’ordinateur tombe en panne après la première opération, mais avant la seconde ?
Pour éviter ce type de problème, les SGBD utilisent des transactions. Une transaction regroupe des opérations qui doivent respecter certaines garanties.
Ces garanties sont généralement résumées par l’acronyme ACID :
- Atomicité : une transaction réussit entièrement ou ses modifications ne sont pas validées.
- Cohérence : elle doit préserver les contraintes définies pour la base de données.
- Isolation : les transactions simultanées sont contrôlées pour limiter leurs interférences, selon le niveau d’isolation choisi.
- Durabilité : les modifications validées doivent survivre aux pannes couvertes par les garanties du système.
Les mécanismes permettant d’obtenir ces propriétés sont issus de plusieurs décennies de recherches sur le traitement transactionnel, la concurrence et la récupération après incident.
Les termes ACID sont notamment formalisés dans un article de Theo Härder et Andreas Reuter publié en 1983.
Ces principes contribuent à faire des SGBD des éléments essentiels des banques, des assurances, des compagnies aériennes et, plus tard, du commerce électronique.
Des bases relationnelles aux données distribuées
Durant les années 1980 et 1990, les systèmes relationnels s’imposent dans de nombreux domaines. Ils évoluent avec les architectures client-serveur, les réseaux d’entreprise et les ordinateurs personnels.
De nouveaux acteurs apparaissent. MySQL et PostgreSQL participent notamment à la diffusion de bases relationnelles libres ou ouvertes, utilisées dans de très nombreuses applications.
Mais le développement du Web transforme progressivement les besoins.
Un service en ligne peut désormais gérer des millions d’utilisateurs, des catalogues considérables, des messages, des photographies et des données produites en continu.
La question n’est plus seulement de bien organiser les informations. Il faut également savoir les répartir sur plusieurs machines et maintenir le service lorsque certains équipements deviennent indisponibles.
Pourquoi répartir les données entre plusieurs ordinateurs ?
Un SGBD peut utiliser des index, des caches et des machines puissantes pour accélérer les recherches. Mais à très grande échelle, certaines applications nécessitent de distribuer les données et les traitements entre plusieurs serveurs.
Cette démarche n’apparaît pas avec le Web : les bases de données distribuées font déjà l’objet de recherches dans les années 1970 et 1980.
Avec Internet et les grands services numériques, elle prend cependant une importance nouvelle.
Les concepteurs doivent résoudre des difficultés supplémentaires : comment retrouver une information située sur une autre machine ? Que faire lorsqu’un serveur tombe en panne ? Comment maintenir des données cohérentes malgré les interruptions de communication ?
Ces questions vont favoriser l’apparition de nombreuses architectures.
Bigtable, Dynamo et l’essor de NoSQL
En 2006, des chercheurs de Google publient un article présentant Bigtable, un système de stockage distribué conçu pour gérer des volumes considérables de données structurées.
En 2007, Amazon présente Dynamo, une architecture de stockage clé-valeur mettant notamment l’accent sur la disponibilité et la résistance aux pannes.
Ces travaux participent à un mouvement plus large associé au terme NoSQL, particulièrement popularisé à la fin des années 2000.
NoSQL ne désigne pas un modèle unique. On y regroupe notamment :
- les bases clé-valeur, qui associent une clé à une valeur ;
- les bases documentaires, qui stockent des documents structurés ;
- les bases orientées colonnes ou familles de colonnes ;
- les bases de graphes, adaptées à certaines relations fortement interconnectées.
Ces systèmes offrent des compromis différents en matière d’organisation des données, de performances, de cohérence et de disponibilité.
Il serait pourtant faux d’affirmer que NoSQL remplace SQL ou que les bases relationnelles sont devenues obsolètes.
Les systèmes relationnels ont eux-mêmes évolué pour prendre en charge la réplication, le partitionnement et les architectures distribuées. Inversement, certains systèmes NoSQL proposent aujourd’hui des transactions et des langages d’interrogation élaborés.
Le choix dépend avant tout de la nature des données et des besoins de l’application.
Une même ambition depuis les années 1960
Plus d’un demi-siècle après les travaux de Codd, les technologies ont profondément changé.
Les données peuvent être stockées sur des disques à mémoire flash, réparties dans plusieurs centres informatiques ou traitées par des services accessibles depuis le monde entier.
Les SGBD proposent désormais des fonctions très diverses, allant des recherches relationnelles classiques aux analyses massives, aux données géographiques et aux recherches vectorielles utilisées dans certaines applications d’intelligence artificielle.
Pourtant, le problème fondamental reste remarquablement proche de celui des années 1960 : comment organiser des informations pour qu’elles demeurent accessibles, cohérentes et exploitables indépendamment des applications qui les utilisent ?
L’histoire des bases de données ne raconte donc pas simplement le passage des fichiers à SQL. Elle illustre une transformation plus profonde de l’informatique : les données deviennent une ressource commune, gérée par des systèmes spécialisés, plutôt qu’un simple ensemble d’enregistrements attachés à un programme.
Pour replacer cette évolution dans son contexte, retrouvez notre histoire générale de l’informatique, ainsi que l’histoire des langages de programmation qui ont accompagné le développement des systèmes d’information.
Sources historiques et références
- Edgar F. Codd, A Relational Model of Data for Large Shared Data Banks, Communications of the ACM, juin 1970. Publication fondatrice du modèle relationnel.
- IBM — Information Management System. Origines d’IMS, programme Apollo et premières applications commerciales.
- Computer History Museum — Charles W. Bachman. Développement d’IDS et contribution au modèle en réseau.
- IBM — The Relational Database. Travaux de Codd, développement de System R et naissance de DB2.
- Chamberlin et Boyce — SEQUEL: A Structured English Query Language, 1974. Présentation du langage précurseur de SQL.
- Held, Stonebraker et Wong — INGRES: A Relational Data Base System, université de Berkeley, 1974.
- Peter Chen — The Entity-Relationship Model, ACM Transactions on Database Systems, 1976.
- Härder et Reuter — Principles of Transaction-Oriented Database Recovery, ACM Computing Surveys, 1983.
- PostgreSQL — A Brief History of PostgreSQL. De POSTGRES à Berkeley au développement de PostgreSQL.
- Google Research — Bigtable, 2006, et Amazon — Dynamo, 2007. Deux références importantes sur les systèmes distribués modernes.