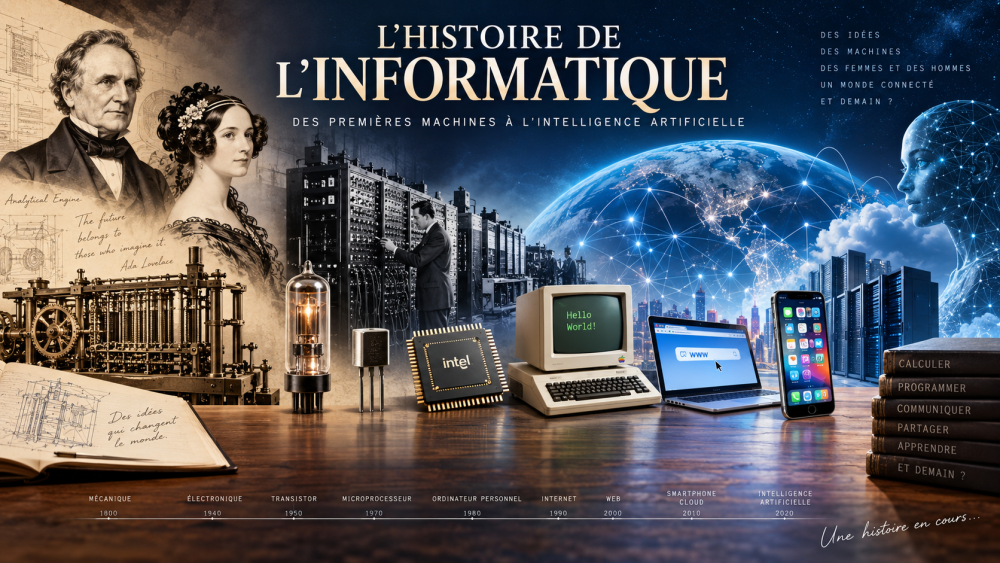
L’histoire de l’informatique raconte comment des machines conçues pour calculer sont devenues des outils pour écrire, créer, communiquer et, désormais, dialoguer avec une intelligence artificielle. Comment est-on passé des engrenages de Charles Babbage aux ordinateurs électroniques, puis aux smartphones et à ChatGPT ? Ce parcours traverse près de deux siècles d’inventions, de paris industriels et de recherches parfois longtemps restées sans application.
Cette transformation ne suit pas une route unique. Tandis que certains ingénieurs miniaturisent les circuits, d’autres inventent des langages de programmation ou cherchent à relier les machines. Leurs travaux finissent par se rencontrer et ouvrent des possibilités que leurs auteurs n’avaient pas toujours envisagées. Voici les grandes étapes de cette histoire, avec des liens pour explorer plus en détail les personnages et les inventions qui l’ont façonnée.
Les origines de l’informatique : de Babbage à Ada Lovelace
Bien avant l’ordinateur, Pascal, Leibniz et d’autres cherchent déjà à mécaniser certaines opérations arithmétiques. Au XIXe siècle, Charles Babbage va beaucoup plus loin. Avec sa machine analytique, il imagine une machine générale dont le comportement ne dépendrait plus seulement de sa mécanique, mais des instructions qu’on lui fournit. Il reprend notamment le principe des cartes perforées des métiers Jacquard : au lieu de commander le dessin d’un tissu, elles doivent commander une suite d’opérations.
La machine de Babbage ne sera jamais achevée de son vivant, mais Ada Lovelace en explore la portée. Dans les notes qu’elle publie en 1843, elle décrit une méthode de calcul des nombres de Bernoulli, mais surtout elle comprend qu’une machine programmable pourrait manipuler autre chose que des quantités si ces informations étaient représentées par des symboles. Elle imagine même qu’un jour une telle machine puisse travailler sur la musique. L’idée essentielle est déjà là : une même machine pourrait accomplir des tâches différentes selon le programme qu’on lui donne. Il faudra encore près d’un siècle pour que des machines programmables deviennent opérationnelles, d’abord avec des dispositifs électromécaniques, puis grâce à l’électronique.
1940-1948 : naissance de l’ordinateur moderne
Les années 1930 et surtout la Seconde Guerre mondiale accélèrent brutalement les recherches. Il faut calculer des trajectoires balistiques, analyser des messages chiffrés et résoudre des problèmes scientifiques complexes. Plusieurs équipes construisent presque simultanément des machines nouvelles : le Z3 de Konrad Zuse utilise des relais électromécaniques, Colossus travaille à Bletchley Park sur la cryptanalyse et l’ENIAC est développé aux États-Unis pour l’armée. Il est donc difficile de désigner un unique « premier ordinateur » : tout dépend de ce que l’on entend par programmable, électronique, généraliste ou à programme enregistré. Cette question mérite à elle seule une explication.
Parmi ces machines, l’ENIAC frappe les imaginations. Présenté au public en 1946, il contient près de 18 000 tubes à vide, pèse plusieurs dizaines de tonnes et peut effectuer environ 5 000 additions par seconde. Mais cette puissance révèle une contradiction : effectuer les calculs devient rapide, alors que préparer la machine pour un nouveau problème reste long et laborieux. La solution consiste à placer non seulement les données, mais aussi les instructions du programme dans la mémoire. Les travaux autour d’EDVAC, de J. Presper Eckert, John Mauchly et John von Neumann contribuent à formaliser et à diffuser ce principe. Alan Turing avait, de son côté, montré sur le plan théorique qu’une machine universelle pouvait exécuter des calculs différents en changeant les instructions ; son projet ACE donnera plus tard naissance au Pilot ACE.
Le 21 juin 1948, une petite machine expérimentale de l’université de Manchester apporte une démonstration décisive. Le Manchester Baby exécute avec succès un programme conservé dans sa mémoire électronique. Son premier programme n’a rien de spectaculaire, mais le principe est fondamental : pour changer le travail de l’ordinateur, il n’est plus nécessaire de modifier son câblage. Le programme peut désormais être chargé et modifié en mémoire : cette souplesse va devenir l’un des fondements de l’informatique moderne.
Le transistor et le circuit intégré : l’ordinateur rétrécit
Pendant que les chercheurs mettent au point le programme enregistré, une autre transformation se prépare dans les composants électroniques. Les ordinateurs à tubes restent énormes. Les tubes électroniques consomment beaucoup d’énergie, produisent de la chaleur et prennent de la place. Aux Bell Laboratories, John Bardeen et Walter Brattain obtiennent en décembre 1947 une amplification électrique avec un petit cristal de germanium. Le transistor vient de montrer son potentiel : une fonction réalisée jusque-là par un tube peut tenir dans un composant minuscule.
William Shockley, qui dirige l’équipe, développe ensuite le transistor à jonction. En 1956, il installe son laboratoire en Californie et recrute de jeunes ingénieurs particulièrement brillants. Son style de direction provoque pourtant une rupture : en 1957, huit chercheurs quittent William Shockley et fondent Fairchild Semiconductor. Cette défection devient l’un des épisodes fondateurs de la Silicon Valley : des ingénieurs quittent une entreprise, emportent leur expérience, trouvent des investisseurs et créent de nouvelles sociétés.
Un nouveau problème apparaît cependant. Plus on ajoute de transistors, plus il faut les relier par des fils, des pistes et des soudures. La réponse est le circuit intégré. Jack Kilby démontre en 1958 qu’il est possible de réaliser plusieurs composants dans un même matériau ; chez Fairchild, Jean Hoerni développe ensuite le procédé planaire et Robert Noyce montre comment intégrer les connexions métalliques à la surface de la puce. On ne cherche plus seulement à fabriquer des transistors plus petits : on peut désormais fabriquer un circuit entier comme un seul objet.
Le logiciel : apprendre à donner des instructions aux machines
Des circuits plus petits et plus rapides ne suffisent pas : encore faut-il pouvoir les programmer. Les premiers programmes s’écrivent très près du fonctionnement matériel, sous forme de codes numériques ou d’instructions élémentaires. Pour résoudre un problème scientifique ou gérer des milliers de dossiers, cette préparation peut devenir longue et délicate.
Les langages de programmation permettent de prendre du recul par rapport à ces détails. En 1957, l’équipe de John Backus chez IBM livre le premier compilateur FORTRAN : les scientifiques peuvent exprimer leurs calculs dans une notation plus proche des formules mathématiques, qu’un logiciel traduit en instructions exécutables. Cette étape montre qu’un ordinateur peut aussi prendre en charge une partie du travail nécessaire à sa propre programmation. IBM retrace cette naissance de FORTRAN.
Les systèmes d’exploitation jouent un rôle complémentaire : ils organisent l’exécution des programmes et l’accès à la mémoire, aux fichiers et aux périphériques. Au lieu de tout reconstruire pour chaque application, les programmeurs disposent de services communs. L’informatique progresse ainsi sur deux fronts : la fabrication des machines et la conception des logiciels qui permettent de les utiliser.
Le microprocesseur et l’ordinateur personnel
À mesure que l’intégration progresse, les puces réalisent des fonctions toujours plus complexes. En 1971, Intel commercialise l’Intel 4004. Il ne contient qu’environ 2 300 transistors et travaille sur quatre bits, mais son importance est ailleurs : les principales fonctions d’une unité centrale programmable tiennent désormais sur une seule puce. Le microprocesseur transforme le processeur en composant produit en série.
Cette miniaturisation rapproche progressivement l’ordinateur de son utilisateur. Au Dartmouth College, le temps partagé et le langage BASIC avaient déjà permis, dès 1964, à des étudiants non spécialistes de travailler directement avec une grande machine. Dans les années 1970, le microprocesseur permet d’aller plus loin : l’ordinateur lui-même peut tenir sur un bureau. Les premiers kits intéressent surtout les passionnés d’électronique, puis 1977 marque une accélération avec l’Apple II, le TRS-80 et le Commodore PET. Ces machines arrivent prêtes à fonctionner et commencent à transformer l’ordinateur en produit que l’on peut acheter pour soi, et non plus en équipement appartenant nécessairement à une université, une administration ou une grande entreprise.
En 1981, IBM présente le PC 5150. Il n’est pas le premier ordinateur personnel, mais la puissance commerciale d’IBM, le choix du processeur Intel 8088 et le système PC DOS fourni par Microsoft favorisent la constitution d’un immense écosystème. Des constructeurs produisent bientôt des machines compatibles et le PC devient un standard qui finit par dépasser IBM lui-même. Une machine ne s’impose donc pas seulement grâce à ses qualités techniques : les logiciels disponibles, les périphériques, les standards et la confiance des utilisateurs peuvent compter tout autant. Le récit d’IBM revient sur ces choix industriels.
ARPANET et Internet : les ordinateurs apprennent à communiquer
Cette arrivée de l’ordinateur sur les bureaux ne doit pas masquer une évolution parallèle, commencée bien avant le PC. Dès les années 1960, alors que les machines restent coûteuses et souvent partagées, plusieurs chercheurs expérimentent des communications à distance. Leur objectif : accéder aux ressources d’un autre centre sans devoir s’y rendre ni acheter un nouvel ordinateur. Larry Roberts utilise notamment le TX-2 pour des essais de liaison entre ordinateurs. L’ARPA américaine finance ensuite un projet beaucoup plus ambitieux : ARPANET.
Le 29 octobre 1969, depuis l’UCLA, Charley Kline tente de se connecter à un ordinateur du Stanford Research Institute. Il doit envoyer le mot LOGIN. Le L arrive, puis le O. Au troisième caractère, le système tombe en panne. Le premier message transmis entre les deux machines se résume donc à « LO ». L’anecdote prête aujourd’hui à sourire, mais elle marque une étape décisive : quelques décennies plus tard, des milliards d’appareils communiqueront en permanence.
ARPANET n’est pas simplement un réseau conçu pour résister à une attaque nucléaire, comme on le lit parfois. Son financement est militaire, mais l’un de ses objectifs essentiels est de permettre à des chercheurs éloignés de partager des ressources informatiques et de faire communiquer des machines différentes. De nouveaux usages apparaissent rapidement : accès à distance, transfert de fichiers, courrier électronique. Au cours des années 1970, les travaux qui conduisent aux protocoles TCP puis IP préparent l’interconnexion de réseaux hétérogènes. Le passage d’ARPANET à TCP/IP le 1er janvier 1983 constitue alors un jalon majeur : il devient possible de penser non plus seulement un réseau, mais un réseau de réseaux.
Le Web : rendre Internet navigable
Internet existe donc avant le Web. La distinction est essentielle : Internet est l’infrastructure qui permet aux machines d’échanger des données ; le Web est l’un des services construits au-dessus de cette infrastructure. À la fin des années 1980, Tim Berners-Lee travaille au CERN, où des milliers de chercheurs utilisent des ordinateurs, des logiciels et des formats différents. Son problème est très concret : comment retrouver et relier plus facilement l’information produite par toutes ces équipes ?
En mars 1989, il propose un système hypertexte fonctionnant sur Internet. Son responsable, Mike Sendall, note sur le document une appréciation devenue célèbre : « Vague, but exciting… », que l’on peut traduire par « vague, mais passionnant ». Berners-Lee assemble plusieurs briques : des adresses pour identifier les ressources, HTTP pour les demander, HTML pour décrire les pages et des liens hypertextes pour passer de l’une à l’autre. Le premier site Web est extrêmement simple selon nos critères actuels, essentiellement composé de texte et de liens, mais les principes essentiels sont déjà là.
Le choix de l’ouverture va être tout aussi important que la technologie. En avril 1993, le CERN place le logiciel du Web dans le domaine public, facilitant considérablement sa diffusion. Mosaic puis Netscape rendent la navigation graphique plus accessible. En France, le basculement possède une histoire particulière : le Minitel avait déjà familiarisé des millions d’utilisateurs avec la messagerie, les annuaires, les achats ou les réservations en ligne. Le Web introduit cependant autre chose : un espace mondial où les documents peuvent être reliés entre eux et où presque n’importe quel ordinateur connecté peut devenir producteur d’information.
Google : quand le Web devient trop grand pour être parcouru
Le succès du Web crée presque immédiatement son propre problème. Quelques milliers de pages peuvent encore être classées dans des répertoires ; des millions puis des milliards de documents ne le peuvent plus. Des moteurs de recherche permettent déjà de retrouver des pages à partir de mots-clés. À Stanford, Larry Page et Sergey Brin explorent dans les années 1990 une piste pour mieux classer les résultats : examiner aussi les liens qui relient les pages entre elles.
L’idée rappelle le monde scientifique : une publication souvent citée par d’autres travaux importants acquiert une certaine autorité. Sur le Web, les liens peuvent fournir un indice comparable. Des programmes parcourent les pages, suivent les liens et construisent un immense index ; PageRank participe ensuite à l’évaluation de leur importance. Google est fondée en 1998 et devient progressivement une porte d’entrée vers un Web désormais trop vaste pour être exploré directement.
Cette étape annonce une nouvelle transformation. Le réseau ne transporte plus seulement des documents : il accumule aussi des recherches, des clics, des photographies, des vidéos et quantité d’autres traces numériques. La capacité à stocker et à traiter ces informations devient à son tour un problème informatique majeur. Une grande partie de l’histoire qui suit sera liée à ce changement d’échelle.
Smartphone et cloud : l’informatique devient omniprésente
Le smartphone n’est pas inventé en 2007, mais l’iPhone accélère une transformation déjà engagée. Le téléphone devient un ordinateur généraliste connecté, doté d’un écran tactile, de capteurs et d’un système logiciel capable d’accueillir de nouvelles applications. Une partie du matériel disparaît au profit du logiciel : le clavier physique, par exemple, est remplacé par un clavier qui apparaît à l’écran lorsque l’on en a besoin. Avec l’ouverture de l’App Store en 2008, Apple facilite la distribution d’applications pour l’iPhone. Le téléphone devient ainsi un point d’accès quotidien à de nombreux services : consulter un itinéraire, prendre une photographie, lire ses messages ou travailler sur un document.
Cette informatique que nous emportons partout produit et consomme une quantité croissante de données. Le mot « cloud » donne parfois l’impression d’un univers immatériel alors qu’il repose sur des infrastructures très physiques : serveurs, réseaux, bâtiments, alimentation électrique et systèmes de refroidissement. L’histoire effectue même un curieux mouvement de balancier. Aux débuts de l’informatique, les utilisateurs travaillent à distance sur de gros ordinateurs partagés ; le micro-ordinateur ramène ensuite la puissance de calcul sur le bureau ; Internet et le cloud en renvoient finalement une partie vers de grands centres de données.
Amazon contribue fortement à cette évolution avec le lancement de ses services d’infrastructure cloud S3 et EC2 en 2006. Le stockage puis la puissance de calcul deviennent des ressources que l’on peut louer à la demande. Une entreprise n’est plus obligée de posséder physiquement tous les serveurs dont elle a besoin. Cette infrastructure distribuée va bientôt devenir essentielle à des traitements exigeant des quantités considérables de calcul et de données, notamment ceux de l’intelligence artificielle. AWS présente les origines de cette offre.
De l’ordinateur à l’intelligence artificielle
L’intelligence artificielle n’apparaît pas avec ChatGPT. Dès les années 1940 et 1950, des chercheurs se demandent comment une machine pourrait résoudre des problèmes, manipuler des symboles ou apprendre à partir d’exemples. Alan Turing pose explicitement la question de l’intelligence des machines en 1950. En 1956, le Dartmouth Summer Research Project on Artificial Intelligence contribue à faire de « l’intelligence artificielle » un domaine de recherche identifié.
Plusieurs traditions vont ensuite coexister. Certaines cherchent à représenter explicitement des connaissances et des règles ; d’autres explorent des réseaux de neurones capables d’ajuster leurs paramètres à partir d’exemples. Elles connaissent des succès, des limites et des périodes de désillusion. L’essor de l’apprentissage profond au XXIe siècle repose sur la rencontre de plusieurs évolutions accumulées pendant des décennies. Les méthodes d’apprentissage et les architectures des réseaux progressent, tandis que les moyens nécessaires pour les entraîner deviennent plus accessibles. Internet et les smartphones fournissent d’immenses quantités de données, les centres de données permettent de les stocker et les GPU apportent une puissance de calcul parallèle particulièrement adaptée à certaines opérations utilisées par les réseaux neuronaux.
En 2012, AlexNet illustre de manière spectaculaire la puissance de cette combinaison pour la reconnaissance d’images. En 2017, des chercheurs présentent l’architecture Transformer, initialement appliquée notamment à la traduction automatique et appelée à jouer un rôle déterminant dans les futurs modèles de langage. Lorsque ChatGPT est rendu public à la fin de 2022, des millions de personnes découvrent une interface où l’on peut s’adresser à l’ordinateur avec un langage ordinaire. L’impression de rupture est réelle, mais elle s’appuie sur des décennies de recherches et sur une infrastructure considérable. L’interface paraît simple ; les logiciels, les circuits et les réseaux qui la rendent possible le sont beaucoup moins.
Une histoire faite de machines, mais surtout d’humains
Racontée à travers ses grandes réussites, l’histoire de l’informatique pourrait donner l’impression d’une progression inévitable. Elle ne l’a jamais été. Des technologies ont disparu, des projets prometteurs ont échoué et des entreprises dominantes ont perdu leur position. Derrière les machines célèbres travaillent des équipes de chercheurs, d’ingénieurs, de programmeuses et de programmeurs dont les contributions ne sont pas toujours aussi connues que les noms des fondateurs.
Les usages comptent eux aussi. Une machine conçue pour calculer peut devenir un instrument de création ; un réseau destiné à partager des ressources peut transformer la manière de communiquer. Comprendre cette histoire permet de regarder les technologies actuelles avec davantage de recul : elles résultent de choix techniques, économiques et collectifs, et leur avenir reste à construire.