Histoire des compilateurs et des interpréteurs
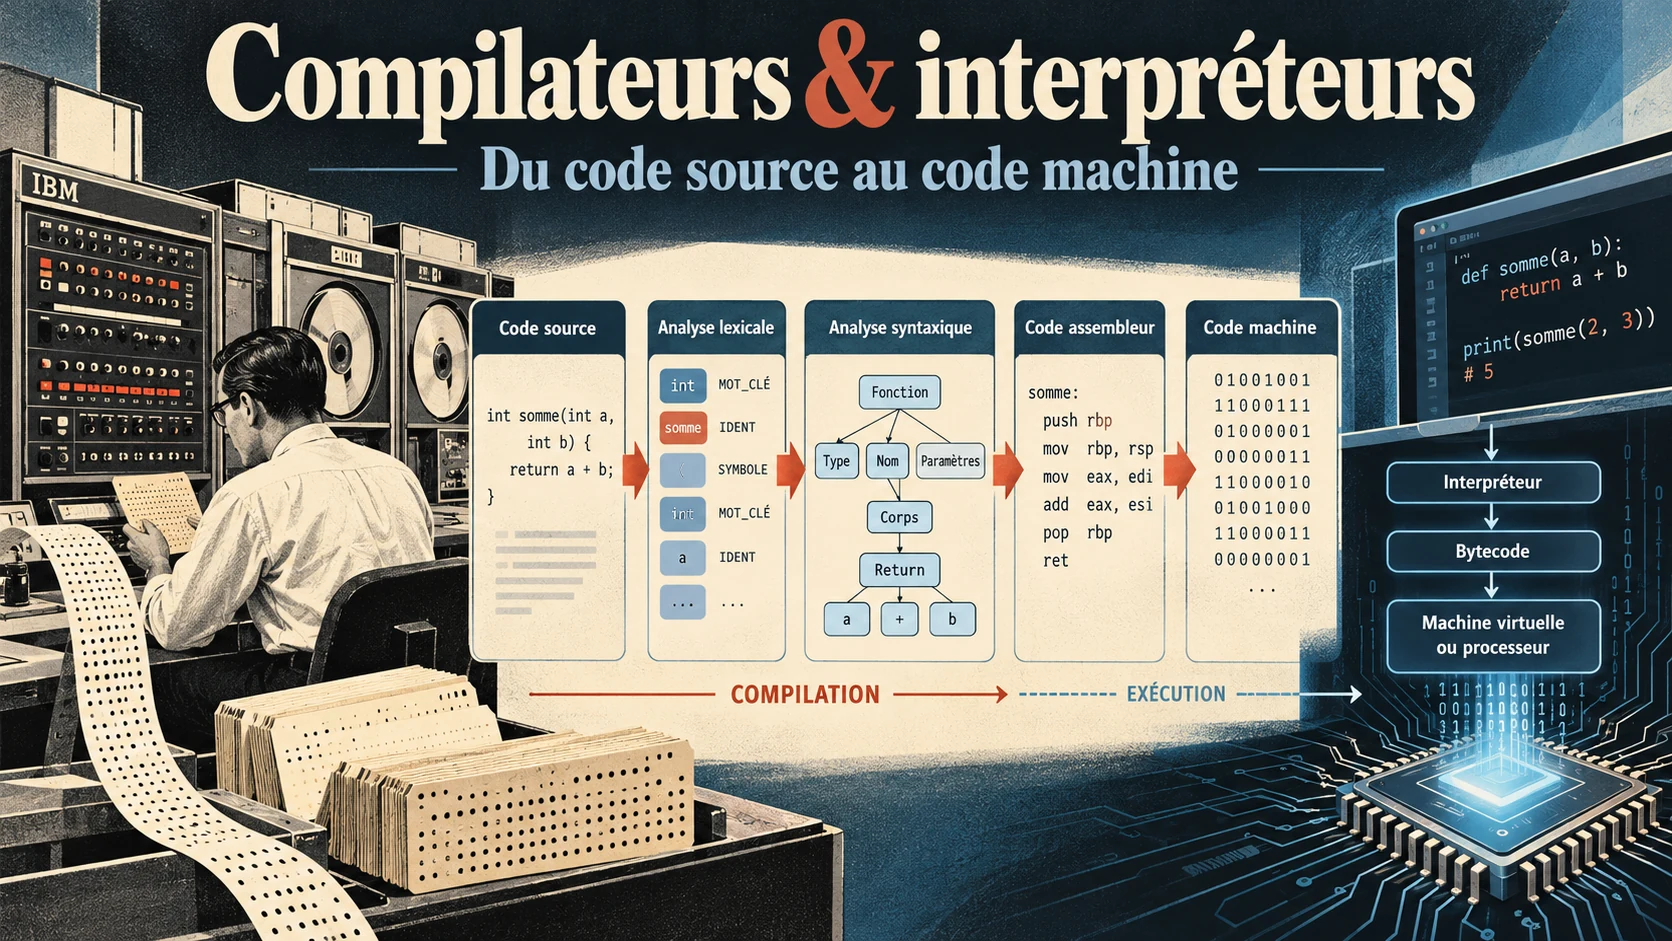
Écrire a + b paraît aujourd’hui banal. Pourtant, aucun processeur ne comprend directement les instructions du C, de Python ou de JavaScript : il exécute des codes numériques définis par son architecture. Comment passer des mots du programmeur à ces instructions ? Cette question a occupé les pionniers de l’informatique et donné naissance aux assembleurs, compilateurs et interpréteurs. Leur histoire est celle d’un compromis : faciliter la programmation sans rendre les calculs trop lents.
Des codes machine aux premiers assembleurs
Dans les années 1940, les premiers ordinateurs électroniques ne se programment pas tous de la même manière. L’ENIAC, présenté en 1946, exige initialement de configurer câbles et commutateurs. Avec les ordinateurs à programme enregistré, les instructions sont conservées en mémoire sous forme numérique, comme les données.
Chaque processeur possède un jeu d’instructions : charger une valeur, l’additionner à une autre, comparer des nombres ou effectuer un saut. Chaque opération reçoit un codage binaire, une suite de 0 et de 1. Programmer une addition impose alors de connaître les instructions disponibles, l’emplacement des données et les registres de la machine.
Une erreur de codage ou d’adresse peut empêcher tout le programme de fonctionner. Et lorsqu’un calcul est répété dans plusieurs applications, réécrire sa suite d’instructions est une source de travail et d’erreurs. Les notations symboliques rendent bientôt ce travail moins pénible. Plutôt qu’un code numérique, le programmeur écrit, selon la machine, un symbole comme ADD. Un assembleur le traduit en instruction machine. Dès 1949, sur l’EDSAC de Cambridge, les Initial Orders permettent de charger des programmes exprimés dans une notation symbolique ; David Wheeler contribue à leur perfectionnement. Mais la difficulté demeure : écrire en assembleur exige toujours de détailler les opérations propres au processeur. Les scientifiques veulent décrire des calculs, non organiser manuellement chaque déplacement de données. L’assembleur supprime le besoin de mémoriser tous les codes numériques, mais il ne choisit pas, à la place du programmeur, la méthode de calcul.
1950-1957 : rendre la programmation plus simple sans perdre en vitesse
Les premières réponses empruntent des voies différentes. À la fin des années 1940, Short Code, associé aux travaux de John Mauchly et de ses collaborateurs, permet de représenter des calculs dans une notation plus commode. Un programme reconnaît ces expressions et effectue les opérations correspondantes : c’est l’une des premières expériences d’interprétation. Le confort gagné se paie cependant par du travail supplémentaire pendant l’exécution.
En 1952, Grace Hopper développe A-0 pour l’UNIVAC. Ce système automatise la sélection et la réunion de sous-programmes déjà écrits. Elle contribue ainsi à introduire le terme « compilateur » en informatique, emprunté à l’anglais to compile, qui signifie notamment « rassembler ». A-0 ressemble toutefois davantage à un chargeur et à un éditeur de liens modernes qu’à un compilateur traduisant un langage de haut niveau. La même année, Alick Glennie développe à Manchester un premier Autocode, capable de traduire des instructions symboliques de plus haut niveau.
Speedcoding : le coût caché de la facilité
En 1953, chez IBM, John Backus développe avec son équipe Speedcoding pour l’IBM 701. Ce système interprétatif simplifie notamment les calculs en virgule flottante, qui exigent autrement de nombreuses instructions. Mais chaque opération passe par des routines logicielles : selon les calculs, l’exécution peut être dix à vingt fois plus lente que du code machine équivalent.
Pourquoi l’utiliser malgré tout ? Parce que le temps passé à écrire, vérifier et corriger un programme coûte également cher. Speedcoding peut raccourcir ce travail, mais ses performances deviennent pénalisantes pour les calculs répétés. Backus cherche donc à conserver la simplicité d’écriture tout en supprimant le surcoût d’une interprétation permanente.
FORTRAN : traduire avant d’exécuter
En 1957, le premier FORTRAN fonctionne sur l’IBM 704. Son compilateur transforme les expressions du programme en instructions machine avant l’exécution. La traduction demande du temps, mais le programme produit peut ensuite fonctionner sans interpréter chaque opération. L’équipe de Backus travaille particulièrement à l’optimisation : un code trop lent n’aurait pas convaincu les scientifiques habitués à programmer en assembleur.
Construire ce compilateur est pourtant beaucoup plus difficile que réaliser une traduction mot à mot : il faut trouver une suite d’instructions efficace pour chaque calcul, alors que les ordinateurs ne disposent que de peu de mémoire. C’est pourquoi l’optimisation devient une partie essentielle du projet.
FORTRAN montre qu’un langage de haut niveau peut être pratique et performant. Reste à comprendre comment le compilateur transforme réellement un texte en instructions binaires.
Comment un compilateur transforme-t-il des mots en code machine ?
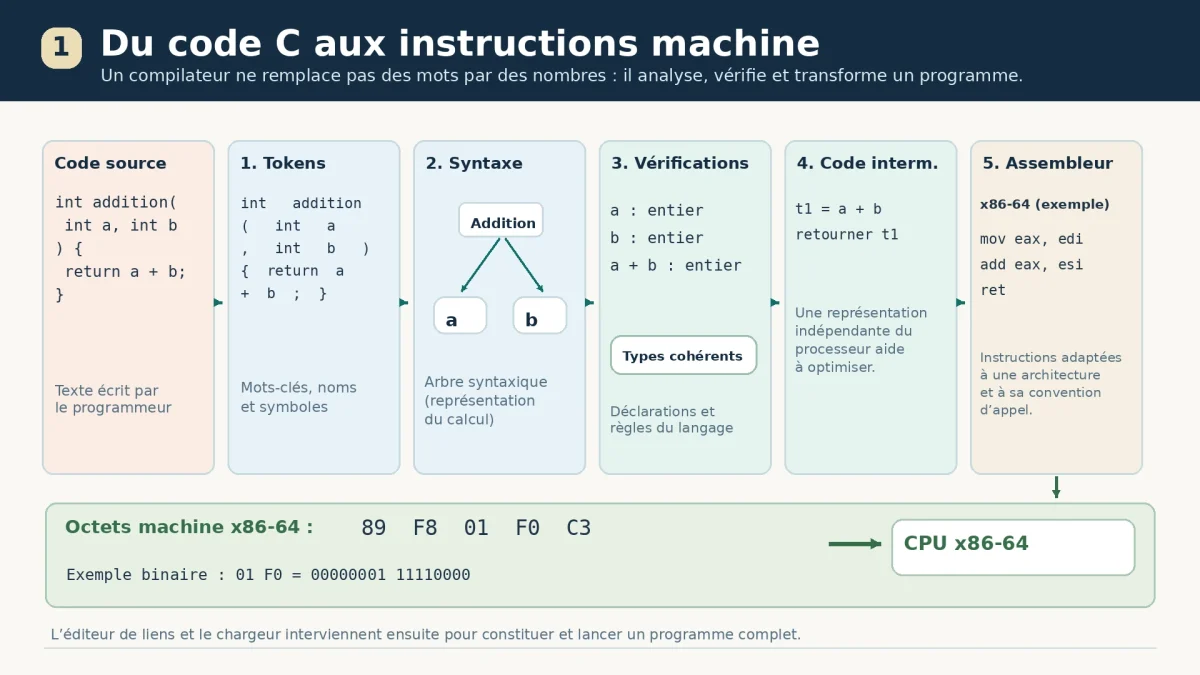
Un compilateur ne remplace pas simplement chaque mot par une suite de bits. Il reconnaît, organise, vérifie puis traduit les instructions, en plusieurs étapes. Prenons cette fonction C :
int addition(int a, int b) {
    return a + b;
}
Reconnaître les tokens et la structure du programme
L’analyse lexicale regroupe les caractères en unités appelées tokens : le mot-clé int, l’identifiant addition, les parenthèses, les virgules ou le signe +. Le début de la fonction devient par exemple :
int | addition | ( | int | a | , | int | b | )L’analyse syntaxique vérifie ensuite que ces tokens suivent la grammaire du C. Elle construit généralement un arbre syntaxique abstrait (AST), où l’expression a + b devient une opération d’addition reliée à ses deux opérandes : + au sommet, a et b en dessous. Le programme n’est donc plus seulement une suite de caractères : le compilateur dispose d’une représentation de ses relations logiques. Cette organisation permet aussi de respecter les priorités : dans a + b * c, la multiplication est regroupée avant l’addition.
Décrire précisément cette grammaire est une science en soi. En 1960, le rapport d’ALGOL 60 utilise notamment la notation BNF, issue des travaux de John Backus et Peter Naur, pour formaliser les constructions autorisées.
Vérifier et préparer les opérations
Une instruction comme return a + ; serait rejetée par l’analyse syntaxique : il manque un élément après +. Une instruction bien écrite peut cependant employer une variable inexistante. Lors de l’analyse sémantique, le compilateur contrôle notamment les déclarations et les types. Ici, a et b sont des entiers et le résultat de leur addition convient au type de retour annoncé. Un programme peut pourtant être grammaticalement correct et donner un résultat faux : le compilateur ne devine pas l’intention de son auteur.
Beaucoup de compilateurs utilisent ensuite une représentation intermédiaire (IR), qui décrit les calculs sans dépendre encore d’un processeur précis. Elle facilite les optimisations : par exemple, remplacer 2 + 3 par 5, lorsque les règles du langage le permettent. Vient enfin la génération de code pour l’architecture choisie. Selon le compilateur, certaines étapes sont regroupées ou réalisées dans un autre ordre ; le principe reste d’aller d’une description du calcul à une représentation exécutable.
De l’assembleur aux 0 et aux 1
Sur x86-64, avec la convention d’appel habituelle de Linux, notre fonction peut être traduite ainsi :
addition:
    mov eax, edi
    add eax, esi
    ret
Les arguments sont ici placés dans les registres EDI et ESI. La première instruction copie le premier dans EAX ; la suivante ajoute le second ; ret termine la fonction. Un assembleur encode ces trois instructions en octets :
89 F8 01 F0 C3Ces nombres sont écrits en hexadécimal, plus lisible que le binaire. Les octets 01 F0, qui encodent ici l’addition, correspondent à 00000001 11110000. Les circuits du processeur décodent ces bits selon les règles de son jeu d’instructions. D’autres compilateurs peuvent produire une séquence différente pour le même calcul.
Dans une application complète, le code machine rejoint généralement un fichier objet. L’éditeur de liens l’associe aux autres composants nécessaires pour créer l’exécutable, que le système d’exploitation pourra charger en mémoire. Les cinq octets présentés ci-dessus codent seulement notre petite fonction, pas un programme complet.
Que fait exactement un interpréteur ?
Un interpréteur est un logiciel qui exécute les opérations décrites dans un programme sans devoir nécessairement produire, au préalable, un exécutable machine autonome. Pour le voir fonctionner, prenons le Locomotive BASIC de l’Amstrad CPC, intégré en ROM dans les années 1980 :
10 A = 6
20 PRINT A * A
30 END
Après RUN, le programme affiche 36. Le BASIC du CPC conserve notamment les mots-clés sous forme de tokens pour les reconnaître plus facilement. Son interpréteur, lui-même écrit en instructions machine du processeur Z80, parcourt cette représentation, retrouve les variables, effectue la multiplication et déclenche l’affichage.
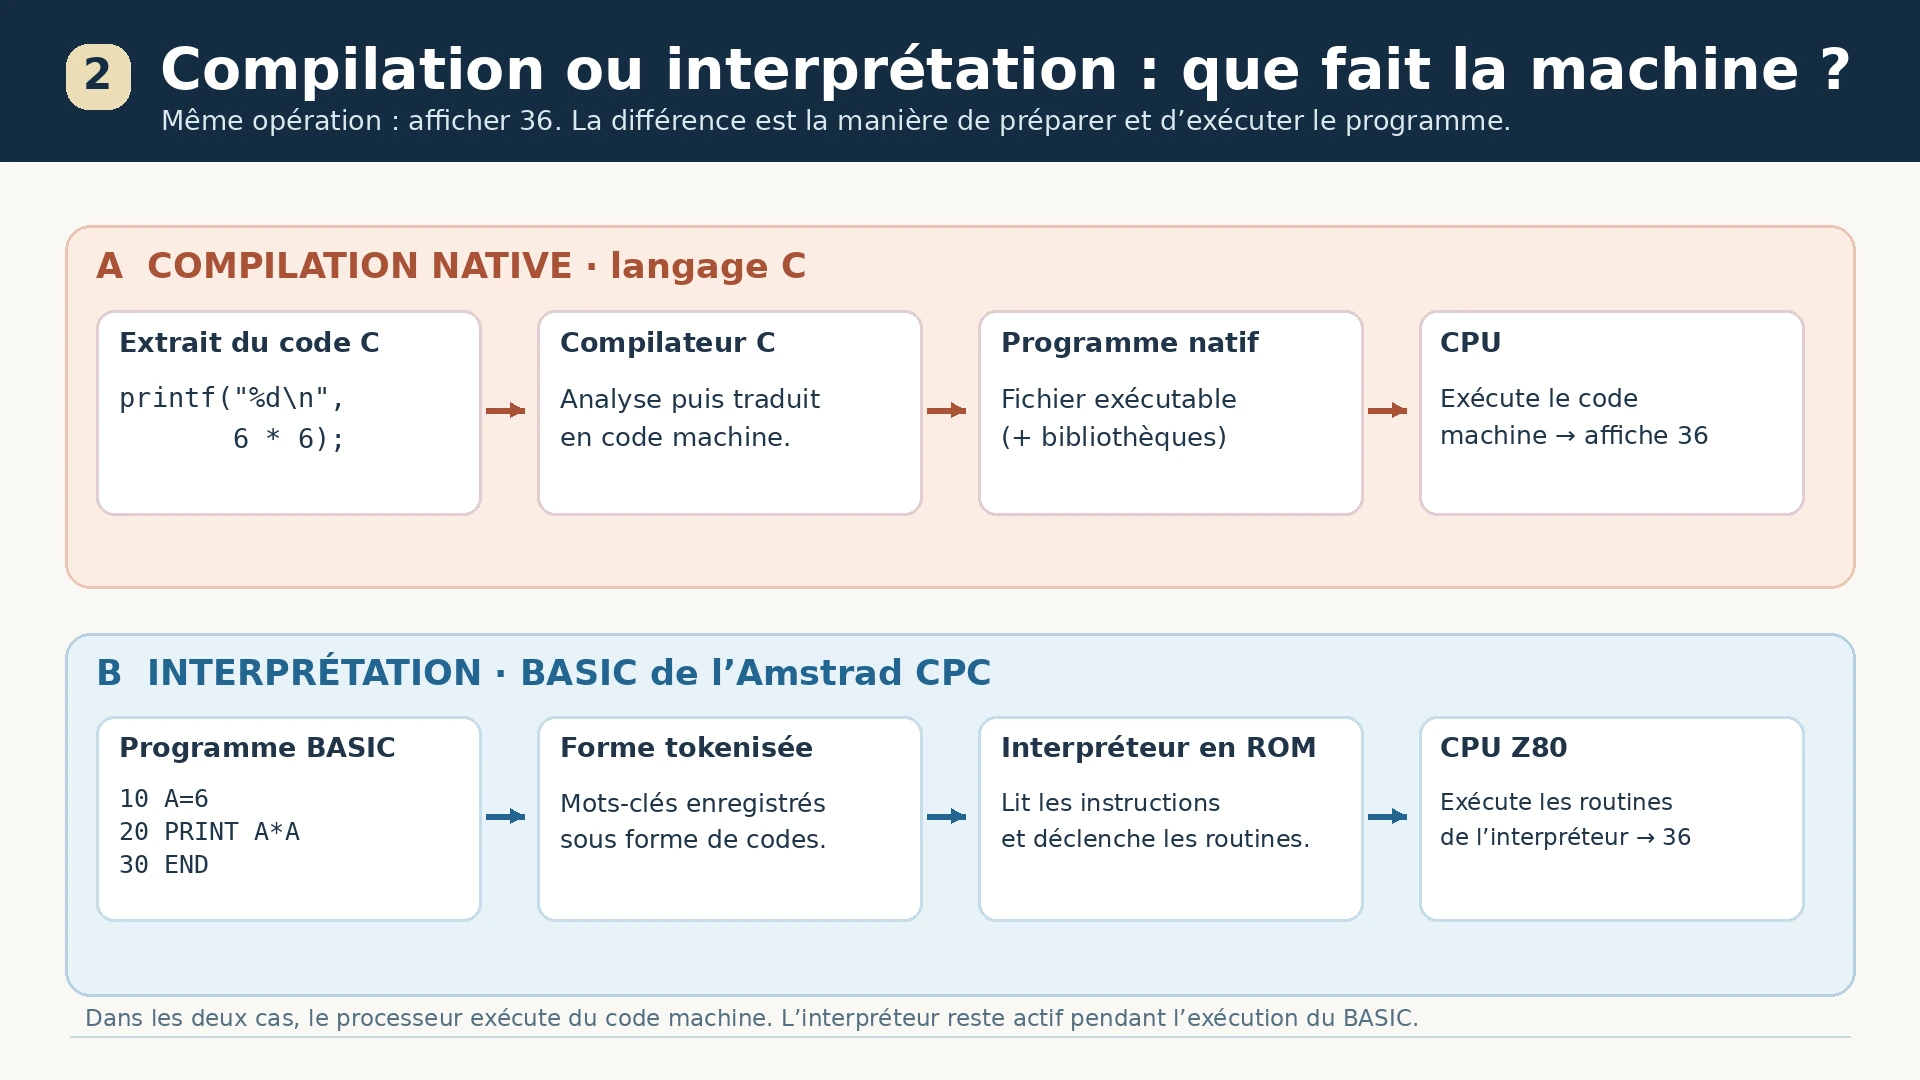
Chaque fois que le BASIC rencontre une instruction à exécuter, l’interpréteur doit identifier l’opération et appliquer les règles du langage. Dans une boucle qui se répète cent mille fois, ce travail peut lui-même être répété cent mille fois. Un programme compilé en code natif évite généralement cette couche d’interprétation pour les opérations déjà traduites.
Le Z80 n’exécute donc pas directement le BASIC : il exécute le code machine de l’interpréteur, qui réalise les opérations du programme. On peut saisir et modifier du BASIC immédiatement, sans lancer un compilateur séparé. En revanche, une boucle effectuant des milliers de calculs peut être nettement plus lente qu’une version compilée en code natif.
Pourquoi les interpréteurs ont-ils gardé leur intérêt ?
Ils ne sont pas simplement apparus lorsque les machines sont devenues puissantes. Dès la fin des années 1950, LISP profite de l’évaluation interactive d’expressions, utile aux recherches sur le calcul symbolique ; il dispose aussi de compilateurs. Le BASIC de Dartmouth, créé en 1964, est quant à lui compilé : son utilisation interactive repose sur le temps partagé, et non sur une interprétation obligatoire.
Dans les années 1970, des micro-ordinateurs comme l’Altair accueillent des interpréteurs BASIC ; beaucoup de machines des années 1980 les intègrent directement. Leur principal avantage est pratique : l’utilisateur teste rapidement quelques lignes, alors qu’une compilation séparée ajouterait des manipulations. L’amélioration des processeurs rend progressivement leur surcoût plus acceptable, mais la lenteur reste sensible dans les jeux ou les calculs intensifs.
Chez Bell Labs, Ken Thompson rencontre une difficulté comparable avec son langage B, utilisé pour développer les premiers outils d’UNIX. Le compilateur B ne produit pas directement des instructions exécutables par le processeur : il génère un code intermédiaire qu’un interpréteur doit prendre en charge. Cette étape supplémentaire ralentit considérablement les programmes, au point de rendre difficile son utilisation pour réécrire UNIX.
En 1971, Dennis Ritchie modifie le compilateur pour qu’il produise directement les instructions machine du PDP-11, sans passer par un interpréteur. Parallèlement, il fait évoluer B vers ce qui deviendra le langage C. Les programmes peuvent désormais fonctionner beaucoup plus rapidement, avec des performances davantage comparables à celles de l’assembleur.
Pourquoi changer de processeur oblige-t-il souvent à recompiler ?
Le code machine n’est pas universel. Un processeur x86-64 et un processeur ARM64 n’utilisent pas les mêmes instructions ni les mêmes codages binaires. Notre addition, exprimée sur x86-64 par add eax, esi, pourrait utiliser add w0, w0, w1 sur ARM64. Les deux réalisent une addition, mais leurs octets machine sont différents.
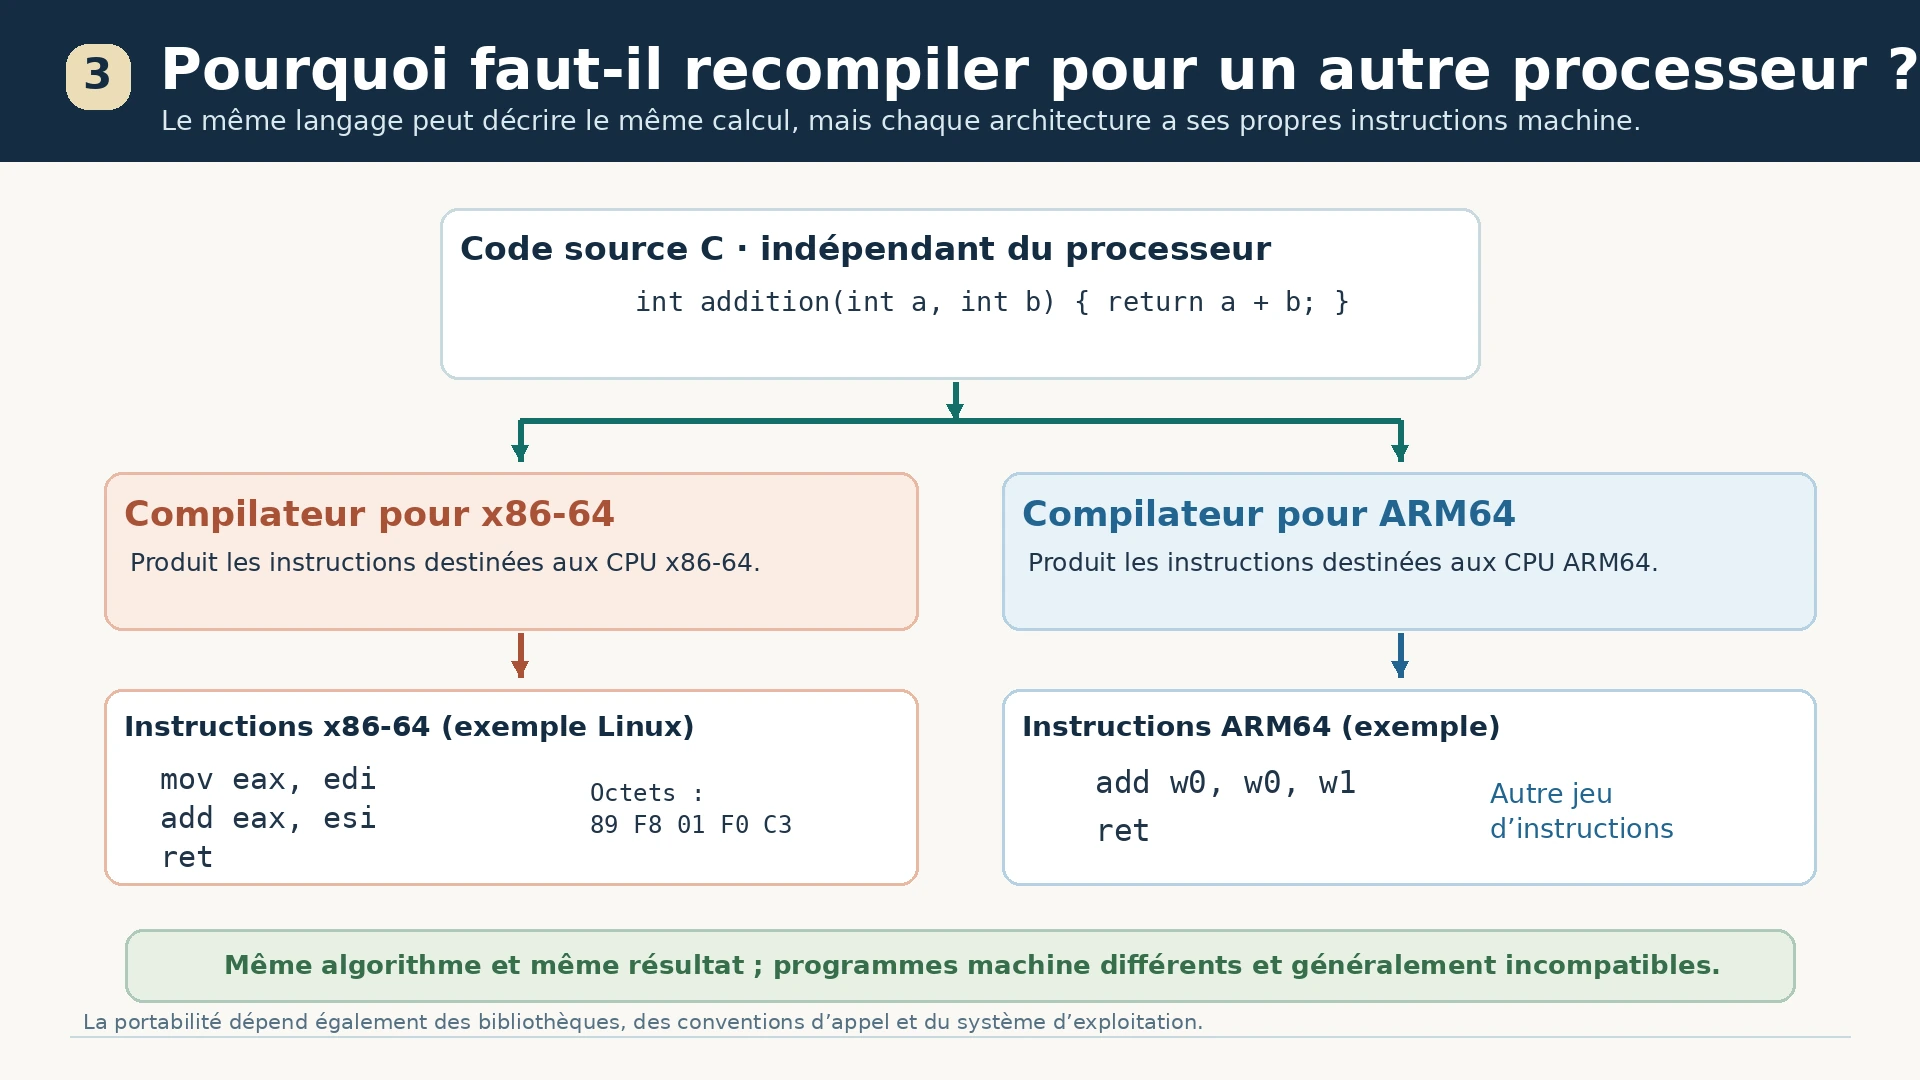
Dans les années 1950, changer d’ordinateur signifiait souvent réécrire les programmes en langage machine ou en assembleur. Les langages de haut niveau réduisent cet obstacle : on conserve le code source et on le compile pour la nouvelle architecture, à condition de disposer d’un compilateur approprié. Il peut néanmoins rester des adaptations liées au système d’exploitation et aux bibliothèques : recompiler ne suffit pas toujours à rendre un logiciel portable.
Pour faciliter ce travail, les compilateurs modernes séparent souvent un front-end, qui analyse le langage, d’un back-end, qui produit les instructions du processeur. Une représentation intermédiaire relie les deux. Des infrastructures comme GCC et LLVM peuvent ainsi prendre en charge plusieurs architectures sans tout réécrire. Mais on peut aussi viser un jeu d’instructions virtuel, plutôt qu’un processeur physique.
Bytecode et JIT : les approches se combinent
Dès les années 1970, certains systèmes Pascal traduisent les programmes en p-code, un code intermédiaire exécutable par une machine virtuelle compatible. L’idée réapparaît à grande échelle avec Java en 1995 : son compilateur produit du bytecode pour la JVM, dont les implémentations peuvent interpréter ou compiler les instructions.
CPython, implémentation courante de Python, compile lui aussi le code source en bytecode avant de l’exécuter avec un interpréteur. Python n’est donc pas simplement « lu ligne par ligne ». D’autres implémentations, comme PyPy, utilisent un compilateur JIT (Just-In-Time) pour accélérer certaines opérations.
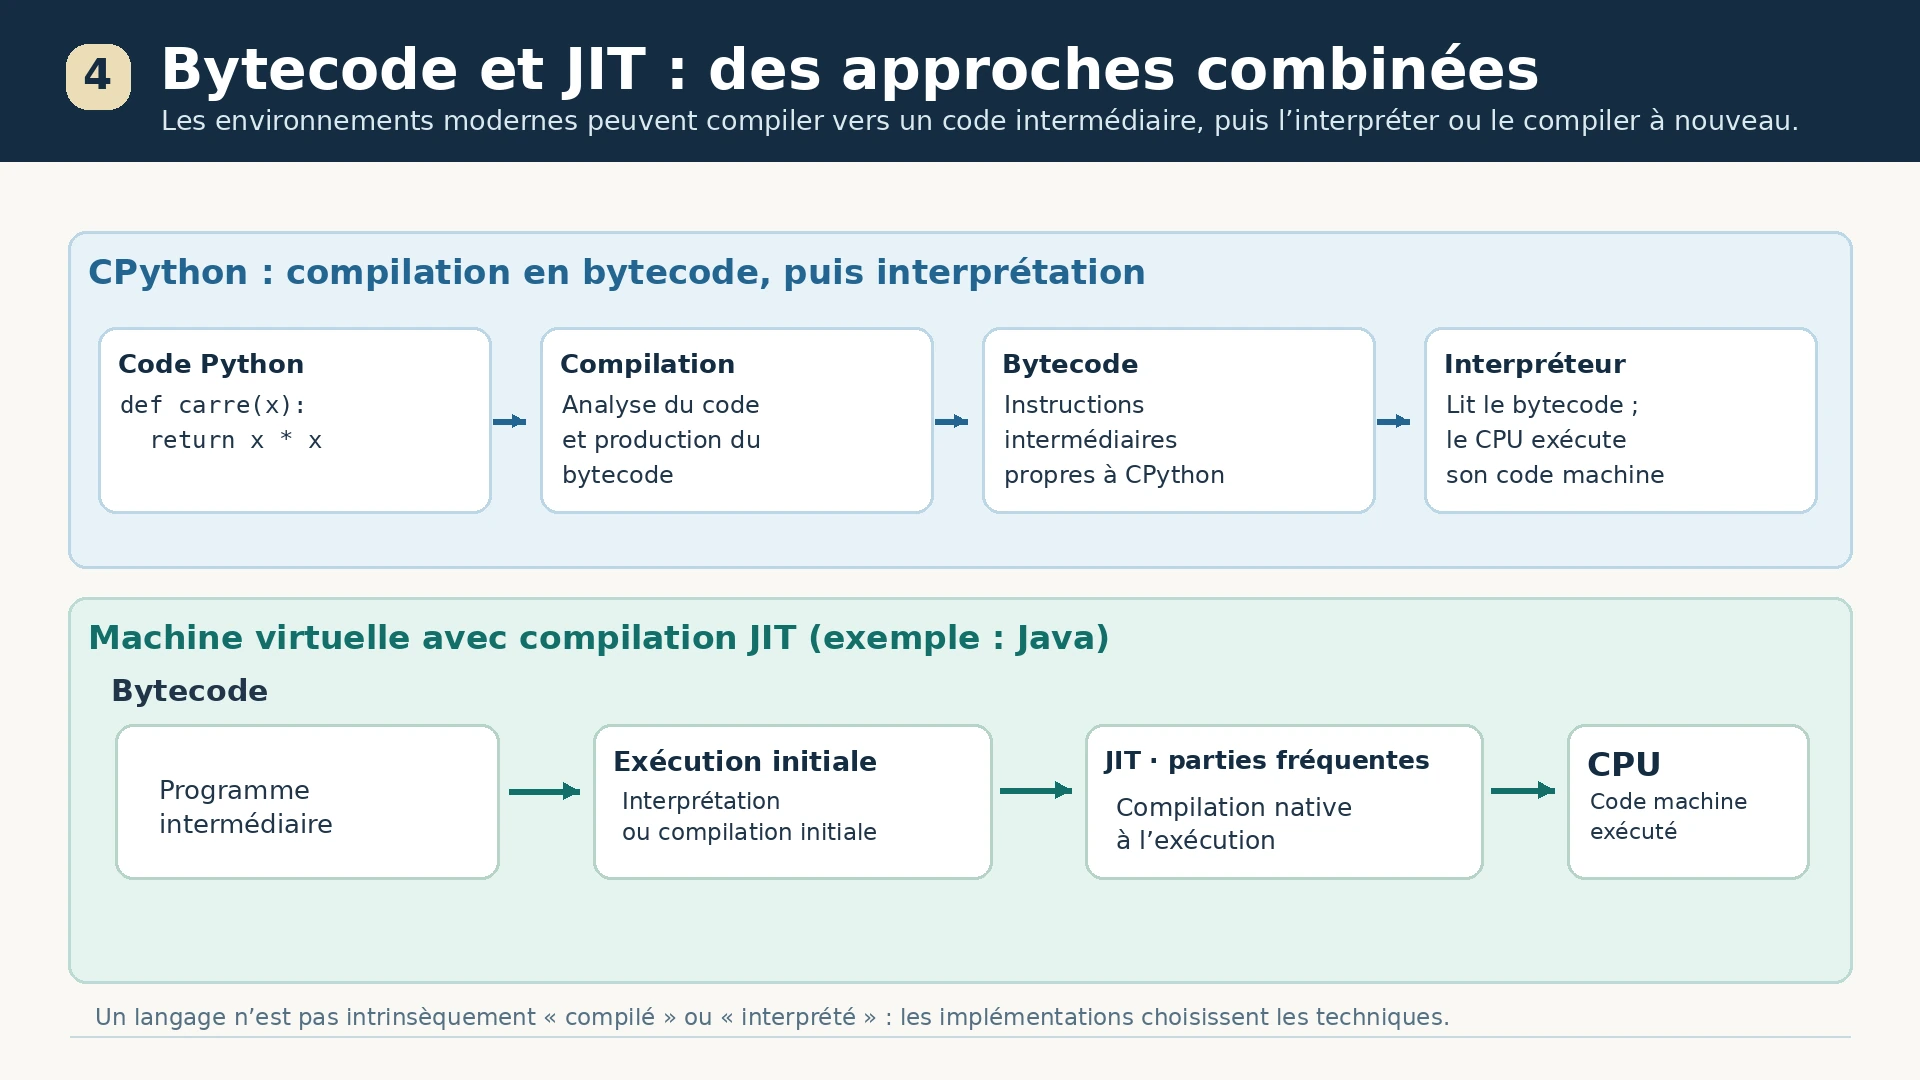
Le principe du JIT est de compiler pendant l’exécution, souvent en privilégiant les portions de code utilisées fréquemment. La traduction consomme elle-même du temps et de la mémoire, mais les instructions natives produites peuvent ensuite être réutilisées. Un programme peut donc démarrer avec des performances modestes, puis accélérer lorsque le moteur a identifié les traitements les plus fréquents. Les JVM modernes et les moteurs JavaScript illustrent ce compromis : en 2017, V8 associe notamment l’interpréteur Ignition au compilateur optimiseur TurboFan.
Enfin, WebAssembly, standardisé par le W3C en 2019, propose un format d’instructions portable que différents environnements peuvent exécuter, notamment en le compilant en code natif. Le problème posé dès les premières machines reste donc d’actualité : rendre les programmes indépendants du matériel tout en préservant de bonnes performances.
Ce qu’il faut retenir
Les assembleurs ont facilité l’écriture du code machine ; les interpréteurs ont permis d’utiliser rapidement des instructions plus abstraites ; les compilateurs ont rendu possible leur traduction en programmes performants. Tokens, grammaires, arbres syntaxiques et génération de code ont progressivement fait de la compilation une discipline à part entière. Aujourd’hui, ces techniques se combinent : un langage définit ce que l’on peut écrire, tandis que son implémentation détermine comment le programme sera exécuté.
Sources historiques et techniques
- Université de Cambridge — EDSAC Initial Orders.
- John Backus — The History of FORTRAN I, II, and III (1978).
- GCC — Les étapes de compilation et d’édition de liens.
- LLVM — Générer du code pour une architecture.
- Dennis Ritchie — The Development of the C Language (1993).
- CPython — Compiler Design.
- V8 — Ignition et TurboFan (2017).
- W3C — WebAssembly Core Specification (2019).