Histoire de l’informatique quantique : de Feynman aux qubits logiques
En 2001, des chercheurs réussissent à faire exécuter à un système quantique un calcul très simple : retrouver que 15 = 3 × 5. Le résultat était évidemment connu d’avance. L’intérêt de l’expérience n’était donc pas de découvrir les facteurs de 15, mais de montrer qu’un algorithme quantique pouvait réellement être mis en œuvre dans un dispositif physique. Pour réaliser cette expérience, les chercheurs utilisent une molécule contenant sept noyaux atomiques dont les propriétés magnétiques servent à représenter les qubits. Ils manipulent ces états quantiques à l’aide d’ondes radio, selon une technique appelée résonance magnétique nucléaire (RMN).
En réalité, l’histoire de l’informatique quantique est pleine de ces décalages entre l’ambition et l’expérience. Elle prend forme au début des années 1980, avec Paul Benioff, Richard Feynman et David Deutsch, puis change d’échelle intellectuelle avec l’algorithme de Peter Shor. Pour comprendre cette aventure, il faut suivre une question : comment transformer l’étrangeté du monde quantique en une machine qui calcule de façon fiable ?
1980–1985 : qui a inventé l’ordinateur quantique ?
D’abord, il faut préciser que l’ordinateur quantique n’a pas un inventeur unique. En 1980, Paul Benioff décrit un modèle physique de machine de Turing compatible avec la mécanique quantique. Il explore une question fondamentale : comment inscrire le calcul dans les lois de la matière ? Son travail ne démontre pas encore une accélération quantique.
Richard Feynman part d’un problème concret : les ordinateurs classiques ont beaucoup de mal à simuler certains phénomènes quantiques. Plus le système étudié devient complexe, plus le nombre de calculs nécessaires augmente très rapidement. En 1982, Feynman propose donc une idée simple mais radicale : pour simuler efficacement la physique quantique, il faudrait utiliser une machine elle-même fondée sur les lois quantiques. Autrement dit, plutôt que de demander à un ordinateur classique d’imiter la nature, on utiliserait directement la physique quantique pour effectuer le calcul.
Quelques années plus tard, en 1985, David Deutsch, à Oxford, formalise un modèle d’ordinateur quantique universel. L’ambition dépasse alors la simulation d’un phénomène particulier : concevoir une machine programmable pour différents calculs quantiques. L’objet reste théorique, mais les chercheurs disposent d’un cadre dans lequel inventer des algorithmes.
Cependant, il reste à montrer que ce modèle peut réellement apporter quelque chose au calcul. En 1992, David Deutsch et Richard Jozsa proposent un algorithme mettant en évidence un avantage quantique sur un problème construit pour l’expérience. Deux ans plus tard, Daniel Simon montre qu’un ordinateur quantique peut résoudre exponentiellement plus vite qu’une méthode classique connue un autre problème théorique fondé sur la recherche d’une périodicité cachée. Cette idée influencera directement Peter Shor.
Du bit au qubit : ce qui change dans le calcul
Qu’est-ce qu’un qubit ?
Pour saisir la différence, partons du modèle classique : un bit représente une information valant 0 ou 1. Physiquement, cette information peut être mémorisée grâce à un circuit électronique possédant deux états distincts.
En revanche, un qubit (bit quantique) repose sur une idée comparable, mais utilise les propriétés d’un système quantique. Il peut s’agir, par exemple, d’un ion piégé, d’un photon ou d’un minuscule circuit supraconducteur. On choisit deux états physiques de ce système pour représenter les valeurs 0 et 1.
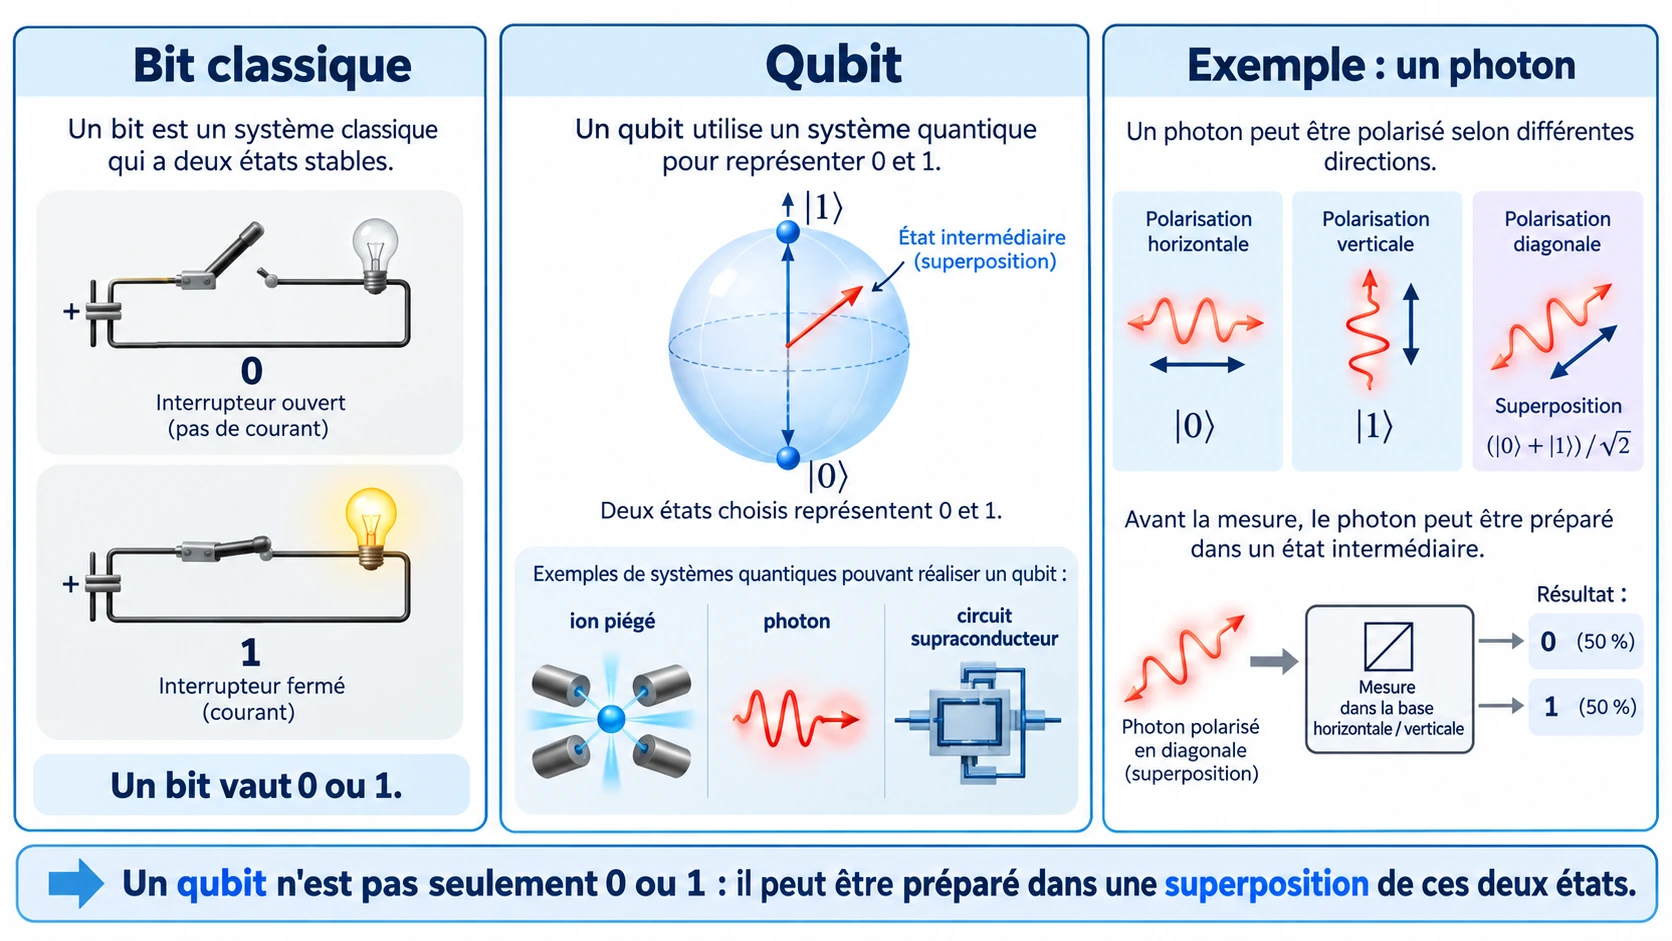
Par exemple, prenons un photon, une particule de lumière. Sa polarisation peut servir à représenter ces deux états : horizontale pour 0, verticale pour 1. On peut cependant préparer le photon avec une polarisation diagonale, correspondant à une superposition des deux états. Si on mesure sa polarisation selon les directions horizontale et verticale, on obtient soit 0, soit 1, chacun avec une probabilité de 50 %.
Pourquoi la superposition change-t-elle le calcul ?
On pourrait croire qu’un qubit en superposition est simplement un bit dont on ne connaît pas encore la valeur. Mais ce n’est pas le cas. Avant de le mesurer, on peut effectuer des opérations qui modifient les probabilités des résultats. Un peu comme deux vagues qui se rencontrent, leurs effets peuvent se renforcer ou se compenser. C’est ce qu’on appelle les interférences quantiques.
Ainsi, les algorithmes quantiques exploitent ce phénomène pour augmenter les chances d’obtenir la réponse recherchée et réduire celles d’obtenir les autres réponses.
Par ailleurs, plusieurs qubits peuvent être intriqués : leurs états sont alors liés d’une manière qui ne peut pas être décrite en attribuant indépendamment un état à chacun.
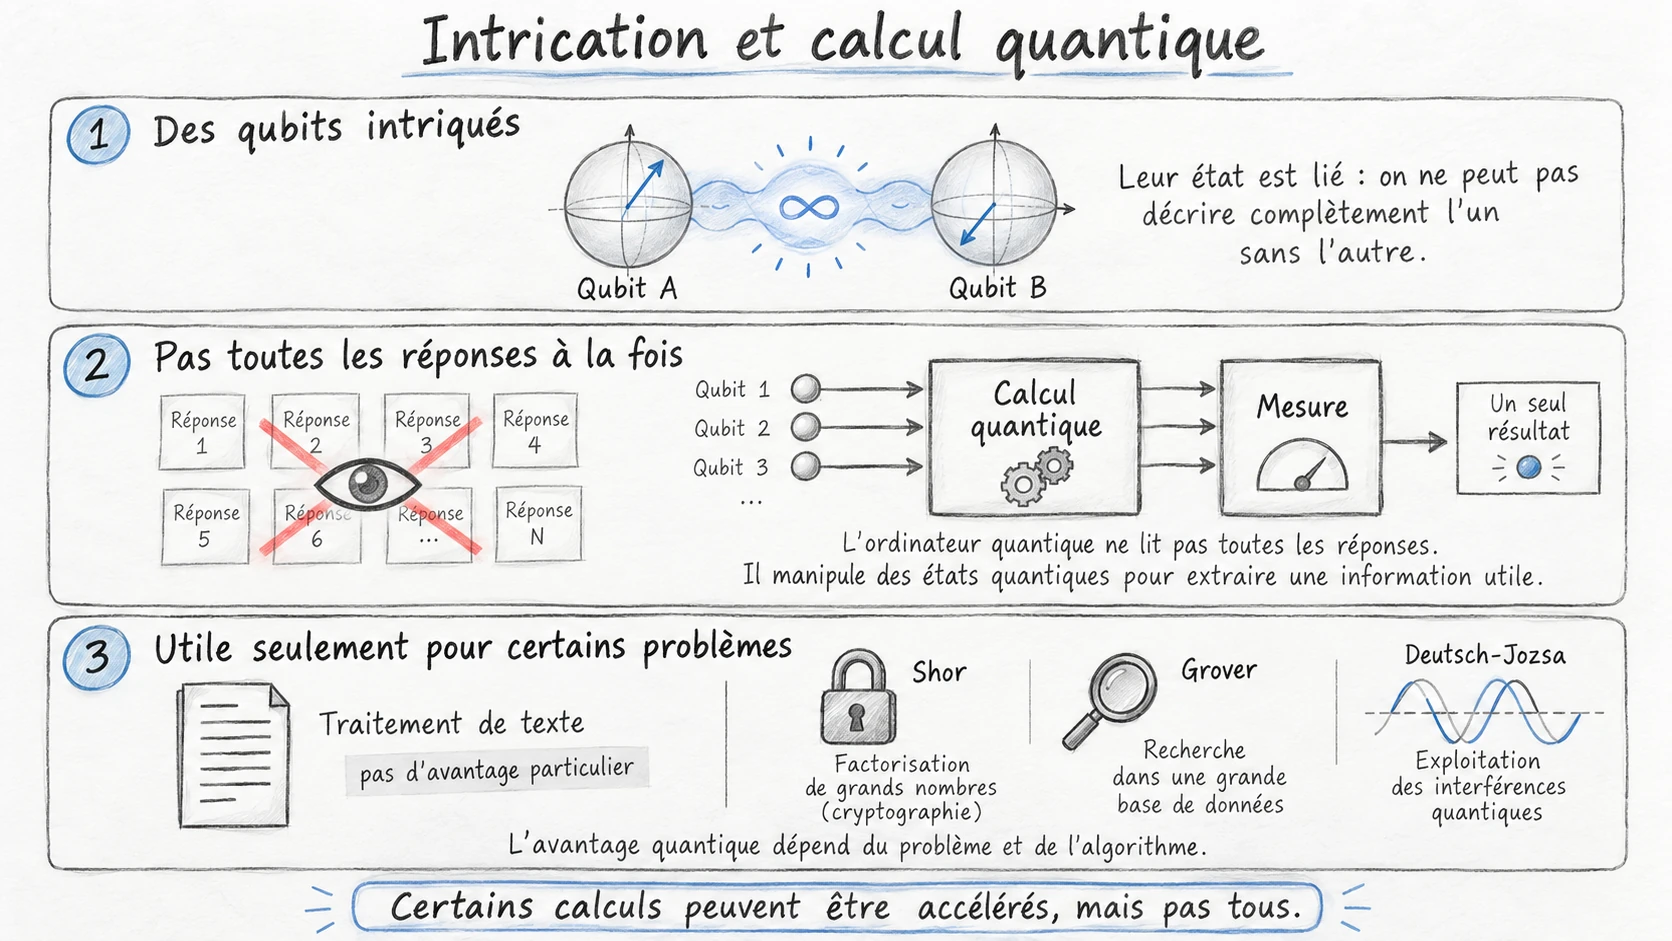
Un ordinateur quantique n’essaie donc pas simplement toutes les réponses pour les lire ensuite. Il manipule des états quantiques afin d’extraire certaines informations. Cela peut accélérer des calculs particuliers, mais pas tous : un traitement de texte, par exemple, ne fonctionnerait pas mieux simplement parce qu’il utilise des qubits.
Mais pourquoi certains calculs bénéficient-ils de cette approche ? Pour le comprendre, découvrez notre article sur les algorithmes quantiques, de Deutsch-Jozsa à Shor et Grover, qui explique comment les interférences peuvent permettre d’obtenir certains résultats avec moins d’opérations.
1994-1996 : Shor et Grover changent les perspectives
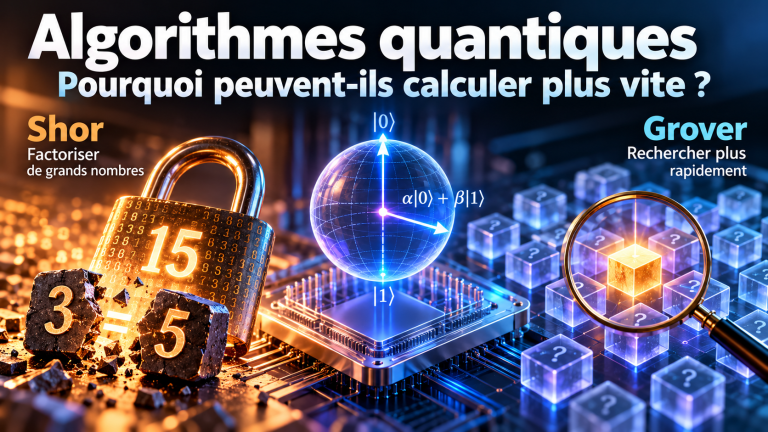
En 1994, Peter Shor provoque un tournant dans l’histoire de l’informatique quantique. Il découvre un algorithme capable de factoriser de grands nombres beaucoup plus efficacement que les meilleures méthodes classiques générales connues. Cette avancée pourrait notamment remettre en cause la sécurité du chiffrement RSA, si des ordinateurs quantiques suffisamment puissants et fiables deviennent disponibles.
Puis, deux ans plus tard, Lov Grover propose un autre algorithme, destiné à accélérer la recherche parmi un grand nombre de possibilités non organisées. Son approche permet de réduire considérablement le nombre d’interrogations nécessaires, sans rendre pour autant toute recherche instantanée.
Dès lors, ces découvertes changent le regard porté sur le calcul quantique : il ne s’agit plus seulement d’une idée théorique, mais d’une approche susceptible de résoudre certains problèmes plus efficacement.
Mais comment ces algorithmes parviennent-ils à obtenir de tels résultats ? Nous expliquons leurs mécanismes, ainsi que leurs limites, dans notre article Pourquoi un ordinateur quantique peut-il calculer plus vite ?.
1995–2015 : construire les prototypes et maîtriser les erreurs
Protéger une information quantique fragile
Toutefois, les théoriciens rencontrent vite un obstacle : l’information quantique est fragile. Les interactions avec l’environnement et les imperfections des opérations altèrent les états nécessaires au calcul. Accumuler des qubits et des opérations peut donc multiplier les occasions d’échec.
En 1995, Shor propose de protéger un qubit en répartissant son information sur neuf qubits physiques. On ne fabrique pas neuf copies indépendantes : on construit un état collectif permettant de repérer certaines erreurs sans lire directement l’information protégée. C’est une étape fondatrice de la correction d’erreurs quantiques.
Toujours en 1995, Ignacio Cirac et Peter Zoller proposent une architecture utilisant des ions piégés, manipulés par des lasers. La question du support matériel devient concrète.
Des expériences de laboratoire aux premières machines
En 1998, des expériences de résonance magnétique nucléaire exécutent de petits algorithmes quantiques. En 2001 arrive la factorisation de 15 : l’équipe de Lieven Vandersypen et Isaac Chuang exploite les spins de sept noyaux atomiques, une propriété quantique liée à leur comportement magnétique, pour en faire des qubits. Cependant, la publication souligne que cette réussite ne démontre pas le passage à grande échelle. Son apport est le contrôle d’un système quantique pendant un calcul.
Il n’existe donc pas une date incontestable du « premier ordinateur quantique ». Tout dépend de ce que l’on désigne : un modèle théorique, une porte logique, un petit algorithme ou une machine programmable.
Par la suite, plusieurs technologies concurrentes progressent : circuits supraconducteurs, ions piégés, photons ou encore atomes neutres. Chacune possède ses avantages mais aussi ses propres difficultés de fabrication, de contrôle et de correction des erreurs. En 2015, une équipe d’IBM démontre ainsi un protocole de détection d’erreurs sur quatre qubits supraconducteurs, une brique vers des machines plus fiables.
En parallèle, une autre branche se développe avec le recuit quantique, notamment commercialisé par D-Wave. Ces machines recherchent des états de basse énergie pour traiter certains problèmes d’optimisation. Leur fonctionnement diffère du modèle universel à portes logiques suivi principalement dans cet article.
2016 : une machine quantique depuis chez soi
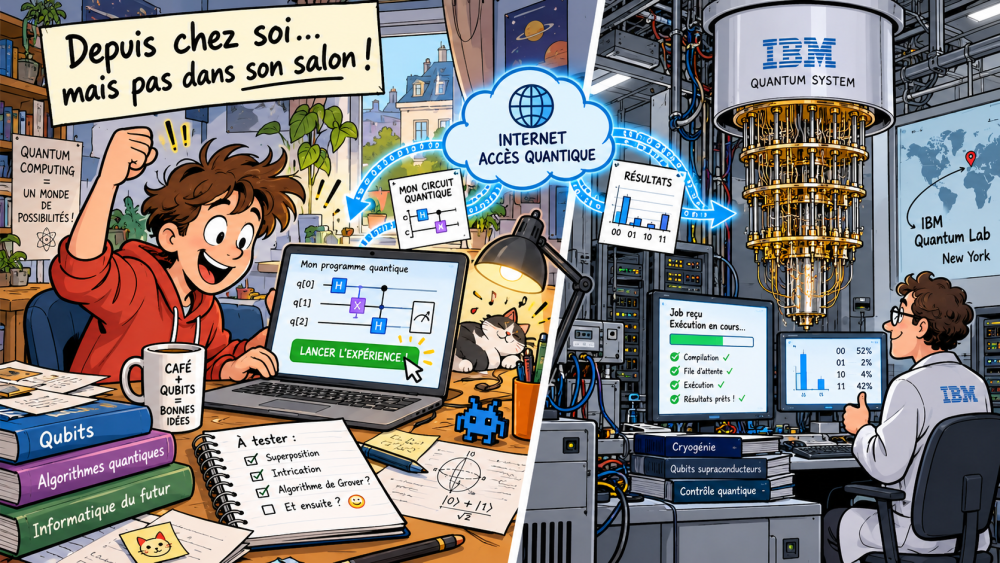
Le 4 mai 2016, IBM ouvre au public, par Internet, un processeur de cinq qubits. L’IBM Quantum Experience permet de composer des circuits et de les faire exécuter sur un dispositif réel. La machine reste au laboratoire ; les utilisateurs y accèdent par le cloud.
Ainsi, ce changement d’accès compte dans l’histoire de l’informatique. On peut apprendre, expérimenter et se confronter au bruit d’un processeur sans construire son propre équipement. Une communauté de programmeurs rejoint celle des physiciens.
Essayer soi-même un circuit quantique
Aujourd’hui, cette possibilité reste ouverte grâce à IBM Quantum Composer. Cet outil graphique permet de construire un circuit en plaçant des opérations sur des qubits, puis d’observer leur effet dans un simulateur, directement depuis son navigateur. Les circuits simples peuvent être explorés sans créer de compte.
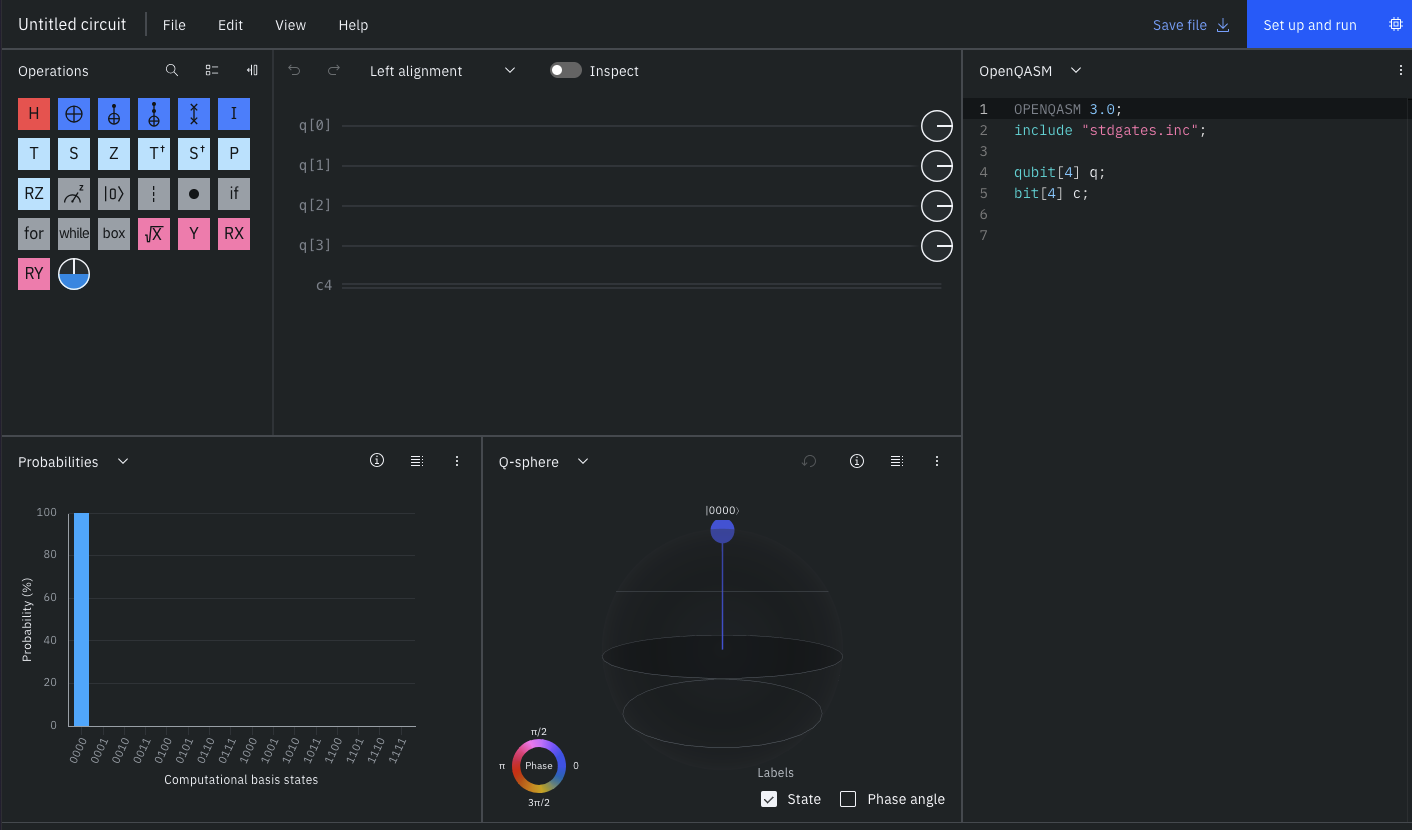
Une première expérience consiste à placer une porte Hadamard (H) sur un qubit initialement dans l’état 0 : une mesure peut donner 0 ou 1, avec une chance sur deux dans le cas idéal. Si l’on applique deux portes H successives, sans mesure entre les deux, on retrouve toujours 0 dans le simulateur idéal. C’est une façon concrète d’observer les interférences quantiques.
Avec un compte IBM Quantum et un accès aux ressources de calcul, on peut également lancer des circuits sur un véritable processeur quantique distant. Les résultats peuvent alors différer légèrement du modèle idéal à cause des imperfections matérielles. Pour débuter, IBM propose aussi un guide de prise en main.
Il faut toutefois rappeler que le qubit est une unité d’information, pas le nom d’un composant unique. Circuits supraconducteurs, ions piégés, atomes neutres ou photons représentent des choix matériels différents. Leurs contraintes de contrôle et de correction d’erreurs rendent les comparaisons plus complexes qu’un classement par nombre de qubits.
2019 : Google, Sycamore et la « suprématie quantique »
Plus tard, en octobre 2019, Google annonce un résultat spectaculaire avec Sycamore, utilisant 53 qubits. Le processeur exécute des suites d’opérations choisies aléatoirement, puis produit des séries de 0 et de 1 dont il faut reproduire la distribution statistique : c’est la tâche d’« échantillonnage ». L’expérience prend environ 200 secondes ; l’équipe estime alors qu’une tâche équivalente demanderait environ 10 000 ans à un supercalculateur classique. Cette comparaison soutient son annonce de « suprématie quantique ».
Cependant, IBM conteste aussitôt l’estimation classique et propose une méthode qui, selon ses calculs, ramènerait la durée à environ deux jours et demi. Il s’agit alors d’une estimation, pas d’une exécution démontrée dans ce délai. La controverse révèle une difficulté durable : les ordinateurs quantiques affrontent des méthodes classiques qui progressent elles aussi.
En effet, la tâche de Sycamore est surtout un test de performance soigneusement choisi. Elle ne résout pas directement un problème de chimie ou de production industrielle. Dans un entretien, John Martinis, qui dirigeait l’équipe matérielle, distingue lui-même ce jalon de l’objectif suivant : créer une valeur pratique avec les machines.
Des qubits physiques aux qubits logiques : le tournant de la fiabilité
Au-delà des records de vitesse, la correction d’erreurs donne une autre mesure du progrès. Un qubit logique est une information quantique protégée par un encodage mobilisant plusieurs qubits physiques. On mesure des indices d’erreur sans mesurer directement l’état que l’on veut conserver.
Dans un entretien publié en mars 2026, Scott Aaronson se souvient d’un contraste presque absurde à la fin des années 1990. Il évoque des exigences théoriques envisageant moins d’une erreur sur un million d’opérations à deux qubits, face à certaines opérations de laboratoire qui pouvaient encore échouer une fois sur deux. Depuis, le fossé s’est réduit des deux côtés : les opérations physiques sont devenues plus précises et les codes plus tolérants au bruit.
2023–2024 : rendre les qubits logiques plus fiables
Un premier tournant apparaît en 2023. Une équipe de Google montre qu’en augmentant la taille d’un code de surface, le taux d’erreur d’un qubit logique peut commencer à diminuer malgré l’ajout de nouveaux qubits physiques. L’amélioration reste modeste, mais elle démontre expérimentalement un principe essentiel : ajouter des qubits peut renforcer la protection au lieu d’ajouter seulement de nouvelles sources d’erreurs.
Un an plus tard, un résultat annoncé en décembre 2024 va plus loin. Sur ses processeurs Willow, Google démontre une mémoire quantique dont le taux d’erreur logique diminue lorsque la protection est renforcée avec davantage de qubits. La mémoire logique la plus performante conserve l’information plus longtemps que le meilleur qubit physique qui la compose.
C’est donc un progrès essentiel, dont la portée reste précise : une mémoire protégée ne constitue pas encore un ordinateur complet exécutant de longs algorithmes tolérants aux fautes. Il faut également effectuer des opérations entre qubits logiques, gérer les erreurs en temps réel et faire fonctionner l’ensemble à grande échelle.
2025 : commencer à calculer avec des qubits protégés
En 2025, des expériences franchissent une étape supplémentaire en réalisant certaines opérations nécessaires au calcul quantique universel directement sur des qubits logiques protégés. Une équipe utilisant des atomes neutres démontre notamment la distillation expérimentale d’« états magiques » logiques, une ressource importante pour exécuter des opérations que les codes correcteurs ne permettent pas facilement de réaliser directement.
Néanmoins, ces résultats ne constituent toujours pas un ordinateur quantique universel tolérant aux fautes, mais ils déplacent progressivement le problème : il ne s’agit plus seulement de conserver l’information quantique, mais de calculer avec elle tout en la protégeant.
Une histoire qui transforme déjà l’informatique classique
Pourtant, les effets de cette histoire dépassent déjà les laboratoires : l’héritage de Shor se lit dans les standards de sécurité. En août 2024, le NIST américain publie trois premiers standards définitifs de cryptographie post-quantique, pour l’établissement de clés et les signatures numériques. Ces méthodes s’exécutent sur des ordinateurs classiques et sont conçues pour résister aussi à de futures attaques quantiques.
Ainsi, l’enjeu n’est pas d’abandonner la cryptographie, mais de remplacer progressivement les algorithmes vulnérables à Shor par des méthodes fondées sur d’autres problèmes mathématiques. La préparation commence avant l’arrivée de la menace : renouveler les systèmes prend du temps, et des informations interceptées aujourd’hui peuvent rester sensibles pendant des décennies.
Finalement, le modeste 15 = 3 × 5 de 2001 prend tout son sens. Les chercheurs connaissaient déjà la réponse ; ils apprenaient à contrôler la matière quantique pour l’obtenir. Passer de cette démonstration à de longs calculs utiles exige de maîtriser les erreurs à chaque étape. C’est là que se joue la transformation d’une expérience de laboratoire en un ordinateur sur lequel on peut compter.
Les grandes dates de l’informatique quantique
| Date | Jalon |
|---|---|
| 1980 | Benioff décrit un modèle quantique de machine de Turing. |
| 1982 | Feynman publie sa proposition de simulation quantique. |
| 1985 | Deutsch formalise un modèle d’ordinateur quantique universel. |
| 1992–1994 | Deutsch–Jozsa puis Simon montrent que des algorithmes quantiques peuvent surpasser les méthodes classiques sur certains problèmes. |
| 1994 | Shor découvre son algorithme de factorisation. |
| 1995–1996 | Correction d’erreurs de Shor, architecture Cirac–Zoller et algorithme de Grover. |
| 1998–2001 | Petits algorithmes expérimentaux, puis factorisation de 15. |
| 2016 | IBM ouvre un processeur de cinq qubits au public via le cloud. |
| 2019 | Sycamore et le débat sur la « suprématie quantique ». |
| 2023 | Google montre qu’agrandir un code correcteur peut commencer à réduire le taux d’erreur logique. |
| 2024 | Standards post-quantiques du NIST et résultats de Willow sur la mémoire corrigée. |
| 2025 | Des expériences progressent vers des opérations universelles tolérantes aux fautes sur des qubits logiques. |
Sources
Les principales publications scientifiques et sources institutionnelles utilisées pour cet article sont les suivantes :
Fondements théoriques et algorithmes
- Paul Benioff, « The Computer as a Physical System: A Microscopic Quantum Mechanical Hamiltonian Model of Computers as Represented by Turing Machines », Journal of Statistical Physics, vol. 22, 1980, p. 563–591. DOI : 10.1007/BF01011339.
- Richard P. Feynman, « Simulating Physics with Computers », International Journal of Theoretical Physics, vol. 21, 1982, p. 467–488. DOI : 10.1007/BF02650179.
- David Deutsch, « Quantum Theory, the Church–Turing Principle and the Universal Quantum Computer », Proceedings of the Royal Society of London A, vol. 400, 1985, p. 97–117. DOI : 10.1098/rspa.1985.0070.
- David Deutsch et Richard Jozsa, « Rapid Solution of Problems by Quantum Computation », Proceedings of the Royal Society A, vol. 439, 1992, p. 553–558. DOI : 10.1098/rspa.1992.0167.
- Daniel R. Simon, « On the Power of Quantum Computation », 35th Annual Symposium on Foundations of Computer Science, 1994, p. 116–123. DOI : 10.1109/SFCS.1994.365701.
- Peter W. Shor, « Algorithms for Quantum Computation: Discrete Logarithms and Factoring », 35th Annual Symposium on Foundations of Computer Science, 1994, p. 124–134. DOI : 10.1109/SFCS.1994.365700.
- Peter W. Shor, « Scheme for Reducing Decoherence in Quantum Computer Memory », Physical Review A, vol. 52, 1995, R2493. DOI : 10.1103/PhysRevA.52.R2493.
- Ignacio Cirac et Peter Zoller, « Quantum Computations with Cold Trapped Ions », Physical Review Letters, vol. 74, 1995, p. 4091. DOI : 10.1103/PhysRevLett.74.4091.
- Lov K. Grover, « A Fast Quantum Mechanical Algorithm for Database Search », Proceedings of the 28th ACM Symposium on Theory of Computing, 1996, p. 212–219. DOI : 10.1145/237814.237866.